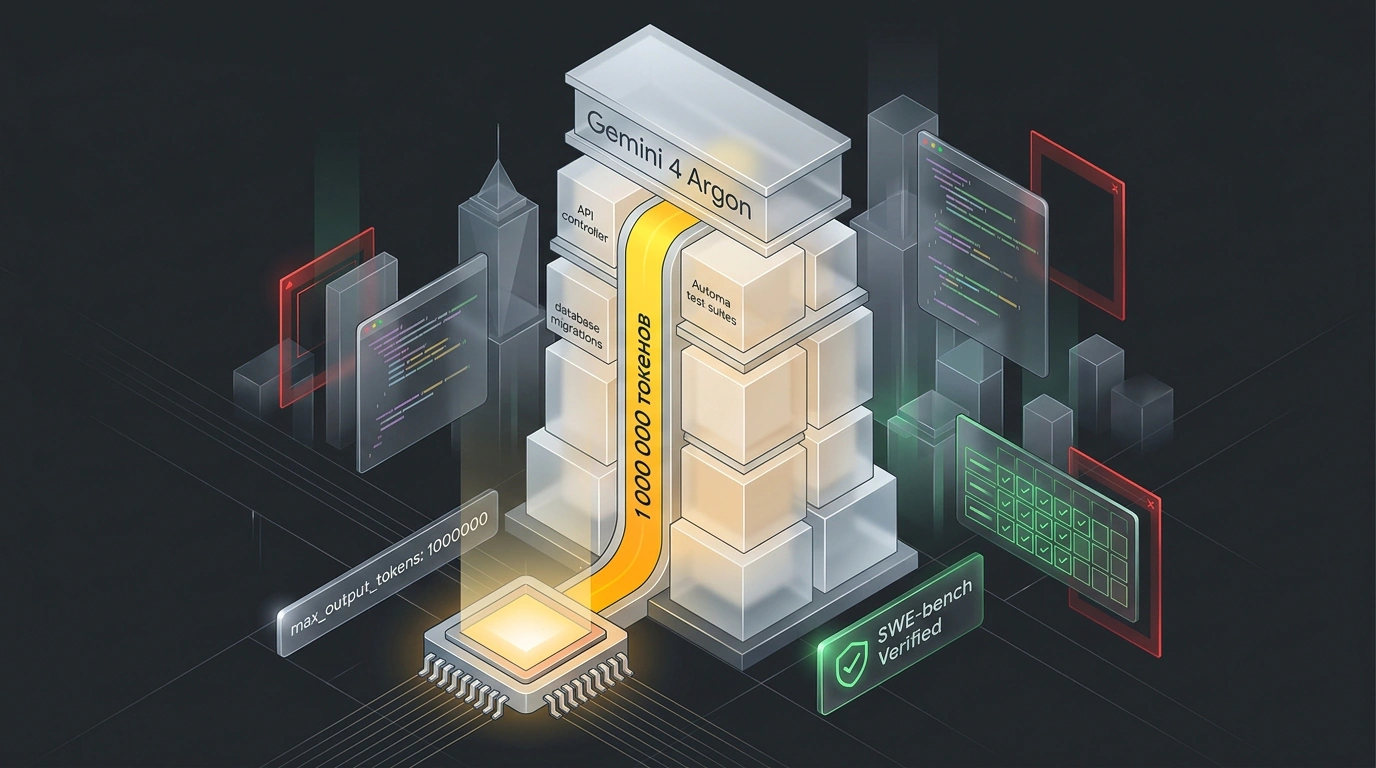
До сих пор работа с искусственным интеллектом в программировании напоминала попытку возвести здание через узкую щель для писем. Модели научились воспринимать колоссальные объемы данных — контекст в миллион токенов на вход стал привычным. Однако на выходе нейросети упирались в жесткий барьер: от четырех до шестидесяти четырех тысяч токенов. Разработчикам приходилось дробить задачи на десятки фрагментов, собирать код вручную и сталкиваться с тем, что к десятому файлу модель теряла архитектурные типы данных из первого.
Релиз мультимодальной модели Gemini 4 Argon от Google DeepMind меняет этот расклад. Ключевой прорыв — расширение выходного окна генерации до одного миллиона токенов в рамках единого непрерывного вызова API. Система способна за один запрос выдать законченную программную экосистему: интерфейсы, структуру монорепозитория, конфигурационные манифесты и сотни тестов.
Зачем модели выходной буфер размером в книжную полку
Миллион токенов — это порядка семисот тысяч слов или двух с половиной тысяч страниц технического текста. В программном выражении это полноценный сервис со всеми вспомогательными модулями, миграциями баз данных и подробной документацией.
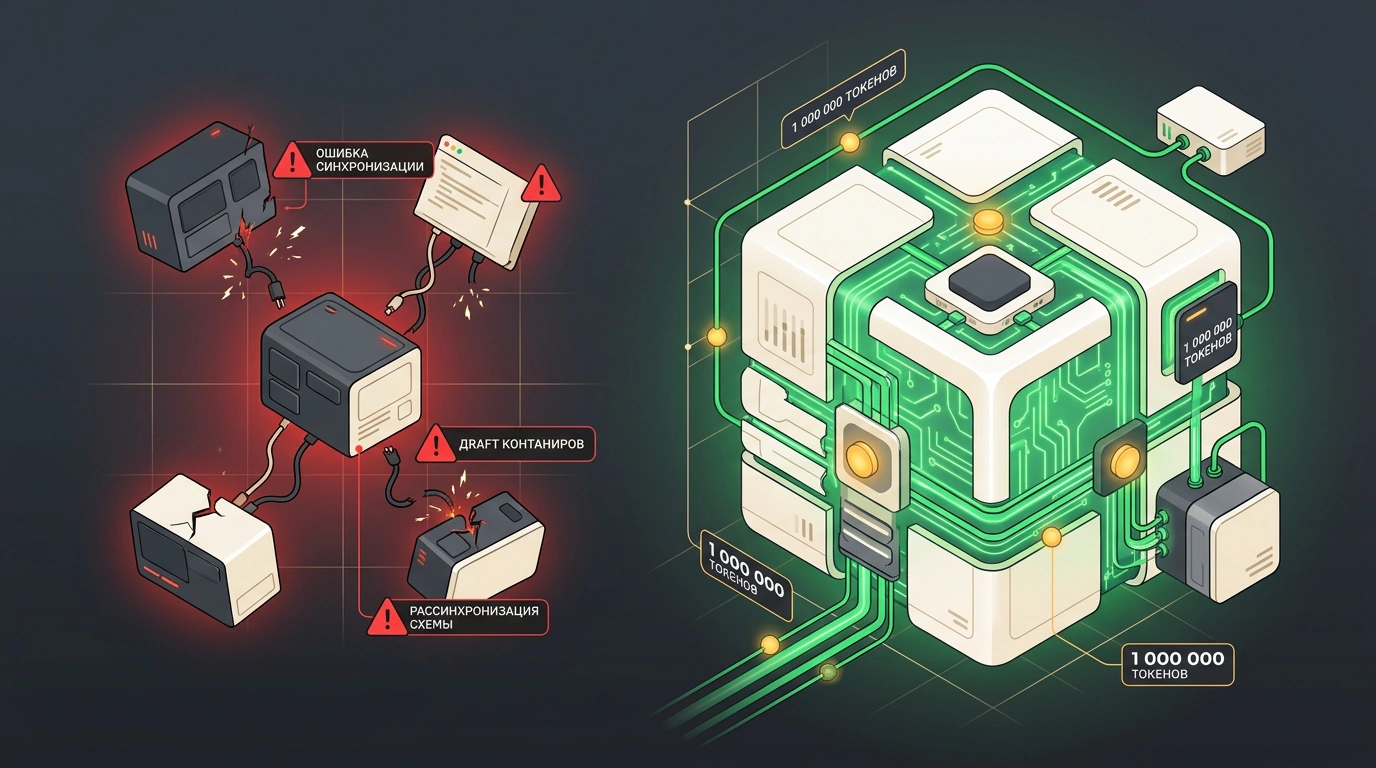
Раньше приходилось строить многоступенчатые цепочки агентов: один планирует структуру, второй генерирует заглушки, третий пишет логику функций. В таких пайплайнах неизбежно накапливались скрытые нестыковки. Если при генерации шестого модуля менялась базовая схема данных, первые пять файлов моментально ломались.
Выходное окно в миллион токенов устраняет архитектурную несогласованность. Модель удерживает единую логическую канву: объявленный в ядре инвариант безопасности гарантированно и единообразно применяется во всех периферийных контроллерах, утилитах и модульных тестах.
Испытания на полигонах SWE-bench и Terminal Bench
Argon прошел проверку на профильных бенчмарках, заняв первое место в 12 из 18 стандартных тестов и опередив конкурентов в задачах рассуждения и генерации кода.
Бенчмарк SWE-bench Verified моделирует реальные задачи инженера: системе передают репозитории с открытыми тикетами багов (GitHub Issues), требуя локализовать проблему, отредактировать код и пройти тесты без регрессий. Argon продемонстрировал способность самостоятельно находить сложные межмодульные конфликты зависимостей, требующие глубокого системного анализа.
В среде Terminal Bench модель проверялась на автономное выполнение bash-команд в Linux: построение конвейеров grep, sed и awk, управление правами доступа и подъем контейнеров в Docker. Тест зафиксировал минимальную долю синтаксических сбоев и корректное исполнение командных сценариев без зацикливаний.
Практический тест: переписывание тридцати тысяч строк легаси на Rust
Показательным стал внутренний кейс Google. Команда инженеров передала в Gemini 4 Argon устаревший микросервис объемом 32 000 строк кода на C++ и Python с задачей переписать его на Rust с соблюдением строгой типизации и модели владения памятью.
За одну генерационную сессию модель выдала готовую структуру крейта: перенесла бизнес-логику, настроила обработку ошибок через Result и Option, внедрила асинхронный рантайм Tokio и снабдила код интеграционными тестами. Семантика публичных интерфейсов осталась прозрачной, а устранение мелких предупреждений компилятора заняло считанные часы вместо недель ручной переработки.
Архитектура управления через Google GenAI SDK
Для взаимодействия с Gemini 4 Argon компания Google обновила официальный клиентский SDK, добавив параметры конфигурации расширенного выходного буфера. Ниже представлен прогрессивный сценарий: от базовой инициализации клиента и отправки пакетной задачи до потоковой обработки мегатокенного ответа в файл.
На первом этапе создается клиент и настраивается конфигурация генерации с явным выделением выходного окна в один миллион токенов и строгой системной инструкцией:
import os
from google import genai
from google.genai import types

# Инициализация официального клиента с системным токеном доступа
client = genai.Client(api_key=os.environ["GEMINI_API_KEY"])

# Конфигурация генерации с выделением буфера в 1 000 000 выходных токенов
config = types.GenerateContentConfig(
    max_output_tokens=1000000,
    temperature=0.2,
    system_instruction=(
        "Вы выступаете в роли ведущего системного архитектора. "
        "Спроектируйте законченную модульную систему биллинга, включая "
        "строго типизированные структуры данных, обработку ошибок, "
        "миграции баз данных PostgreSQL и интеграционные тесты."
    )
)

# Синхронный вызов для генерации архитектурного ядра
response = client.models.generate_content(
    model="gemini-4-argon",
    contents="Создайте спецификацию и программный каркас распределенного биллингового модуля.",
    config=config
)

print(f"Сгенерировано символов в ответе: {len(response.text)}")
Однако удерживать в оперативной памяти гигантский ответ целиком не всегда практично. Для непрерывной записи объемных кодовых баз на диск используется потоковый интерфейс (streaming). Это позволяет фиксировать код файл за файлом непосредственно по мере его поступления из нейросети:
# Потоковая запись сверхдлинного архитектурного ответа непосредственно на диск
response_stream = client.models.generate_content_stream(
    model="gemini-4-argon",
    contents="Сгенерируйте полную кодовую базу микросервиса с сопутствующими модулями и тестами.",
    config=config
)

output_filepath = "generated_project_bundle.md"
with open(output_filepath, "w", encoding="utf-8") as project_file:
    chunk_counter = 0
    for chunk in response_stream:
        if chunk.text:
            project_file.write(chunk.text)
            chunk_counter += 1
            if chunk_counter % 50 == 0:
                print(f"Записано {chunk_counter} фрагментов потока данных на диск...")

print(f"Генерация завершена. Полный проект сохранен в файл: {output_filepath}")
Обратная сторона мегавывода: задержка первого токена и экономика вычислений
Колоссальные возможности генерации требуют трезвого понимания аппаратных компромиссов. Инференс модели такого масштаба опирается на специализированные вычислительные кластеры ускорителей Google TPU v5p и TPU v6e. Поддержание гигантского KV-кэша для генерации длинных последовательностей создает два ключевых фактора трения: задержку старта и экономическую стоимость.
Первый фактор — задержка выдачи первого токена (Time to First Token, TTFT). Перед тем как начать печать первого символа ответа при сверхдлинных запросах, система выполняет глубокое планирование и первичное вычисление графа внимания. В зависимости от объема входного контекста и глубины задачи задержка первого токена может составлять от 15 до 45 секунд. Это исключает применение Argon в привычных синхронных веб-чатах или диалоговых подсказках редактора кода (autocomplete), где пользователь ждет мгновенной реакции в пределах пары сотен миллисекунд.
Второй аспект — устойчивость контекстного внимания. Хотя бенчмарки фиксируют высокую связность текста, на дистанциях свыше полумиллиона токенов возрастает риск возникновения локальных тавтологий или незаметного дрейфа стилистики оформления кода. Инженерам по-прежнему необходим автоматизированный контроль качества: статический анализ, компиляция и запуск автотестов остаются обязательными фильтрами перед отправкой сгенерированного кода в репозиторий.
Инженерный вердикт: кому и когда необходим Gemini 4 Argon
Gemini 4 Argon — это не замена повседневным легковесным ассистентам вроде Claude Sonnet или Gemini Flash, а специализированный тяжелый инструмент для пакетных архитектурных трансформаций. Модель распространяется в режиме закрытого предварительного доступа Google Fairwind для отобранных enterprise-клиентов с последующей интеграцией в облачные платформы Vertex AI и Google AI Studio.
Применять Argon целесообразно там, где цена ошибки рассинхронизации модулей превышает затраты на ожидание: при глобальных миграциях с одного стека технологий на другой, при первичном прототипировании комплексных распределенных систем и при аудите гигантских монорепозиториев. Для рутинного автодополнения строк и локальных правок по-прежнему эффективнее использовать компактные модели, но для масштабных инженерных сдвигов стандарт генерации в один миллион токенов открывает принципиально новую эру.