
Когда в руках разработчика оказывается мощный генеративный инструмент вроде GPT-4o или Claude Sonnet, любая задача в коде начинает казаться гвоздем для генерации текста. Нужно распределить входящие обращения клиентов по отделам? Отправляем промпт с требованием вернуть JSON. Нужно проверить, подтвердил ли пользователь оплату? Снова шлем промпт. В реальных агентных системах на подобную рутинную классификацию и маршрутизацию уходит до 70% всех API-вызовов.
Но за универсальность приходится платить огромную цену. Генеративная модель тратит десятки миллисекунд на авторегрессионное порождение каждого токена, страдает от случайных синтаксических ошибок в скобках JSON и, главное, маскирует степень собственной уверенности за уверенным тоном ответов. Стартап Nace.AI предложил альтернативный путь и выложил в открытый доступ 8-миллиардную модель Drex 1.1, спроектированную исключительно для принятия решений в один прямой проход через нейросеть.
Парадокс генеративного молотка: почему классификация через чат-ботов ломает пайплайны
Использование тяжелых языковых моделей в качестве маршрутизаторов создает в продакшене два узких горлышка:
- Задержка первого токена и накладные расходы декодирования: чтобы вернуть тривиальное слово
billing, полноразмерная LLM должна сформировать контекст, запустить механизм внимания и посимвольно выдать текстовую строку. В нагруженных сервисах с тысячами запросов в минуту эта задержка накапливается как снежный ком. - Иллюзия уверенности вместо калиброванной математики: если модель сомневается между двумя вариантами с вероятностями 51% и 49%, в сгенерированном тексте разработчик увидит лишь категоричный выбор первого варианта. В финансовых и медицинских сценариях отсутствие численного доверительного интервала лишает систему возможности передать сомнительный случай живому оператору.
Бестокеновый инференс: как устроен механизм прямых указателей
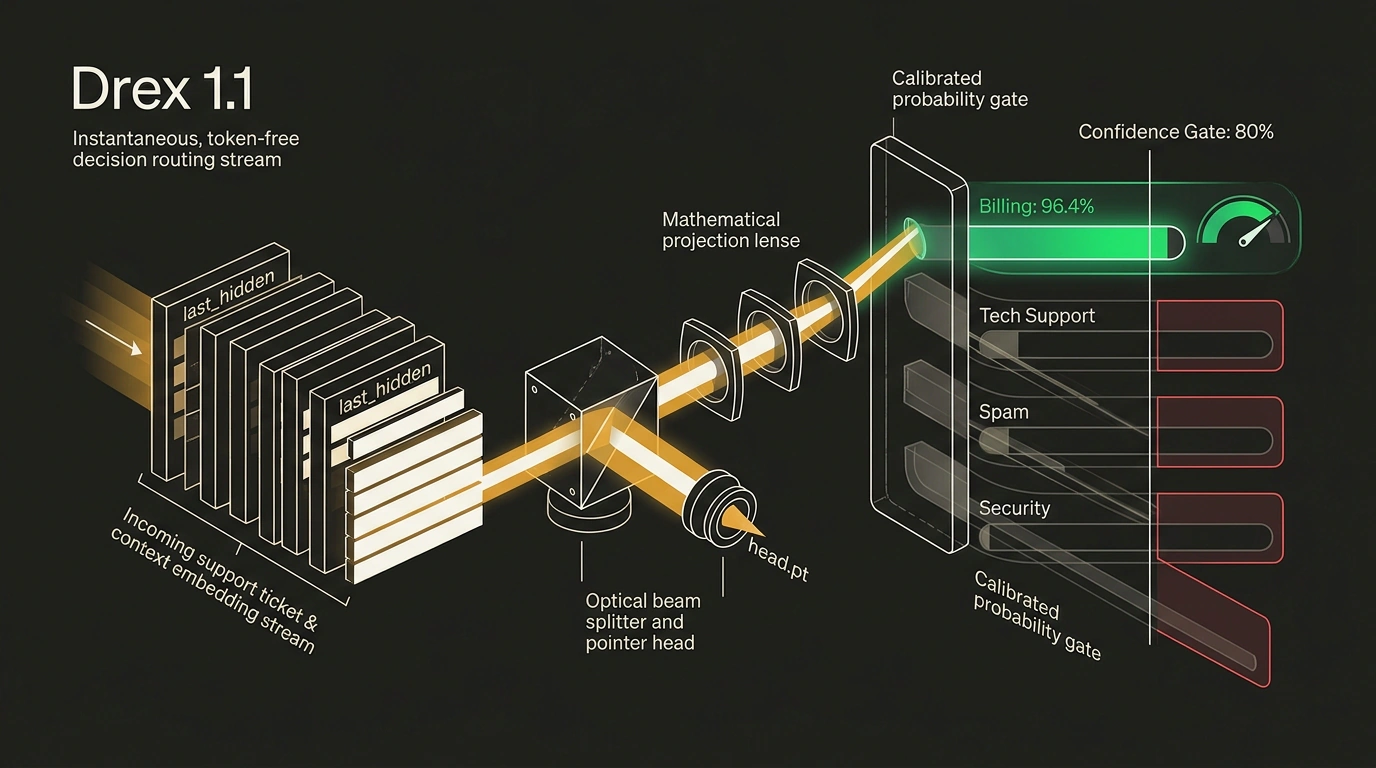
Архитектура Drex 1.1 кардинально отличается от классических чат-ботов. В ее основе лежит языковой бэкбон на 8 миллиардов параметров (дистиллированный на базе архитектур Qwen и Llama), однако стандартный блок декодирования токенов заменен на специализированную голову указателей (pointer head, файл head.pt).
Вместо того чтобы генерировать токены один за другим, модель берет эмбеддинги скрытого состояния последнего слоя и проецирует их напрямую на векторное пространство заданных категорий выбора. Математическое распределение softmax вычисляется в один прямой проход (forward pass). В результате модель выдает не текст, а строгий массив вероятностей для каждого варианта, укладывающийся в доли миллисекунды.
Интеграция в код: от базовой загрузки весов к калиброванному роутеру
Модель поддерживает инференс через стандартную экосистему Hugging Face Transformers и фреймворк PyTorch. Для демонстрации работы разберем прогрессивный сценарий: сначала подготовим базовый класс загрузки весов и контекста, а затем расширим его логикой взвешенной маршрутизации с жестким порогом уверенности.
На первом этапе инициализируем токенизатор, загружаем веса в половинной точности bfloat16 и формируем представление входного запроса:
import torch
from transformers import AutoTokenizer, AutoModelForCausalLM

class DrexClassifierBase:
    """Базовый загрузчик архитектуры Drex 1.1 с извлечением скрытых состояний."""
    def __init__(self, model_id: str = "nace-ai/drex-1.1-8b"):
        self.tokenizer = AutoTokenizer.from_pretrained(model_id)
        self.model = AutoModelForCausalLM.from_pretrained(
            model_id,
            torch_dtype=torch.bfloat16,
            device_map="auto"
        )
        self.model.eval()

    def encode_context(self, context_text: str, question: str, options: list[str]):
        prompt = f"State: {context_text}\nQuestion: {question}\nOptions: {', '.join(options)}"
        return self.tokenizer(prompt, return_tensors="pt").to(self.model.device)
Теперь расширим базовый класс методом принятия решений route_with_confidence_gate. Он вычисляет логиты схожести скрытого состояния с кандидатами, нормализует их через softmax и проверяет, превышает ли максимальная вероятность заданный порог надежности:
class DrexProductionRouter(DrexClassifierBase):
    """Маршрутизатор с фильтрацией по порогу уверенности (confidence threshold)."""
    @torch.no_grad()
    def route_with_confidence_gate(
        self,
        ticket_text: str,
        categories: list[str],
        min_confidence: float = 80.0
    ) -> dict:
        inputs = self.encode_context(
            context_text=ticket_text,
            question="Which department must resolve this issue?",
            options=categories
        )

        # Прямой проход без авторегрессионного цикла генерации
        outputs = self.model(**inputs, output_hidden_states=True)
        last_hidden = outputs.hidden_states[-1][:, -1, :]  # форма [1, hidden_dim]

        # Проекция на пространство эмбеддингов категорий через указатели
        option_tokens = self.tokenizer(categories, add_special_tokens=False, return_tensors="pt").to(self.model.device)
        option_embeds = self.model.get_input_embeddings()(option_tokens.input_ids).mean(dim=1)

        logits = torch.matmul(last_hidden, option_embeds.T).squeeze(0)
        probabilities = (torch.softmax(logits, dim=-1) * 100).tolist()
        results = {cat: round(prob, 2) for cat, prob in zip(categories, probabilities)}

        best_category = max(results, key=results.get)
        best_prob = results[best_category]

        # Эскалация человеку, если уверенность модели ниже порога
        requires_human = best_prob < min_confidence
        return {
            "probabilities": results,
            "selected_route": best_category if not requires_human else "HUMAN_OPERATOR",
            "escalated": requires_human
        }

if __name__ == "__main__":
    router = DrexProductionRouter()
    decision = router.route_with_confidence_gate(
        ticket_text="С моей карты списали двойную сумму за подписку. Требую возврат средств.",
        categories=["Billing", "Technical Support", "Spam", "Account Security"],
        min_confidence=85.0
    )
    print("Результат решения:", decision)
    # Вывод: {'probabilities': {'Billing': 96.41, 'Technical Support': 0.1, ...}, 'selected_route': 'Billing', 'escalated': False}
Три режима в одном проходе: категории, бинарные флаги и шкалы
Drex 1.1 поддерживает три параллельных режима оценки, которые могут выполняться на одном общем представлении контекста без повторного прогона нейросети:
- Choice Mode (Категориальный выбор): нахождение наиболее подходящей сущности из произвольного списка классов с нормировкой суммарной вероятности к 100%.
- Null Mode (Бинарная верификация): строгая оценка истинности утверждения («Требуется ли вмешательство инженера дежурной смены? Да: 85.48%, Нет: 14.52%»).
- Score Mode (Ординарная оценка): ранжирование по непрерывной шкале критичности или срочности (например, приоритизация инцидента на уровне
59.45% urgent).
Модель аппаратно валидирована на чипах Apple Silicon (включая чипы семейства M5 Max со 128 ГБ объединенной памяти) и поставляется в квантованном формате Q8_0 GGUF, что позволяет запускать инференс прямо на рабочих ноутбуках без серверных стоек с GPU.
Границы применимости: когда Drex незаменим, а где лучше оставить эмбеддинги
Несмотря на впечатляющую скорость, специализированная модель решений не является универсальной серебряной пулей:
- Когда Drex идеален: сложные контексты до 32 768 токенов, где простой поиск по косинусному сходству векторных эмбеддингов бессилен. Если выбор категории зависит от скрытых юридических условий, предыстории диалога или тонких нюансов политики сервиса, 8B-параметрический контекстный анализатор Drex превосходит классические энкодеры BERT.
- Когда лучше выбрать более простые инструменты: если ваша задача сводится к тривиальному поиску по 50 статическим ключевым словам в справочнике FAQ, классический кросс-энкодер или регулярные выражения справятся быстрее и не потребуют 16 ГБ оперативной памяти.
- Лицензионный нюанс: исходный код проекта открыт под MIT, однако веса модели распространяются под некоммерческой лицензией CC-BY-NC-4.0. Для масштабного закрытого промышленного применения потребуется согласование лицензии с Nace.AI.
Вынесение логики ветвления из генеративных диалогов в калиброванные модели решений — естественный этап взросления ИИ-индустрии: сложные тексты должны писать писатели, а стрелки на рельсах переключать специализированные стрелочники.