
Ты наверняка замечал, как меняется твоё поведение в сети: вместо ввода короткого запроса в поисковую строку и кликов по десяти рекламным ссылкам ты всё чаще идёшь в ChatGPT Search, Perplexity или смотришь блок AI Overviews. Ты формулируешь развёрнутый вопрос живым языком и ждёшь готовый синтезированный ответ с конкретными рекомендациями.
Но что происходит под капотом? Почему одни проекты нейросеть рекомендует в первых строках, а о существовании других даже не знает, хотя у них закуплены тысячи ссылок? Давай разберём внутренние шестерёнки генеративного поиска.
Смерть классического SERP и рождение веерных запросов
В традиционном поиске всё было линейно: поисковый робот брал ключевик, искал совпадения по индексу, взвешивал авторитетность домена и выкатывал список ссылок. Твоя задача сводилась к попаданию в заветный топ-3.
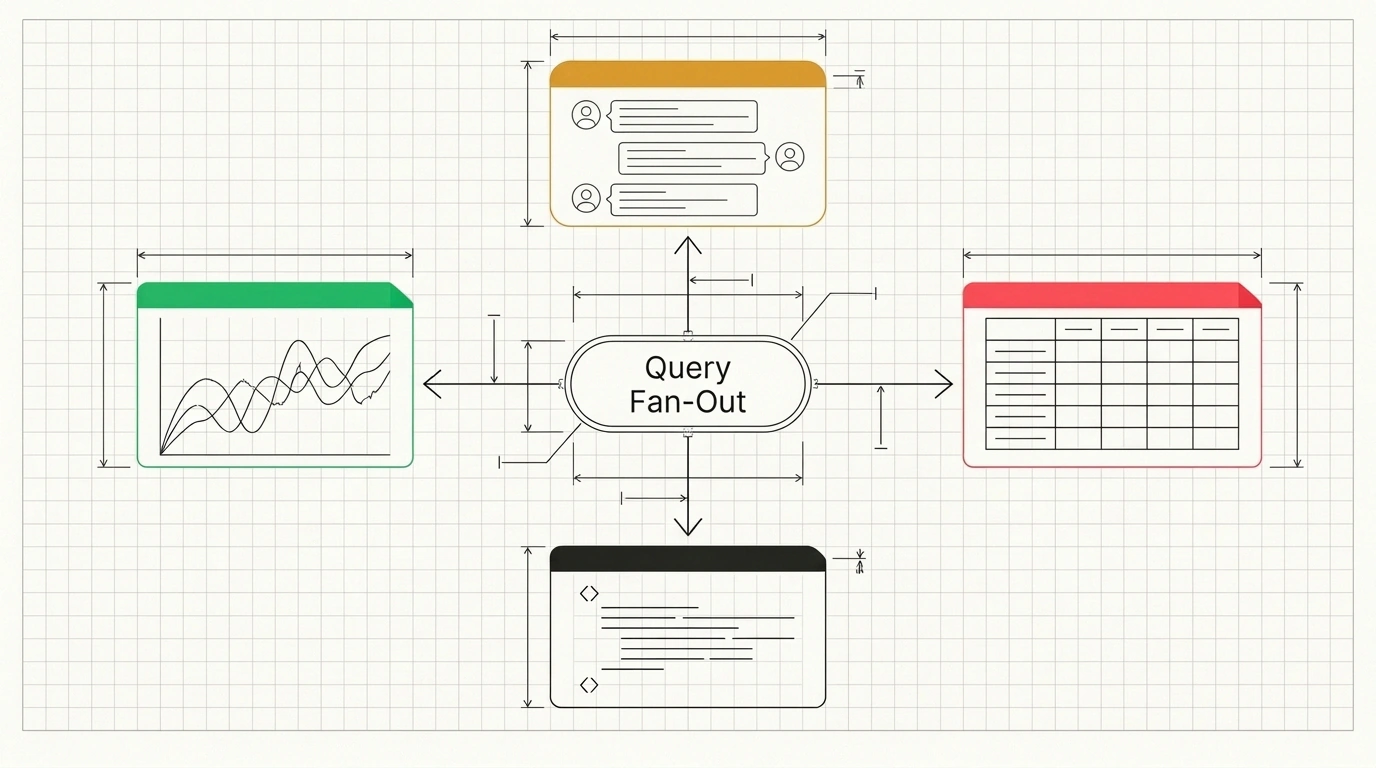
В эпоху больших языковых моделей поисковик действует иначе. Когда ты задаёшь сложный вопрос (например, «какой легковесный агентный харнес выбрать для Python на Linux»), модель запускает механику веерных запросов (Query Fan-Out).
Движок декомпозирует твою мысль на 3–7 параллельных подзапросов:
- Бенчмарки производительности агентных библиотек;
- Свежие ветки обсуждений на Reddit и GitHub за последний квартал;
- Документация конкретных открытых репозиториев;
- Сравнительные таблицы совместимости.
Собрав десятки сырых страниц, нейросеть действует как аналитик-референт: вычитывает тексты, отсекает рекламный шум, сопоставляет факты и генерирует связный ответ. Ссылки при этом становятся подтверждающими сносками (Entity Citations).
Двухконтурная модель: разделение GEO и AEO
В индустрии закрепилось разделение двух дисциплин: GEO (Generative Engine Optimization) и AEO (Answer Engine Optimization). Это не синонимы, а два этапа воронки:
- Фаза извлечения (Retrieval Pass / GEO). Поисковый агент решает, попадут ли страницы твоего ресурса в контекст модели. Здесь важна техническая доступность сайта для ботов (GPTBot, PerplexityBot) и семантическая ясность текста.
- Фаза генерации (Generation Pass / AEO). Страницы уже в памяти модели, и алгоритм выбирает, кого процитировать в тексте ответа, а кого отбросить как информационный мусор.
Фундаментальное исследование Принстонского университета, Georgia Tech и Allen Institute for AI (препринт arXiv:2311.09735, бенчмарк GEO-bench) показало: стандартный SEO-копирайтинг не работает в генеративных движках.
Зато решающую роль играют три фактора:
- Точные фактологические данные и статистика: упоминание замеров задержек, бенчмарков и системных требований повышает шанс цитирования на до 40%.
- Прямые авторитетные цитаты экспертов: модель считывает прямую речь создателей как знак высокой достоверности.
- Структурированные матрицы сравнения: таблицы параметров «характеристика / вариант А / вариант Б» идеально обрабатываются механизмом внимания (Attention).
Ранее мы уже разбирали новые правила поисковой оптимизации и почему алгоритмы любят живой опыт практиков, а для ритейла критически важны структурированные каталожные фиды, помогающие моделям мгновенно считывать цены и остатки.
Как писать для нейросетей: три правила
- Давай чёткий ответ в первом же абзаце. Не заставляй модель продираться сквозь водянистые вступления. Главную пользу формулируй сразу под заголовком.
- Публикуй конфигурации и точные цифры. Команды терминала, JSON-конфиги и логи замеров — это твёрдая фактура, на которую алгоритмы ссылаются в первую очередь.
- Участвуй в профильных сообществах. Поисковые агенты активно сканируют форумы и обсуждения. Если о твоём продукте говорят специалисты, нейросеть будет цитировать его наравне с гигантами.