
Если ты хоть раз пробовал запускать автономного агента для кодинга на большой кодовой базе, то наверняка знаешь главную боль этой затеи. Флагманские закрытые модели вроде Claude Opus или тяжелых версий GPT пишут код основательно, но делают это неторопливо и сжигают баланс API со скоростью спорткара на форсаже. Стоит запустить цикл автоматического поиска багов на пару сотен файлов — и дневной лимит испаряется. С другой стороны, легкие модели обычно грешат синтаксическими ошибками, путают типы данных и застревают в циклических галлюцинациях.
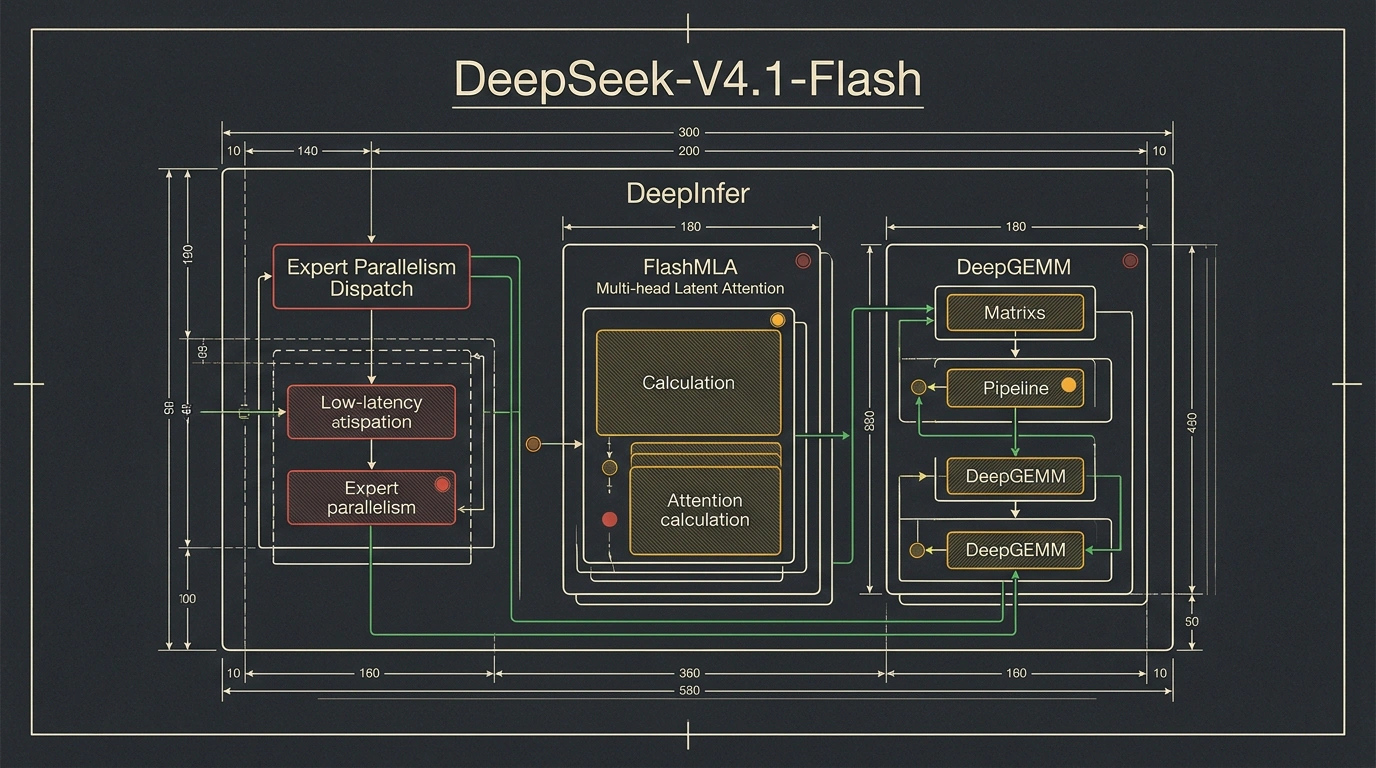
Китайская исследовательская команда DeepSeek совершила ход конем, который заставил вздрогнуть индустрию. 17 октября 2026 года они выкатили чекпоинт DeepSeek-V4.1-Flash-1017, а следом открыли исходный код своего боевого инференс-движка DeepInfer под лицензией Apache 2.0. Получилась гремучая смесь: легковесная модель архитектуры MoE (Mixture of Experts), оптимизированная под парадигму «wish-driven programming», в связке с низкоуровневым сервером инференса, выжимающим максимум из аппаратного обеспечения.
Почему Flash 1017 обходит флагманы в тестах SWE
Давай разберем механику: почему компактная модель вдруг показывает результаты лучше громоздких закрытых систем? В бенчмарках автоматического исправления ошибок в коде (SWE-bench и Mini-SWE) тяжелые модели часто страдают от «синдрома отличника». Они тратят десятки тысяч токенов на внутренние рассуждения, философствуют об архитектурных компромиссах и пытаются переписать половину смежных модулей вместо того, чтобы точечно поправить две строчки в уязвимой функции.
Чекпоинт Flash 1017 натренирован с жестким штрафом за избыточную болтовню. Он действует как опытный ночной дежурный инженер: быстро локализует сбойный стек-трейс, проверяет граничные условия и генерирует минимальный, синтаксически выверенный дифф. В контрольных замерах эта модель собирает рабочие веб-сервисы за минуты, расходуя копейки на фоне конкурентов. Ранее мы уже наблюдали этот тренд в материале DeepSeek V4.1 Flash 1017: ускоренная сборка приложений и сравнение стоимости с Claude Opus, но теперь к программному чекпоинту добавился фундаментальный инфраструктурный кирпич.
Архитектура DeepInfer: как устроен движок изнутри
До сих пор стандартом де-факто для локального хостинга открытых сетей оставался vLLM или TensorRT-LLM. Штуки мощные, но универсальные, а значит — несущие на себе груз компромиссов. DeepSeek поступила иначе: они опубликовали в репозитории deepseek-ai/DeepInfer тот самый код, на котором крутится их собственный публичный API.
Главная проблема при параллельной обработке тысяч запросов к моделям смеси экспертов (MoE) — фрагментация видеопамяти и узкое горлышко передачи данных между GPU. DeepInfer решает это за счет комплекса низкоуровневых библиотек:
- FlashMLA: кастомные ядра для вычисления Multi-Head Latent Attention с радикально сниженным потреблением памяти под матрицы ключей и значений;
- DeepGEMM и DeepEP: высокоскоростные матричные умножения и протокол распределения экспертов (Expert Parallelism), гарантирующий минимальные задержки при обмене весами между чипами по шине NVLink;
- TileLang и TileKernels: специализированный язык компиляции вычислительных плиток, ориентированный на архитектуру тензорных ядер.
Движок получил нативную оптимизацию под новейшие серверные ускорители NVIDIA поколения Blackwell SM100 (B200 и серверные стойки GB200), а также под китайские процессоры Huawei Ascend 950. Для разработчиков терминальных инструментов это открывает колоссальные возможности — мы уже разбирали автономную среду в статье Экосистема OpenCode 2.0: открытый агент для терминала и интеграция быстрых моделей, а с DeepInfer локальный инференс выходит на промышленную мощность.
Вот как выглядит запуск генерации через Python API движка DeepInfer с явным указанием параллелизма экспертов:
import deepinfer
from deepinfer import EngineConfig, MoEParallelConfig

# Конфигурация распределенного инференса для Flash 1017
config = EngineConfig(
    model_path="deepseek-ai/DeepSeek-V4.1-Flash-1017",
    tensor_parallel_size=4,
    moe_parallel_config=MoEParallelConfig(
        expert_parallel_size=8,
        load_balancer="EPLB",          # Динамическая балансировка нагрузки на экспертов
        enable_flash_mla=True
    ),
    kv_cache_dtype="fp8_e5m2",         # Квантование KV-кэша в 8-битный формат
    max_batch_size=128
)

engine = deepinfer.InferenceEngine(config)

# Генерация со строгим грамматическим контролем
output = engine.generate(
    "Напиши lock-free очередь на C++20 с использованием std::atomic",
    temperature=0.2,
    structured_grammar="json_schema"
)
print(output.text)
В DeepInfer встроен механизм DSpark, использующий адаптивное доверительное планирование для спекулятивной генерации токенов. При этом движок гарантирует побитово идентичный результат генерации при фиксированном seed на железе NVIDIA, что критически важно при проведении регрессионного тестирования кода.
Подводные камни и границы применения
Прежде чем ты кинешься разворачивать DeepInfer на рабочем сервере, нужно трезво понимать текущий статус проекта. Это в первую очередь инструмент для офлайн-пакетирования и высоконагруженных очередей.
В текущем релизе отсутствует готовый встроенный HTTP-демон с поддержкой спецификации OpenAI API (/v1/chat/completions). Чтобы прикрутить движок к веб-сервису, придется писать собственную обвязку на FastAPI/Rust или использовать библиотеку deepseek-recipe. Кроме того, настройка распределенного MoE на нескольких узлах требует поддержки высокоскоростной сети RDMA/InfiniBand — на обычных гигабитных сетевых картах обмен данными между экспертами станет узким горлышком.
Тем не менее публикация исходников DeepInfer — знаковое событие осени 2026 года. Монополия закрытых лабораторий на эффективную инфраструктуру окончательно рухнула: теперь любой стартап или независимый инженер может развернуть производительный стек кодинга на собственном оборудовании.