
Давай на секунду заглянем в твои регулярные банковские списания. Двадцать долларов за ChatGPT Plus, еще двадцать за подписку на Claude, пара десятков за ассистента в редакторе кода, плюс оплата облачных токенов по API... К концу года незаметно набегает от 700 до 1000 долларов. И ладно бы дело было только в деньгах: корпоративные чаты регулярно падают в часы пиковых нагрузок, серверы вводят драконовские лимиты на количество сообщений в три часа, а отправлять в облако конфиденциальный код клиентского проекта или базу персональных данных — прямой путь к головной боли с безопасностью.
Дэвид Ондржей провел фундаментальное практическое исследование, наглядно показав, что осенью 2026 года наступил переломный момент. Открытые веса семейств Qwen 2.5, Llama 3.2 и Mistral в компактных квантованиях достигли того уровня зрелости, когда они способны закрыть 95% повседневных задач программиста, редактора и аналитика прямо на твоем домашнем компьютере.
Железо и квантование: сколько памяти нужно на самом деле
Главный миф, отпугивающий людей от локального ИИ: «Для этого нужна ферма серверов за миллионы рублей». Давай снимем розовые очки и посчитаем сухие цифры.
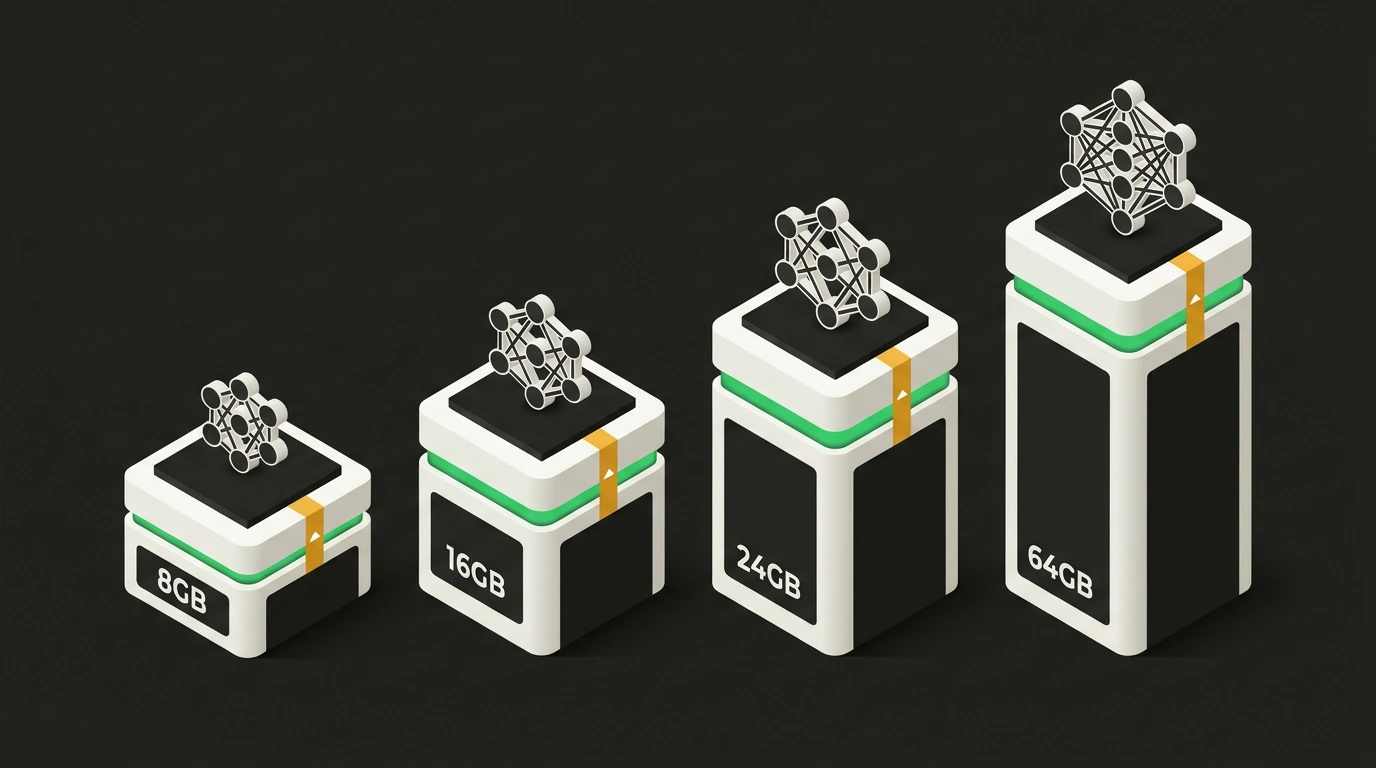
Современные открытые модели распространяются в формате квантования GGUF (библиотека llama.cpp). Квантование — это математическое сжатие весов нейросети из 16-битных чисел с плавающей точкой в 4-битные или 8-битные целые числа. Потеря качества на практических задачах составляет доли процента, а вот требования к памяти падают в три-четыре раза.
Вот реальная раскладка по потребительскому оборудованию:
- 12 ГБ VRAM (доступные видеокарты NVIDIA GeForce RTX 3060 или 4070): комфортный запуск моделей класса 7B–14B параметров в квантовании
Q4_K_M. Этого с головой хватает для молниеносного рерайтинга, поиска по локальным документам и генерации типовых скриптов; - 16–24 ГБ VRAM (RTX 4080 / RTX 4090): запуск моделей 14B–32B параметров (например, флагманского
Qwen 2.5 Coder 14B/32B). Это уровень, практически неотличимый по качеству от коммерческих подписок в задачах веб-разработки; - Apple Silicon (M2/M3/M4 с 32–64 ГБ Unified Memory): идеальный вариант для работы с большими контекстами. Поскольку видеоядро Mac использует общую оперативную память, ты можешь загрузить модель на 32B или даже 70B без покупки двух отдельных видеокарт.
Как объединять такие локальные узлы в распределенные агентные сети, я подробно разбирал в материале Локальный рой ИИ-агентов на ПК: оркестрация с помощью Paperclip, Hermes и MiniMax M3.
Пошаговый запуск: от терминала к кастомному профилю
В качестве базового инструмента мы будем использовать утилиту Ollama. Она берет на себя всю черную работу: управление процессами, распределение слоев модели между видеокартой и оперативной памятью и поднятие локального HTTP-сервера.
1. Установка и запуск окружения
В среде Linux или Windows WSL2 установка выполняется одной командой:
# Загрузка и установка бинарного файла Ollama
curl -fsSL https://ollama.com/install.sh | sh

# Запуск фонового демона
systemctl --user start ollama
2. Загрузка кодовой модели
Скачаем специализированную модель для разработки Qwen 2.5 Coder 14B в сбалансированном квантовании:
ollama run qwen2.5-coder:14b-instruct-q4_K_M
Команда автоматически скачает образ весом около 9 ГБ и откроет диалоговую строку прямо в консоли.
3. Тонкая настройка через Modelfile
Стандартные настройки Ollama по умолчанию выделяют под контекст всего 2048 токенов. Для программирования этого мало: пара длинных файлов с кодом мгновенно вытеснят системные инструкции. Мы создадим собственный профиль с расширенным контекстным окном и четкой ролью.
Создай текстовый файл Modelfile:
FROM qwen2.5-coder:14b-instruct-q4_K_M

# Расширяем контекстное окно до 16k токенов
PARAMETER num_ctx 16384

# Температура для детерминированного и точного синтаксиса
PARAMETER temperature 0.2
PARAMETER top_p 0.9
PARAMETER repeat_penalty 1.1

# Вшиваем неизменяемый системный промпт
SYSTEM '''
Ты опытный ведущий инженер-программист. Отвечай кратко, пиши идиоматичный и чистый код с комментариями только по неочевидной логике, соблюдай строгую типизацию.
'''
Теперь соберем собственный именованный образ:
ollama create my-senior-coder -f ./Modelfile
4. Проверка утилизации железа
Запусти созданный образ и проверь, как он разместился в VRAM:
ollama run my-senior-coder "Напиши асинхронную функцию на Python для парсинга sitemap.xml"
В соседней вкладке терминала введи диагностическую команду:
ollama ps
Утилита покажет имя запущенной модели, размер занимаемой памяти и процент слоев, выгруженных в VRAM (в идеале должно быть 100% GPU).
Подключение к скриптам и пользовательским интерфейсам
Ollama автоматически поднимает локальный сервер на порту 11434. Ты можешь обращаться к нему из любого своего скрипта без API-ключей и платы за токены:
import requests

url = "http://localhost:11434/api/generate"
payload = {
    "model": "my-senior-coder",
    "prompt": "Как сконфигурировать CORS в FastAPI?",
    "stream": False
}

response = requests.post(url, json=payload).json()
print(response["response"])
Для тех, кто предпочитает красивый веб-интерфейс в духе ChatGPT, достаточно в одну строчку через Docker поднять Open WebUI:
docker run -d -p 3000:8080 --add-host=host.docker.internal:host-gateway -v open-webui:/app/backend/data --name open-webui --restart always ghcr.io/open-webui/open-webui:main
Открываешь в браузере http://localhost:3000 — и получаешь полноценный рабочий кабинет с историей чатов, загрузкой PDF-файлов и голосовым вводом.
Все скачанные модели хранятся локально в директории ~/.ollama/models. Ты можешь отключить Wi-Fi, сесть в поезд или самолет и продолжать писать код с помощью полноценного ИИ-ассистента, не завися от качества связи и роуминговых тарифов.
Если на твоем компьютере нет дискретной видеокарты NVIDIA или процессора Apple Silicon, модель будет работать исключительно на центральном процессоре (CPU). Для сеток размером 14B скорость упадет до 2–4 токенов в секунду. В этом случае лучше ограничиться легкими моделями класса 3B–7B (Qwen 2.5 3B или Llama 3.2 3B).
Собственный локальный стек возвращает ощущение полного контроля над своими инструментами. Никаких внезапных блокировок аккаунтов, никаких соглашений о передаче данных третьим лицам — только твое железо и чистая вычислительная мощность.