
Каждый, кто пробовал применить искусственный интеллект к реальной кодовой базе enterprise-уровня, неизбежно набивал одну и ту же шишку. Ты берешь legacy-проект на сотню тысяч строк кода, пытаешься натравить на него ассистента... и быстро понимаешь, что модель задыхается. Тебе приходится резать репозиторий на кусочки, скармливать файлы по отдельности, мучительно склеивать промежуточные ответы и постоянно напоминать алгоритму, о чем вообще шла речь три шага назад.
В итоге система теряет контекст: при переписывании авторизации она напрочь забывает, как устроены middleware в соседнем каталоге, придумывает несуществующие методы и оставляет после себя ворох сломанных интеграционных тестов. Этот феномен в инженерной среде называют «дрейфом цели» (Goal Drift). Когда диалог растягивается на десятки итераций, нейросеть начинает жить собственной жизнью, оптимизируя локальный участок кода в ущерб общей стабильности системы.
Google выкатила тяжелую артиллерию: специализированную флагманскую модель рассуждений Gemini 4 Argon (gemini-4-argon). Ее создавали с единственной прикладной целью — дать инженерам возможность за один заход проглотить целый программный комплекс и выдать законченный результат рефакторинга без судорожного деления на микропорции.
Унифицированный миллион токенов: вход, рассуждения и длинный вывод
В чем главное технологическое отличие Argon от всего, что мы видели раньше? В большинстве существующих нейросетей действует негласное ограничение: контекстное окно на вход может быть большим, но на выход (output tokens) разработчикам жестко выделяют 4096 или 8192 токена. Этого едва хватает на пару экранных форм или небольшой скрипт. Сгенерировать полноценный пакет микросервисов со всеми тестами, миграциями баз данных и Docker-манифестами за один запрос было физически невозможно.
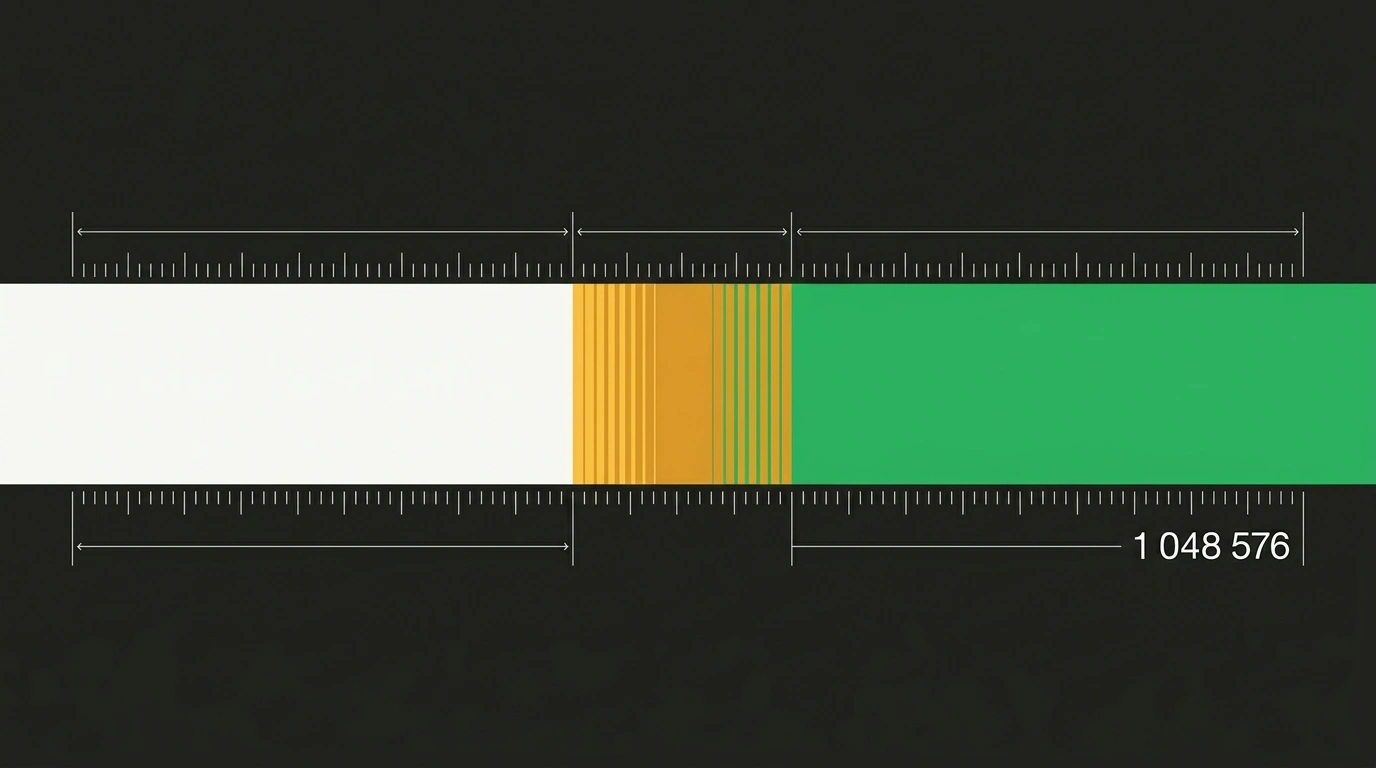
В Gemini 4 Argon контекстный пул на 1 048 576 токенов сделан полностью динамическим и сквозным:
- Ты можешь загрузить 300 000 токенов исходного кода монолита вместе с логами ошибок, схемой базы данных и историей коммитов git;
- Модель выделит 50 000 токенов на внутреннее архитектурное планирование (thinking budget);
- А оставшиеся 650 000 токенов потратит на генерацию законченной кодовой базы без единого разрыва сессии.
На бенчмарке Needle In A Haystack («иголка в стоге сена»), где случайный факт прячется в произвольной точке миллионного контекста, Argon показал ошеломляющие 99.8% точности. Модель не теряет фокус внимания даже на предельной длине входящего потока. Практические замеры этой функциональности мы уже освещали в материале Возможности Google Gemini 4 Argon: вывод до 1 миллиона токенов и генерация бизнес-инструментов.
Архитектура модели специально оптимизирована под мультимодальные инженерные входные данные. Ты можешь прикрепить к дампу репозитория архитектурную схему в формате PDF, скриншоты интерфейса и аудиозапись совещания команды с обсуждением требований к рефакторингу. Система свяжет воедино визуальные блоки диаграммы, звуковые комментарии лида разработки и существующие строки кода на Си или Go.
Управление рассуждениями через Google GenAI SDK
Для работы с Argon в Google AI Studio и Vertex AI представлен обновленный SDK. Разработчик получает возможность явно управлять глубиной погружения модели через параметр бюджета мышления (thinking_budget или уровни low, medium, high).
Вот как выглядит вызов аудита безопасности и генерации плана миграции монолита на Python:
from google import genai
from google.genai import types

client = genai.Client()

# Конфигурация с выделенным бюджетом на системное проектирование
config = types.GenerateContentConfig(
    temperature=0.1,
    thinking_config=types.ThinkingConfig(
        thinking_budget=16384  # Выделяем 16k токенов на архитектурный анализ
    ),
    system_instruction="Ты главный системный архитектор. Проведи аудит кодовой базы и спроектируй переход на gRPC."
)

# Загрузка полного дампа кодовой базы монолита
with open("legacy_repository_dump.txt", "r", encoding="utf-8") as f:
    repo_content = f.read()

response = client.models.generate_content(
    model="gemini-4-argon",
    contents=[
        repo_content,
        "Сформируй спецификации proto-файлов и сервисный слой для модуля биллинга."
    ],
    config=config
)

print("Результат проектирования:")
print(response.text)
В таком режиме модель сначала досконально проверяет все внутренние вызовы функций, выявляет циклические зависимости и только затем приступает к формированию чистого кода. Реальные примеры автономной генерации интерфейсов на этом движке разобраны в статье Gemini 4 Argon на практике: автономная генерация сложных веб-приложений и длинный контекстный декод.
Реальные сценарии и границы применимости
Где модель проявляет себя лучше всего? Прежде всего — в тяжелых сценариях аудита безопасности и поиска скрытых состояний гонки (race conditions) в многопоточном коде. Когда проекту двадцать лет, ни один живой программист в компании уже не помнит, почему в модуле сетевого обмена стоит странная задержка на 50 миллисекунд. Argon способен проследить цепочку вызовов сквозь десятки файлов и объяснить первопричину архитектурного компромисса.
Второй сценарий — генерация комплексных сквозных тестов (End-to-End). Модель видит бэкенд, структуру таблиц PostgreSQL и пользовательский интерфейс одновременно. Это позволяет ей создавать тестовые сценарии на Playwright, которые проверяют весь путь транзакции от клика по кнопке в браузере до изменения баланса в защищенном хранилище.
Третий сценарий — обратная разработка устаревших протоколов. Если у тебя есть дампы бинарного сетевого трафика и разрозненные заголовочные файлы тридцатилетней давности, Argon восстанавливает логику кодирования пакетов и генерирует современный парсер на Rust за один рабочий проход.
Обработка миллионного контекста с нуля при каждом запросе влетает в копеечку. В продакшен-пайплайнах критически важно активировать функцию Context Caching в Google Cloud Vertex AI. Единожды закешированный репозиторий хранится на серверах Google, а последующие обращения к нему тарифицируются со скидкой до 75%.
Будь готов к тому, что при подаче более 500 000 входных токенов время до генерации первого ответа (Time To First Token) может составить от 15 до 35 секунд. Это не зависание сервера, а фаза загрузки тяжелых матриц внимания и внутреннего планирования. Не ставь короткие таймауты в HTTP-клиентах.
Gemini 4 Argon наглядно доказывает: время моделей, умеющих работать лишь с короткими сниппетами, уходит в прошлое. Будущее ИИ-инженерии — за системами, способными удерживать архитектуру масштаба корпорации целиком.