

Если ты пробовал генерировать с помощью ИИ что-то сложнее короткого скрипта или поста для блога, то наверняка упирался в жесткий потолок. Во входной промпт можно загрузить хоть всю документацию библиотеки, но на выходе модель выдает скромные 4000 или 8000 токенов и обрывает фразу на полуслове.
Чтобы получить полноценный проект, инженерам приходилось городить сложные конструкции: генерировать файлы по частям, сохранять промежуточные результаты в буфер и склеивать код внешними скриптами. Стоило модели ошибиться в сигнатуре метода в третьем файле — и вся связка рассыпалась.
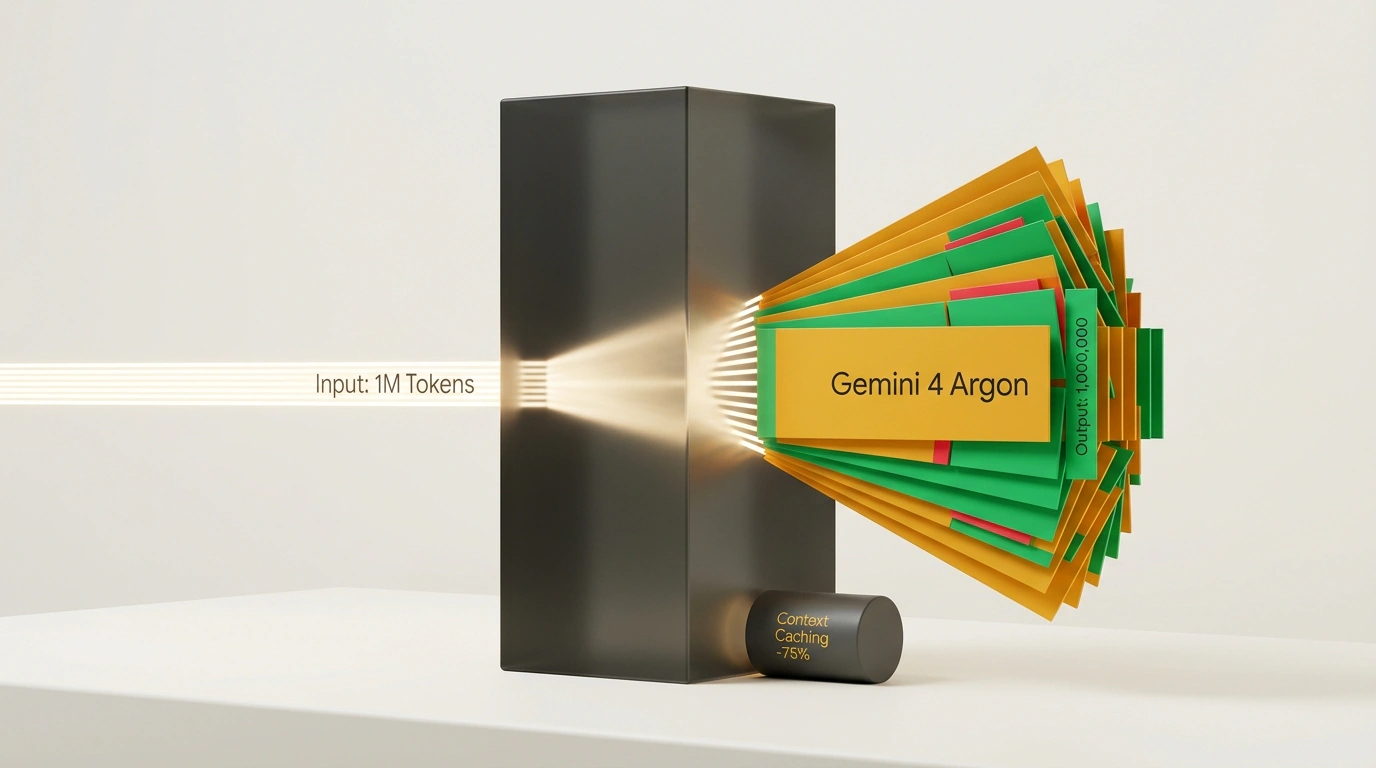
Выход модели Google Gemini 4 Argon в среде Google AI Studio переворачивает эту парадигму с ног на голову. Разработчики сняли привычный барьер асимметрии: модель способна сгенерировать до 1 000 000 токенов вывода за один-единственный запрос. Это примерно 750 000 слов или объем нескольких увесистых томов технической документации.
Давай посмотрим, что эта возможность меняет на практике и как использовать ее для создания прикладных бизнес-инструментов без лишних расходов.
Конец эпохи «склейки контекста»: что дает симметричный вывод
Когда мы изучали мультимодальные модели и масштабирование контекста, речь шла в основном о чтении гигантских объемов информации. Gemini 4 Argon делает этот процесс двусторонним.
Теперь за один промпт можно получить:
- законченную кодовую базу микросервиса: схему базы данных, миграции Alembic, эндпоинты FastAPI, юнит-тесты и дашборд на React;
- детальный сравнительный аудит нескольких конкурирующих продуктовых линеек с сотнями таблиц и сквозным анализом рисков;
- интерактивные бизнес-калькуляторы и специализированные дашборды (подход, который популяризирует предприниматель Грег Изенберг для быстрой сборки нишевых SaaS).
Ты формулируешь техзадание целиком, и модель выдает согласованный артефакт, где модули ссылаются на переменные и классы, определенные в том же ответе.
Запрос к API и управление длинной генерацией
Для работы со сверхдлинным выводом используется официальный SDK google-genai. При конфигурации запроса задается параметр max_output_tokens, а также настраивается бюджет скрытых размышлений (thinking_budget):
import os
from google import genai
from google.genai import types

client = genai.Client(api_key=os.environ["GEMINI_API_KEY"])

# Запрос на генерацию масштабного проекта
response = client.models.generate_content(
    model="gemini-4-argon",
    contents="Generate a complete multi-tenant SaaS architecture boilerplate with FastAPI, SQLModel, Alembic and unit tests.",
    config=types.GenerateContentConfig(
        max_output_tokens=1000000,
        temperature=0.2,
        thinking_config=types.ThinkingConfig(thinking_budget=4096),
    )
)

print(f"Generated text length: {len(response.text)} characters")
print(f"Total tokens used: {response.usage_metadata.total_token_count}")
Генерация сотен тысяч токенов требует времени — ответ может формироваться несколько минут. Обязательно настраивай длинные таймауты HTTP-клиента и используй потоковую передачу данных (generate_content_stream), чтобы отслеживать прогресс в реальном времени.
Механизм Context Caching: экономия бюджета на 75%
При повторной отправке тяжелой спецификации баланс API быстро растает. Здесь выручает Context Caching, о котором мы говорили, разбирая архитектуру длинного контекста.
Ты загружаешь базу знаний в кэш Google AI Studio один раз, задаешь время жизни (TTL), а затем делаешь десятки быстрых запросов к закэшированному контексту со скидкой в 75%:
from google.genai import types

# Создаем кэш для массивной спецификации или кодовой базы
cache = client.caches.create(
    model="gemini-4-argon",
    config=types.CreateCachedContentConfig(
        contents=[
            types.Content(
                role="user",
                parts=[types.Part.from_text(large_codebase_text)]
            )
        ],
        ttl="3600s", # Кэш живет 1 час
    )
)

# Выполняем точечный запрос со ссылкой на кэш
cached_response = client.models.generate_content(
    model="gemini-4-argon",
    contents="Refactor the authentication module to support OAuth2 with PKCE.",
    config=types.GenerateContentConfig(
        cached_content=cache.name,
        max_output_tokens=65536
    )
)
Используй Gemini 4 Argon для быстрого прототипирования: передай модели CSV-файл с отраслевыми данными и попроси сгенерировать готовый Single Page Application на чистом HTML/JS с фильтрацией и графиками. Ты получишь рабочий микропродукт без долгой ручной разработки.
Главный вывод
Выход Gemini 4 Argon стирает искусственные рамки объема генерации. Возможность выдать до миллиона токенов в сочетании с кэшированием контекста превращает языковую модель из текстового советчика в мощный генератор законченных программных комплексов и аналитических архивов.