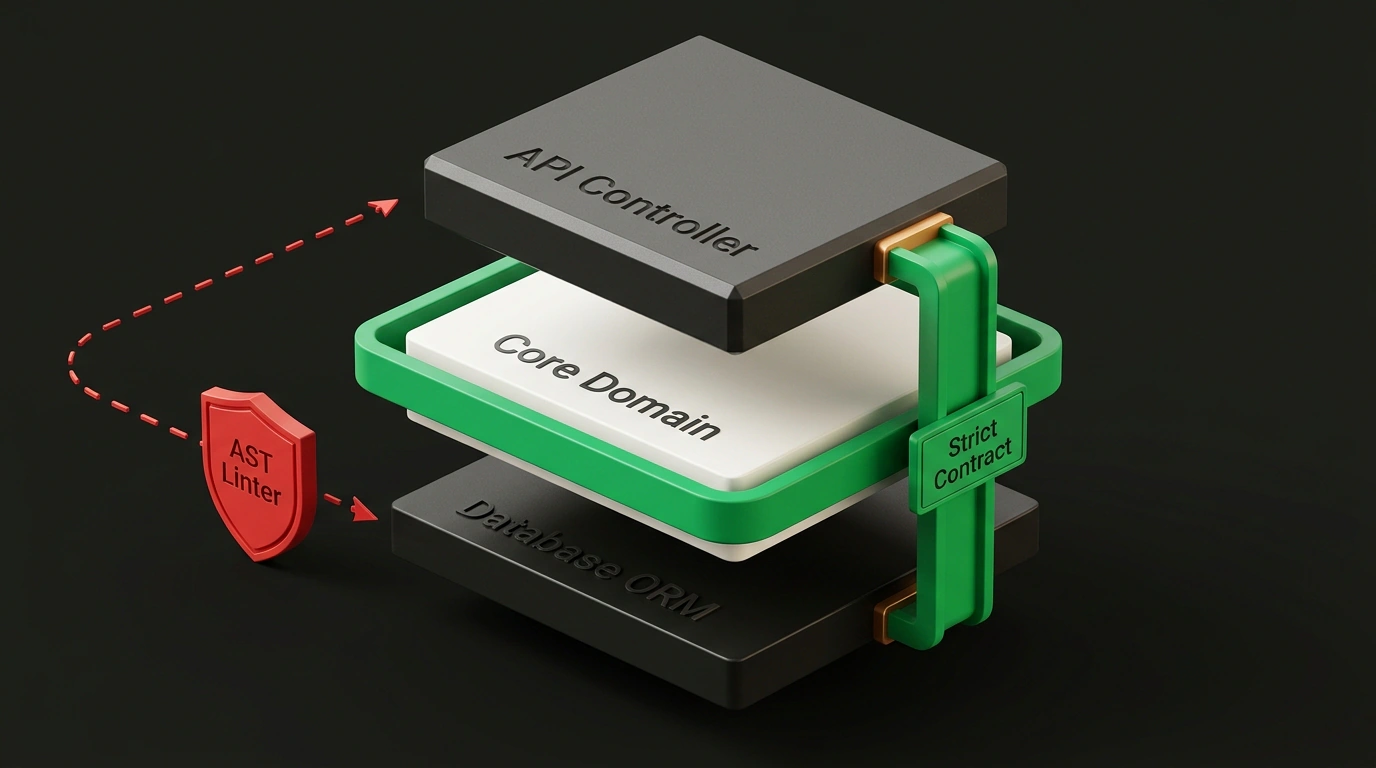

Каждый разработчик, распробовавший работу с современными кодинг-ассистентами (Cursor, Claude Code, GitHub Copilot), переживает период бурного энтузиазма. Скорость набора кода взлетает в разы: за вечер можно набросать сервис, на который раньше уходила неделя. Модель услужливо генерирует типизированные схемы, раскладывает валидаторы и пишет зеленые юнит-тесты.
Но что происходит с такой кодовой базой через 6–12 месяцев интенсивной жизни проекта?
Системный архитектор Тимур Шемсединов (основатель экосистемы Metarhia, преподаватель КПИ) опубликовал обстоятельную видеолекцию, посвященную незаметной, но смертельной угрозе: архитектурной эрозии под воздействием больших языковых моделей (LLM). Этот анализ перекликается с нашими наблюдениями в материале Архитектурная эрозия: почему вайб-кодинг разрушает долгоживущие системы.
Локальная оптимизация против глобального графа
Фундаментальная причина, по которой нейросети систематически разрушают архитектуру программных систем, кроется в математической природе генеративных моделей.
Большая языковая модель оптимизирует правдоподобие следующего токена в пределах локального окна контекста. Когда ты просишь ее «добавить метод оформления заказа в контроллер», модель не видит проект целиком как строгий граф абстракций. Ей нужно решить задачу максимально быстро и компактно прямо сейчас.
Что делает модель?
- Она берет сущность базы данных из ORM и напрямую возвращает ее в HTTP-ответ веб-сервера, намертво связывая схему хранения с контрактом клиентского API;
- Ради удобства она импортирует вспомогательную функцию из соседнего модуля, создавая скрытую циклическую зависимость, о которой компилятор даже не предупредит;
- Если бизнес-правило требует проверки скидки, модель генерирует формулу прямо по месту вызова, дублируя логику домена в транспортном слое.
Локально всё работает и тесты проходят. Но глобально слои системы начинают слипаться в монолитный «ком грязи». Через полгода стоимость добавления новой функциональности вырастает в разы, а случайное изменение одного поля в базе данных ломает половину сервисов приложения.
Почему текстовые промпты больше не работают
Многие команды пытаются спасти положение «правилами для ИИ»: пишут гигантские манифесты CLAUDE.md, настраивают системные инструкции и файлы конфигурации редакторов.
Тимур Шемсединов убедительно объясняет, почему этот путь обречен на провал: естественный язык слишком двусмысленен. Модель легко «срезает углы» и игнорирует декларативные пожелания ради генерации работающего фрагмента кода. Единственный надежный рубеж обороны — это машиночитаемые формальные контракты и автоматический статический аудит:
- Строгая изоляция слоев: чистое ядро доменной логики (Core Domain) вообще не должно иметь внешних зависимостей. Оно не знает ни про базы данных, ни про протоколы HTTP/gRPC.
- AST-валидаторы в CI/CD: архитектурные линтеры (такие как
dependency-cruiserили решения на базе AST-анализа, развиваемые в Metarhia) обязаны аппаратно блокировать любые запрещенные импорты на этапе пулл-реквеста. Если модуль инфраструктуры попытался проникнуть в домен — билд падает. - Формальные интерфейсы вместо текстовых договоренностей: контракты обмена должны описываться строгими схемами (TypeBox, Protobuf или протоколами Metacom) с независимым семантическим версионированием по SemVer.
Нейросеть — превосходный исполнитель для рутинного кодирования, но она принципиально не способна удерживать архитектурные инварианты системы. Архитектура остается исключительной ответственностью человека, а контроль над ней должен быть передан беспристрастным статическим анализаторам.
Лекция Тимура Шемсединова — обязательный материал для каждого лида, планирующего внедрение AI в команде.