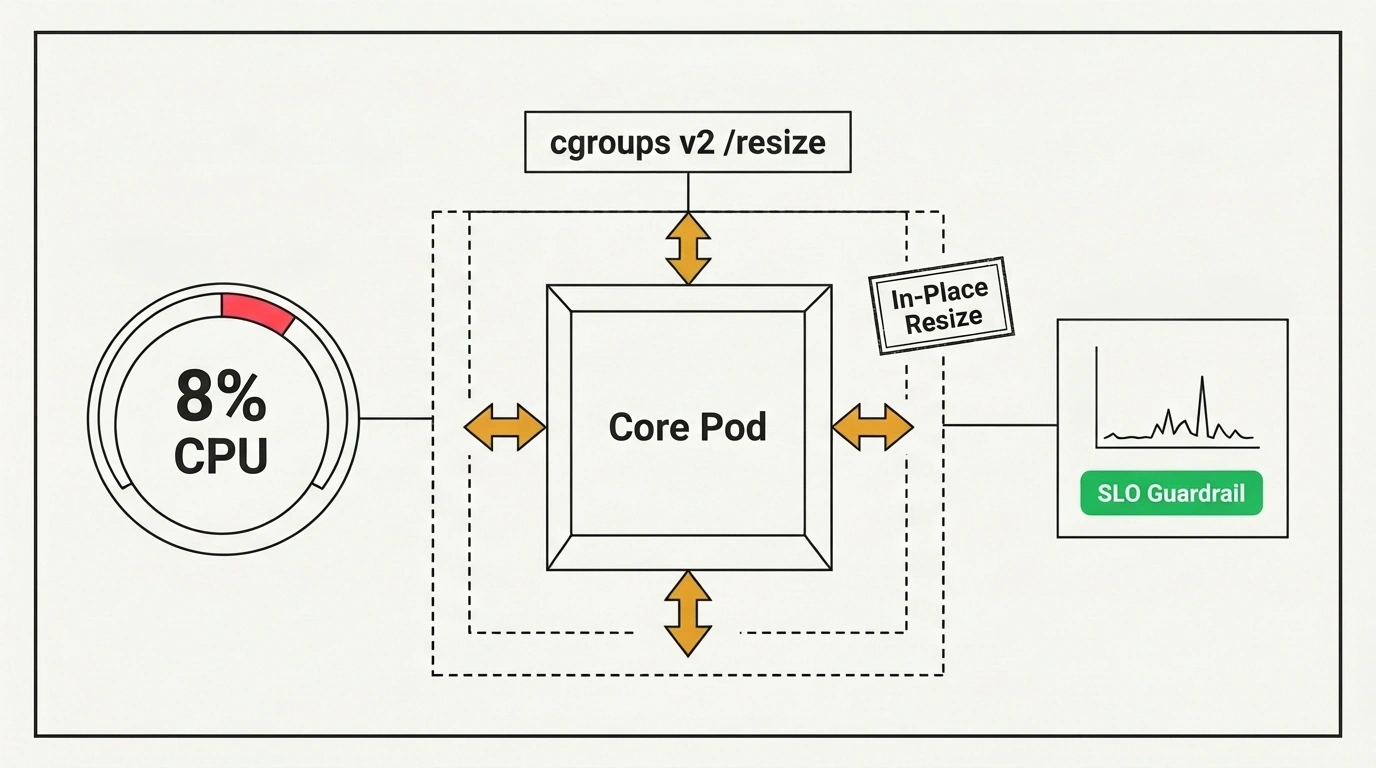

Каждый инфраструктурный инженер регулярно сталкивается с парадоксом сайзинга ресурсов в Kubernetes. Разработчики перестраховываются и заказывают сервису 4 ядра CPU и 8 ГБ оперативной памяти, хотя в 99% времени сервис потребляет от силы 300 миллисекунд процессорного времени. В отчете CAST AI за 2026 год зафиксирована пугающая цифра: реальная средняя утилизация CPU в кластерах составляет всего 8%, а оверпровижининг называют главной черной дырой для бюджетов свыше 70% компаний.
Казалось бы, решение давно придумано — используйте Vertical Pod Autoscaler (VPA). Но в реальном продакшене VPA включают менее 1% команд. Причина проста: чтобы изменить requests и limits контейнера, классический VPA обязан принудительно убить под и создать его заново. В нагруженных сервисах с миллионами веб-сокетов или долгими сессиями такой «автоскейлинг» превращается в непрерывный каскадный сбой.
Появление открытого оператора Attune (лицензия Apache-2.0) решает эту фундаментальную проблему, опираясь на революционную возможность Kubernetes 1.35 — статус General Availability (GA) для механизма In-Place Pod Resize.
Как работает сайзинг без простоев
Attune исключает эвикты из процесса оптимизации. Вместо пересоздания подов оператор обращается к сабресурсу /resize в K8s API. Движок контейнеризации (containerd 2.0+ или CRI-O) перенастраивает контрольные группы cgroups v2 на уровне ядра Linux буквально за доли миллисекунды: границы CPU и памяти расширяются или сужаются прямо на лету, а приложение внутри контейнера даже не замечает изменений.
Разработчики Attune построили вокруг этого низкоуровневого примитива безопасный контур автоматизации:
- Канареечное применение (Canary fraction): оператор никогда не накатывает новые параметры на весь deployment сразу. Сначала изменения получают 10–25% реплик.
- Барьеры SLO через PromQL (Guardrails): оператор непрерывно опрашивает Prometheus или VictoriaMetrics. Если после урезания CPU у канареечных подов подскочила задержка p99 или вырос процент ошибок 5xx, Attune моментально отменяет операцию и возвращает исходные лимиты. Ранее похожие подходы исследовал оператор Ballast: оператор автоматического подбора лимитов в Kubernetes на основе метрик Prometheus.
- Дружба с HPA: в отличие от стандартного VPA, который конфликтует с Horizontal Pod Autoscaler, Attune плавно корректирует базовые requests, позволяя горизонтальному скейлеру корректно реагировать на всплески трафика.
Устанавливается оператор стандартно через Helm:
helm repo add attune https://charts.attune.io
helm repo update
helm install attune attune/attune --namespace attune-system --create-namespace
Конфигурация политики AttunePolicy описывает целевой deployment, границы ресурсов и условия защитного отката:
apiVersion: autoscaling.attune.io/v1alpha1
kind: AttunePolicy
metadata:
  name: api-service-sizing
  namespace: production
spec:
  targetRef:
    apiVersion: apps/v1
    kind: Deployment
    name: core-api
  mode: "InPlace"
  canary:
    fraction: 0.20
    evaluationPeriod: "5m"
  sloGuardrail:
    promql: "sum(rate(http_requests_total{status=~'5..'}[2m])) / sum(rate(http_requests_total[2m])) > 0.01"
    revertOnBreach: true
  limits:
    cpu:
      min: "200m"
      max: "4000m"
    memory:
      min: "512Mi"
      max: "8Gi"
Для приложений с тяжелой фазой инициализации (компиляция JIT в Java или прогрев модулей в Node.js) Attune поддерживает режим Startup Boost: контейнеру временно выделяется избыточный пул CPU на старте, а после завершения прогрева лимиты плавно сбрасываются до оптимальных рабочих значений.
С выходом Kubernetes 1.35 и появлением оператора Attune эпоха статических манифестов с раздутыми в пять раз квотами наконец-то уходит в прошлое.