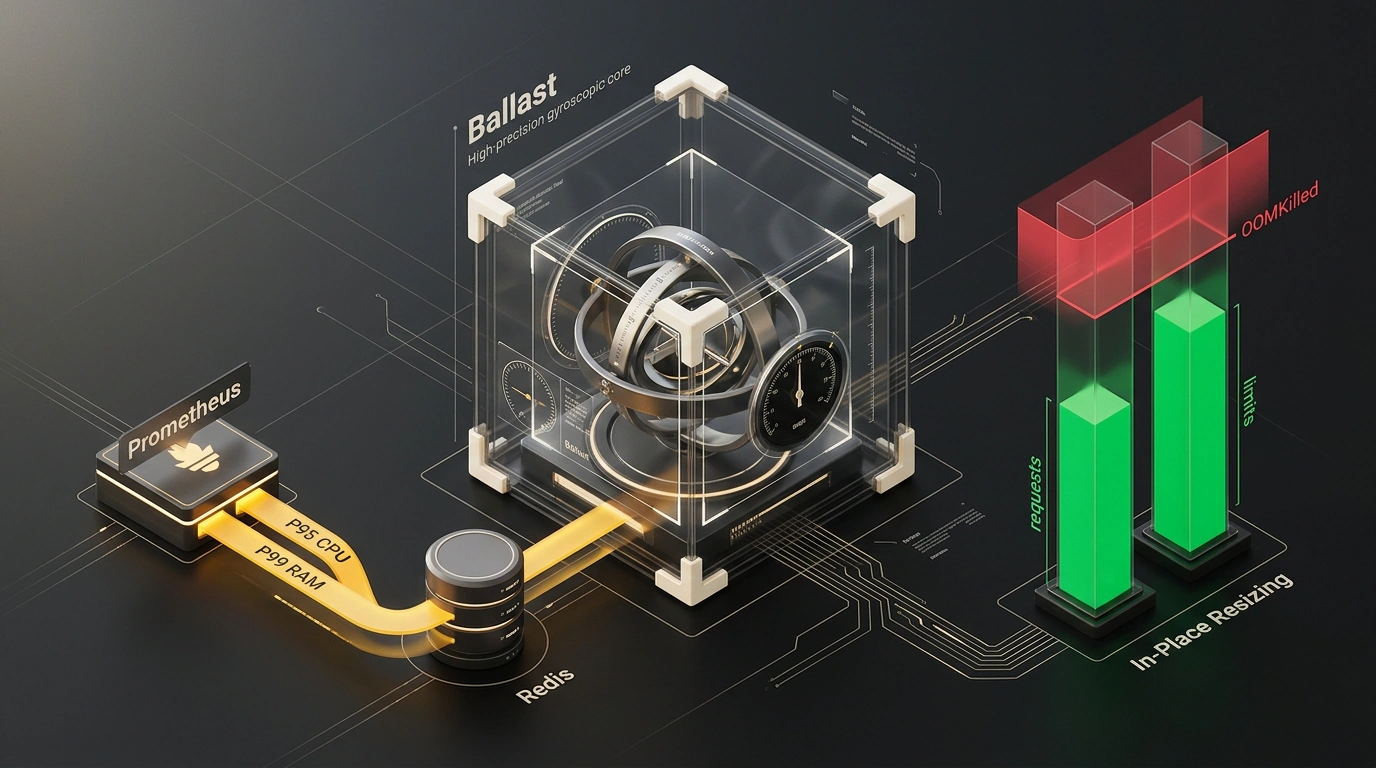

В эксплуатации любого кластера Kubernetes есть негласный закон подлости: ресурсы, выделенные контейнерам, никогда не соответствуют их реальным потребностям. Инженеры-разработчики, опасаясь ночных дежурств и внезапных аварий, завышают запросы по памяти и процессору в пять-десять раз. В результате облачный счет компании растет как на дрожжах, а планировщик Kube-scheduler отказывается размещать новые сервисы на полупустых узлах. Но стоит платформенной команде волевым решением урезать аппетиты приложений, как первый же пятничный всплеск трафика отправляет поды в нокаут с ошибкой OOMKilled.
Чтобы разорвать этот замкнутый круг, инженеры финтех-компании Block (создатели Cash App и Square) опубликовали в открытом доступе проект Ballast. Это специализированный Kubernetes-оператор, который непрерывно анализирует исторические метрики в Prometheus и автоматически подбирает идеальные значения requests и limits для каждого контейнера, используя современные возможности бесшовного изменения ресурсов без перезапуска процессов.
Ловушка статических лимитов: переплаты за воздух против падений OOMKilled
В основе распределения мощностей в Kubernetes лежат две базовые концепции: requests (гарантированный резерв, по которому планировщик выбирает узел) и limits (жесткий потолок, при превышении которого контейнер троттлится по CPU или принудительно уничтожается ядром Linux по памяти). На практике ручной подбор этих чисел вручную превращается в бесконечную угадайку.
Если команда выставляет запросы с избыточным запасом, кластер страдает от проблемы «призрачной утилизации» (resource fragmentation). Физические процессоры серверов простаивают с реальной нагрузкой в 10–15%, но для оркестратора узел забит под завязку, поскольку сумма requests забронировала всю доступную емкость. Компания платит облачному провайдеру за терабайты «воздуха».
Обратная крайность еще опаснее. Заниженный лимит памяти при обработке тяжелого аналитического отчета или импорта файлов приводит к мгновенной активации системного механизма OOM Killer: операционная система без предупреждения убивает рабочий процесс с кодом завершения 137. Сервис уходит в CrashLoopBackOff, а клиенты получают ошибки 502 и 504.
Почему классический Vertical Pod Autoscaler ломает продакшен
Стандартным ответом экосистемы на эту дилемму долгое время оставался официальный компонент Kubernetes Vertical Pod Autoscaler (VPA). Однако в высоконагруженных промышленных средах платформенные команды быстро разочаровывались в его работе при включении режима автоматического применения рекомендаций (UpdateMode: Auto).
Главная беда традиционного VPA — способ изменения конфигурации. Исторически ядро Kubernetes не поддерживало мутацию ресурсов на лету, поэтому VPA был вынужден физически выселять (evict) и перезапускать поды при каждом изменении лимитов. В продакшене это оборачивалось катастрофой: во время пиковой нагрузки, когда приложению требовалось больше памяти, автоскейлер начинал массово перезагружать контейнеры, провоцируя лавинообразный шторм запросов и сбрасывая кэши в оперативной памяти. Кроме того, при обновлении версии приложения через CI/CD классический VPA терял контекст истории, начиная калибровку с нуля.
Архитектура Ballast: перцентили, история в Redis и градуальное подключение
Инженеры Block спроектировали Ballast с чистого листа, устранив фундаментальные родовые травмы ранних инструментов оптимизации. Оператор работает в тесной связке с временными рядами Prometheus (или масштабируемыми хранилищами Thanos, Cortex, Mimir) и строит статистический регрессионный анализ поведения сервиса за глубокое скользящее окно — от 7 до 14 дней.
Чтобы отсечь случайные аномалии и секундные спайки, Ballast оперирует перцентилями: для процессора обычно берется 95-й перцентиль (P95), а для памяти — 99-й (P99). Поверх вычисленной кривой накладывается настраиваемый коэффициент безопасности (Safety Margin), создающий страховочный буфер.
Ключевым архитектурным отличием стала «кластерная память». История утилизации ресурсов сохраняется во внешнем хранилище Redis или Valkey с привязкой к постоянным меткам сервиса. Когда пайплайн деплоит новую ревизию Deployment, свежие поды сразу получают оптимальные размеры из истории, исключая эффект холодного старта.
Подключение сервисов к Ballast происходит по прозрачной трехступенчатой модели:
- Режим наблюдения (
measure): оператор только собирает телеметрию, рассчитывает профиль и записывает рекомендуемые значения в аннотации пода, не вмешиваясь в работу системы. Это позволяет разработчикам сравнить цифры в дашборде. - Режим упреждения (
apply): оператор перехватывает создание новых подов через Mutating Admission Webhook и подставляет вычисленные requests/limits на этапе планирования. - Режим прямого масштабирования (
resize): оператор берет под контроль жизненный цикл работающих экземпляров.
# Разметка деплоймента для постепенного ввода под управление Ballast
apiVersion: apps/v1
kind: Deployment
metadata:
  name: billing-api
  namespace: finance
  annotations:
    # Шаг 1: переводим сервис в режим наблюдения и сравнения метрик
    ballast.io/mode: "measure"
    ballast.io/config: "finance-workload-policy"
spec:
  replicas: 5
  template:
    metadata:
      labels:
        app.kubernetes.io/name: billing-api
    spec:
      containers:
        - name: server
          image: internal-registry.io/finance/billing:v2.14.0
          resources:
            requests:
              cpu: "1000m"
              memory: "2Gi"
Динамический In-Place Resizing без перезапуска контейнеров
Революционным преимуществом Ballast является нативная поддержка механизма In-Place Pod Vertical Scaling (доступного в современных версиях Kubernetes 1.35+). Вместо разрушительного удаления пода оператор отправляет запрос на модификацию подведомственного подресурса через Kubelet API.
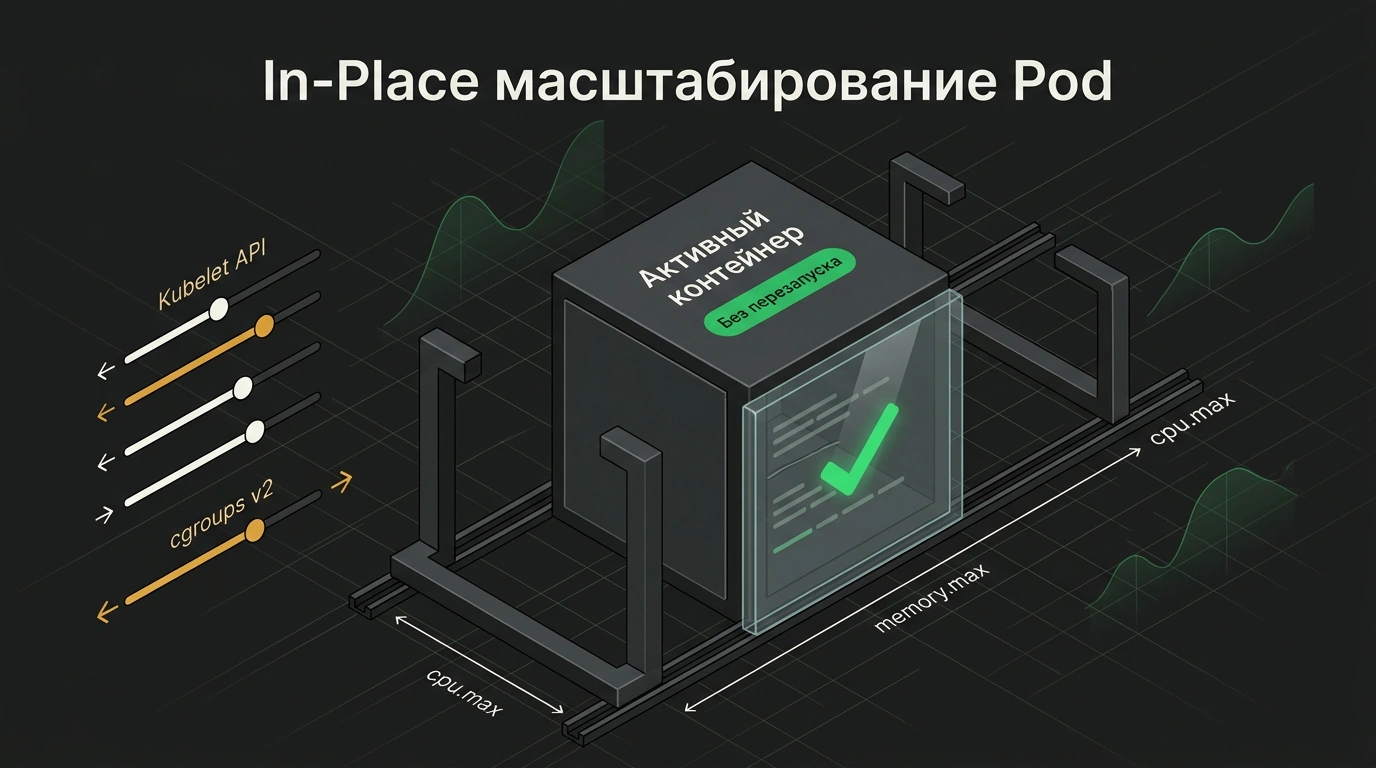
В процессе изменения операционная система хоста просто корректирует квоты в контрольных группах cgroups контейнера: расширяет лимит cpu.max или двигает границу memory.max. Процесс внутри контейнера продолжает непрерывно обрабатывать сетевые соединения, сокеты не рвутся, кэши не инвалидируются, а фоновые горутины и треды даже не замечают момента изменения лимитов.
Тонкая настройка манифеста BallastConfig и защита от флаппинга
Вся логика калибровки описывается через декларативный Custom Resource Definition (CRD) BallastConfig. В нем задаются жесткие коридоры минимальных и максимальных значений, шаг выборки метрик и периоды охлаждения:
apiVersion: ballast.io/v1alpha1
kind: BallastConfig
metadata:
  name: finance-workload-policy
  namespace: finance
spec:
  targetRef:
    apiVersion: apps/v1
    kind: Deployment
    name: billing-api
  prometheus:
    queryWindow: "14d"
    step: "5m"
  cpu:
    percentile: 0.95
    safetyMarginMultiplier: 1.20
    minRequest: "150m"
    maxLimit: "3000m"
  memory:
    percentile: 0.99
    safetyMarginMultiplier: 1.25
    minRequest: "512Mi"
    maxLimit: "6Gi"
    oomHeadroomBytes: 268435456 # Дополнительные 256 МиБ запаса при риске OOM
  stabilizationWindow:
    scaleUpMinutes: 5     # Наращивание при росте нагрузки происходит мгновенно
    scaleDownMinutes: 720 # Урезание ресурсов замораживается на 12 часов от флаппинга
Для защиты от эффекта флаппинга (постоянных колебаний ресурсов туда-обратно) Ballast использует несимметричные окна стабилизации: реакция на рост потребления происходит за считанные минуты, тогда как понижение лимитов замораживается на длительный срок. Более того, встроенный предохранитель (Circuit Breaker) моментально блокирует любые корректировки, если опрос Prometheus завершился ошибкой или метрики временно недоступны.
Правила безопасного внедрения: когда оператор спасает бюджет, а когда противопоказан
Опыт внедрения Ballast в инфраструктуре Block показал сокращение неиспользуемых процессорных квот на 40–55% в тестовых средах и экономию сотен тысяч долларов на серверах баз данных и микросервисов. Однако авторы проекта четко очерчивают границы применимости.
Оператор идеален для stateless-микросервисов, REST API, воркеров очередей и веб-приложений, где потребление ресурсов пропорционально входящему трафику. При этом Ballast отлично уживается с Horizontal Pod Autoscaler (HPA), если горизонтальный автоскейлер настроен по внешним бизнес-метрикам (длина очереди сообщений RabbitMQ/Kafka или RPS), а Ballast непрерывно калибрует оптимальный размер отдельной реплики.
С другой стороны, оператор требует осторожности при работе с приложениями на базе JVM (Java, Scala, Kotlin) со статически выделенным пулом кучи (-Xms == -Xmx), а также с базами данных, использующими оперативный дисковый кэш (Page Cache). В таких сценариях память формально считается занятой ядром ОС, и автоматическое срезание лимитов приведет к деградации операций ввода-вывода. Для всех остальных нагрузок Ballast становится незаменимым роботом-экономистом, возвращающим инфраструктуре реальный баланс.