
Если ты когда-нибудь пытался автоматизировать разбор документов, счетов-фактур или веб-интерфейсов с помощью ИИ, то знаешь, какая это головная боль. Обычная связка выглядит чудовищно громоздко: сначала сторонняя библиотека распознает текст, затем парсер пытается угадать границы таблиц, и только потом результат передается в языковую модель. На каждом стыке теряются данные: разметка плывет, цифры перепутываются, а контекст распадается.
NVIDIA выкатила открытый ответ на эту проблему — мультимодальную модель NVIDIA-Nemotron-3.5-Super-VL-120B-A12B-BF16. Это флагманская Vision-Language модель на 120 миллиардов параметров, которая умеет напрямую «видеть» скриншоты, сканы и графики с контекстным окном до одного миллиона токенов.
Давай разберем, как устроена ее архитектура и как развернуть ее для анализа интерфейсов без космических затрат на инфраструктуру.
Гибрид Mamba-2 и MoE: 120 миллиардов весов со скоростью 12B
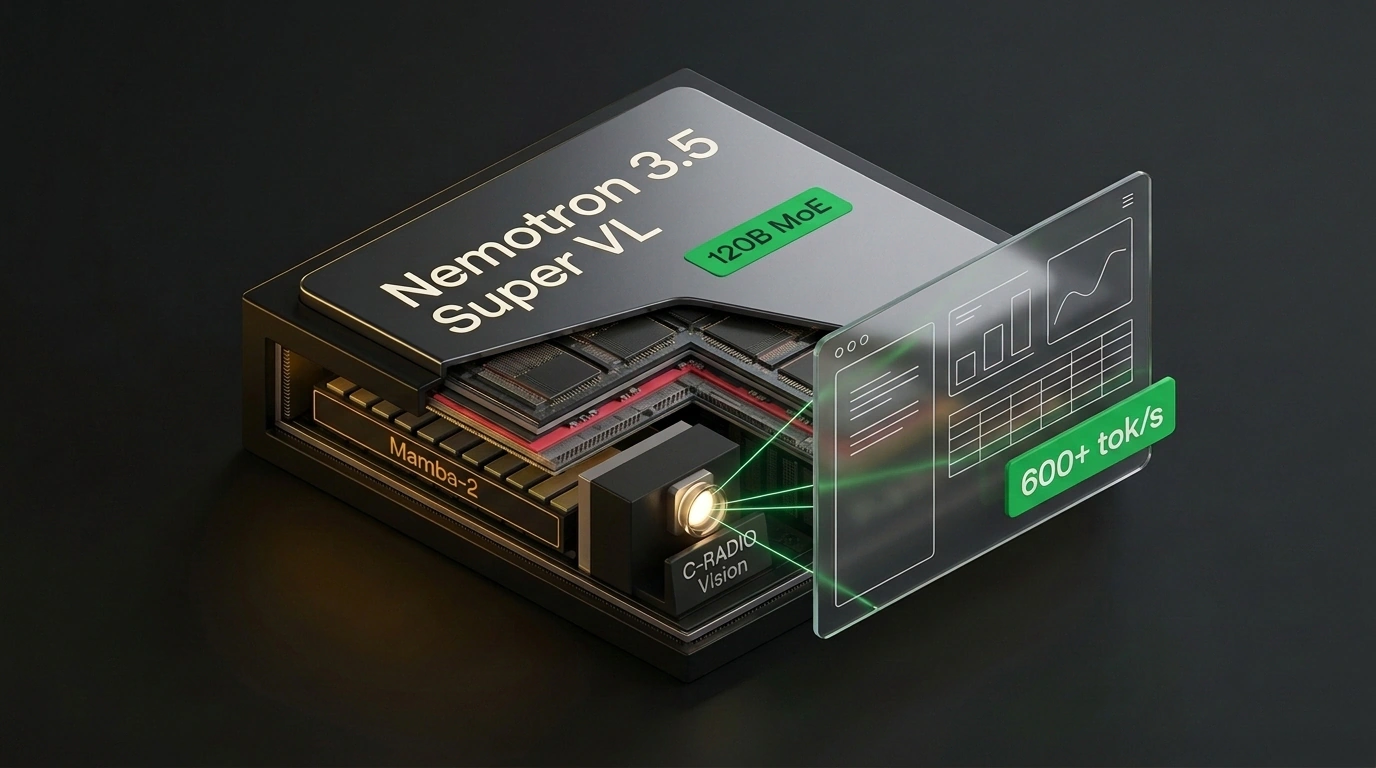
Главный инженерный триумф разработчиков — архитектурный симбиоз. Модель объединяет слои линейного внимания Mamba-2, классический механизм внимания и разреженную структуру Mixture of Experts (MoE) со зрительным энкодером C-RADIO.
Ранее мы уже исследовали, как архитектура Mamba и гибридные языковые модели помогают экономить вычислительные ресурсы при длинном контексте. В Nemotron 3.5 этот подход доведен до абсолюта:
- Из 120 миллиардов параметров на каждый токен активируются всего 12 миллиардов весов.
- Скорость генерации подскакивает до внушительных 600+ токенов в секунду на современных графических процессорах NVIDIA.
- В агентных задачах модель работает в 5 раз быстрее плотных (Dense) сетей аналогичного масштаба, потребляя в разы меньше энергии.
В бенчмарках новинка показала отличные результаты: первое место среди открытых визуальных моделей в OCRBench v2, уверенные 80,8% в понимании диаграмм ChartX (с ростом до 84% при подключении интерпретатора Python) и 63,44% в агентном тесте Hermes, оставив позади даже проприетарную Nemotron 3 Ultra.
Как мы отмечали, изучая мультимодальные модели и распознавание интерфейсов, именно способность понимать визуальное взаимное расположение элементов на экране превращает модель в полноценного цифрового оператора.
Запуск инференса: скрипт анализа скриншота
Веса модели опубликованы на Hugging Face в форматах BF16 и квантованном NVFP4. Для быстрого тестирования в Python используется библиотека transformers:
import torch
from PIL import Image
from transformers import AutoModelForCausalLM, AutoProcessor

model_id = "nvidia/NVIDIA-Nemotron-3.5-Super-VL-120B-A12B-BF16"

# Загружаем процессор и модель
processor = AutoProcessor.from_pretrained(model_id, trust_remote_code=True)
model = AutoModelForCausalLM.from_pretrained(
    model_id,
    torch_dtype=torch.bfloat16,
    device_map="auto",
    trust_remote_code=True
)

image = Image.open("dashboard_screenshot.png").convert("RGB")
prompt = "<|image|>
Analyze this application dashboard. Extract all metrics from the KPI table into JSON format."

inputs = processor(text=prompt, images=image, return_tensors="pt").to("cuda")

with torch.inference_mode():
    output_ids = model.generate(
        **inputs,
        max_new_tokens=1024,
        temperature=0.1
    )

response = processor.decode(output_ids[0], skip_special_tokens=True)
print(response)
Сервинг в продакшене через vLLM
Для создания высокопроизводительного API-сервера с поддержкой очередей используется сервер vLLM. Квантованная версия в формате NVFP4 отлично ложится на двухпроцессорную связку:
# Развертывание OpenAI-совместимого эндпоинта vLLM с квантованием NVFP4
vllm serve nvidia/NVIDIA-Nemotron-3.5-Super-VL-120B-A12B-NVFP4   --tensor-parallel-size 2   --max-model-len 32768   --trust-remote-code   --port 8000
Nemotron 3.5 Super VL идеальна для сценариев RPA (Robotic Process Automation): сверка сканов первичных бухгалтерских документов, аудит интерфейсов веб-приложений и преобразование скриншотов мобильных приложений в чистый код компонентов.
Что это меняет
NVIDIA доказала, что мультимодальность не должна быть громоздкой. Разреженная архитектура MoE в паре со зрительным энкодером C-RADIO превращает Nemotron 3.5 Super VL в скоростной комбайн, способный распознавать сложнейшие таблицы и интерфейсы на лету без необходимости арендовать гигантские облачные фермы.