
Стремление скормить нейросети как можно больше информации — от увесистых логов веб-сервера до полной документации проекта — неизбежно упирается в законы вычислительной физики. В классической архитектуре Transformer механизм внимания (Attention) обладает квадратичной сложностью: если увеличить длину входящего текста в десять раз, объем вычислений и потребление видеопамяти возрастут в сотню раз. Именно поэтому работа со сверхдлинными контекстами до сих пор оставалась привилегией прожорливых облачных кластеров.
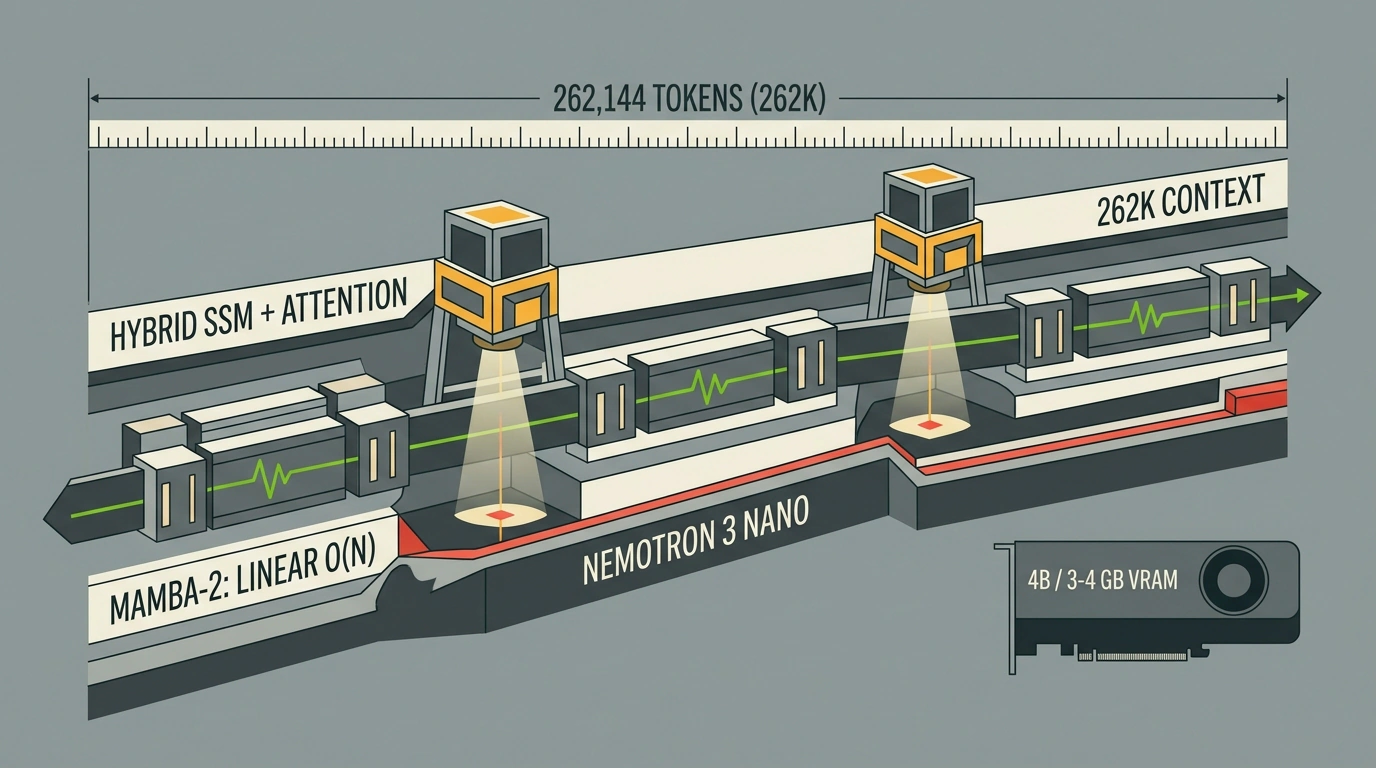
Компания Nvidia предложила фундаментальный пересмотр этой парадигмы, выпустив открытую компактную модель Nemotron 3 Nano 4B. Объединив в одном теле механизм пространства состояний Mamba-2 и классические слои внимания, инженерам удалось достичь фантастического для 4-миллиардной модели рабочего окна в 262 144 токена (262K) с возможностью комфортного запуска на обычном потребительском компьютере.
Скрещивание двух миров: линейная скорость Mamba и точность Transformer
В последние два года в мире ИИ развернулась острая борьба архитектур:
- Трансформеры превосходно извлекают точечные факты из памяти («иголка в стоге сена»), но захлебываются в расходе видеопамяти при росте контекста.
- Модели пространства состояний (SSM), такие как Mamba-2, обрабатывают последовательность линейно: они сжимают историю в компактное состояние фиксированного размера, работая с молниеносной скоростью при длине текста в сотни тысяч токенов, однако иногда упускают мелкие ассоциативные детали.
Инженеры Nvidia применили гибридный подход. Основную массу слоев в Nemotron 3 Nano составляют блоки Mamba-2, непрерывно прогоняющие через себя массивный поток токенов с линейной сложностью, а через регулярные промежутки встроены слои внимания с группировкой запросов (Grouped-Query Attention). Такая комбинация позволяет сохранять филигранную точность поиска информации в глубоком контексте без взрывного аппетита к памяти.
Базовые знания и логика рассуждений были перенесены в компактную модель методом дистилляции из старшей версии Nemotron 9Bv2 с последующей калибровкой на синтетических цепочках рассуждений.
Запуск локального инференса: инициализация vLLM на 262K токенов
При четырех миллиардах параметров модель в 4-битном квантовании (AWQ или GGUF) весит скромные 3–4 гигабайта. Это означает, что ее можно без труда развернуть на стандартных потребительских видеокартах с 8–12 ГБ VRAM (уровня RTX 4060 или RTX 4070) или на ноутбуках Apple Silicon с объединенной памятью от 16 ГБ.
Для практического запуска длинного контекста используется оптимизированный инференс-движок vLLM с поддержкой гибридных слоев:
# Инициализация гибридной модели Nemotron 3 Nano 4B в среде vLLM
from vllm import LLM, SamplingParams

llm = LLM(
    model="nvidia/Nemotron-3-Nano-4B",
    trust_remote_code=True,
    max_model_len=262144,          # Полный контекст 262K токенов
    gpu_memory_utilization=0.9,     # Выделение видеопамяти под KV-кэш
    tensor_parallel_size=1,
)
Благодаря линейной природе слоев Mamba-2, выделенный под сессию кэш не раздувается до десятков гигабайт, оставляя запас памяти под генерацию.
Активация режима рассуждений: анализ сотен тысяч токенов
Nemotron 3 Nano 4B поддерживает режим внутреннего монолога (Thinking Mode), когда модель перед выдачей ответа генерирует скрытые цепочки рассуждений, проверяя себя на логические ошибки:
# Настройка параметров выборки и запуск генерации с цепочкой рассуждений
sampling_params = SamplingParams(
    temperature=0.6,
    top_p=0.95,
    max_tokens=4096,
)

prompt = """<|start_of_role|>system<|end_of_role|>
Ты — локальный аналитический ассистент. Используй цепочку рассуждений для глубокого анализа контекста.<|end_of_text|>
<|start_of_role|>user<|end_of_role|>
Проанализируй лог сборки ядра Linux (объем 200 000 токенов) и укажи точную причину сбоя драйвера.<|end_of_text|>
<|start_of_role|>assistant<|end_of_role|>
<think>
"""

# Генерация структурированного ответа на базе объемного контекста
outputs = llm.generate([prompt], sampling_params)
for result in outputs:
    print(result.outputs[0].text)
Модель методично отслеживает зависимости по всему объему переданного лога, локализует точку падения компилятора и выдает аргументированный отчет.
Локальный суверенитет над данными
Главный практический вывод релиза Nemotron 3 Nano 4B — разрушение монополии облачных провайдеров на длинный контекст. Теперь анализ конфиденциальной бухгалтерской документации, аудит закрытых репозиториев или расследование инцидентов в логах можно проводить на собственном изолированном оборудовании, не опасаясь утечки данных в сторонние API. Гибридная архитектура открывает дорогу по-настоящему автономным локальным системам.