
Ты наверняка ловил себя на мысли при общении с продвинутой нейросетью: «Она действительно понимает, о чем я говорю». Кажется, что внутри серверов зародился настоящий цифровой разум, который внимательно слушает твои вопросы, правит код и рассуждает о мире.
Давай начистоту: у меня самого поначалу то и дело пробегали мурашки по коже. Но стоит снять полированный кожух серверной стойки, как магия испаряется. Вместо сверхразума перед нами открывается колоссальный инженерный механизм. Здесь мегаватты электричества превращаются в кипящий хладагент, терабайты памяти прокачиваются по медным шинам за доли секунды, а матричные перемножения решают одну утилитарную задачу — угадывают, какой кусочек слова статистически вероятнее поставить следующим.
Если ты хочешь осознанно строить продукты на базе ИИ или просто понимать, куда движется индустрия, пора перестать воспринимать нейросети как магию. Давай разберем эту многослойную башню по винтикам — от кремниевых кристаллов до капризных агентных систем.
Кремниевый фундамент: почему ИИ упирается в физику и киловатты
Любая иллюзия понимания рождается в кремнии, и здесь действуют жесткие законы термодинамики.
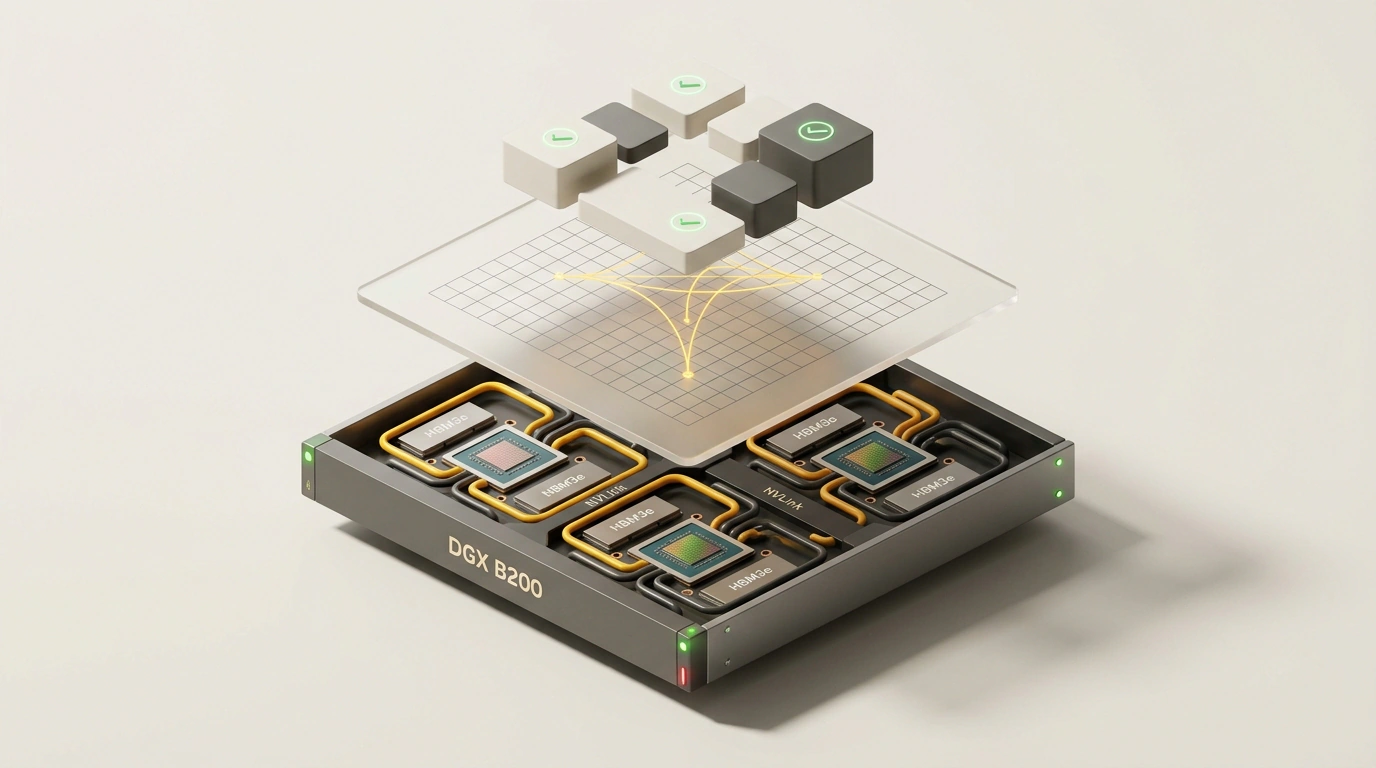
Возьмем серверный узел NVIDIA DGX B200, ставший стандартом для тяжелых вычислений. Внутри одного корпуса упаковано 8 графических процессоров B200 Tensor Core с общим объемом памяти 1440 ГБ HBM3e. Агрегатная пропускная способность памяти достигает 64 ТБ/с — по 8 ТБ/с на каждый кристалл.
Зачем нужна такая скорость? При генерации каждого токена модель обязана прочитать все свои миллиарды весов из памяти в вычислительные ядра. Если шина памяти узкая, мощные ядра будут простаивать в ожидании данных, как сборщики на конвейере без деталей.
В современных LLM производительность генерации упирается не в скорость математических вычислений, а в пропускную способность памяти (Memory Bandwidth). Модель не может отвечать быстрее, чем ее веса перекачиваются из чипов HBM3e в вычислительные блоки.
Когда веса не помещаются на один чип, модель разрезают на части. В архитектуре Blackwell для связки GPU используется шина NVLink 5 с двунаправленной пропускной способностью 1,8 ТБ/с на процессор, а коммутаторы NVSwitch пятого поколения дают межпроцессорную пропускную способность до 14,4 ТБ/с на ноду.
А теперь взгляни на энергопотребление: один DGX B200 потребляет порядка 14,3 кВт. Стойка из 2–4 таких систем требует от 28,6 до 57,2 кВт. Продуть такую плотность тепла воздухом невозможно — поэтому дата-центры переходят на прямое жидкостное охлаждение пластин (Direct-to-Chip Liquid Cooling), прогоняя хладагент прямо над кремнием. Физика и киловатты напрямую определяют себестоимость каждого твоего запроса.
От букв к векторам: математика токенизации и механизм внимания
Как человеческий текст попадает в раскаленные чипы? Компьютеры не понимают букв и смыслов — они умеют только умножать матрицы чисел.
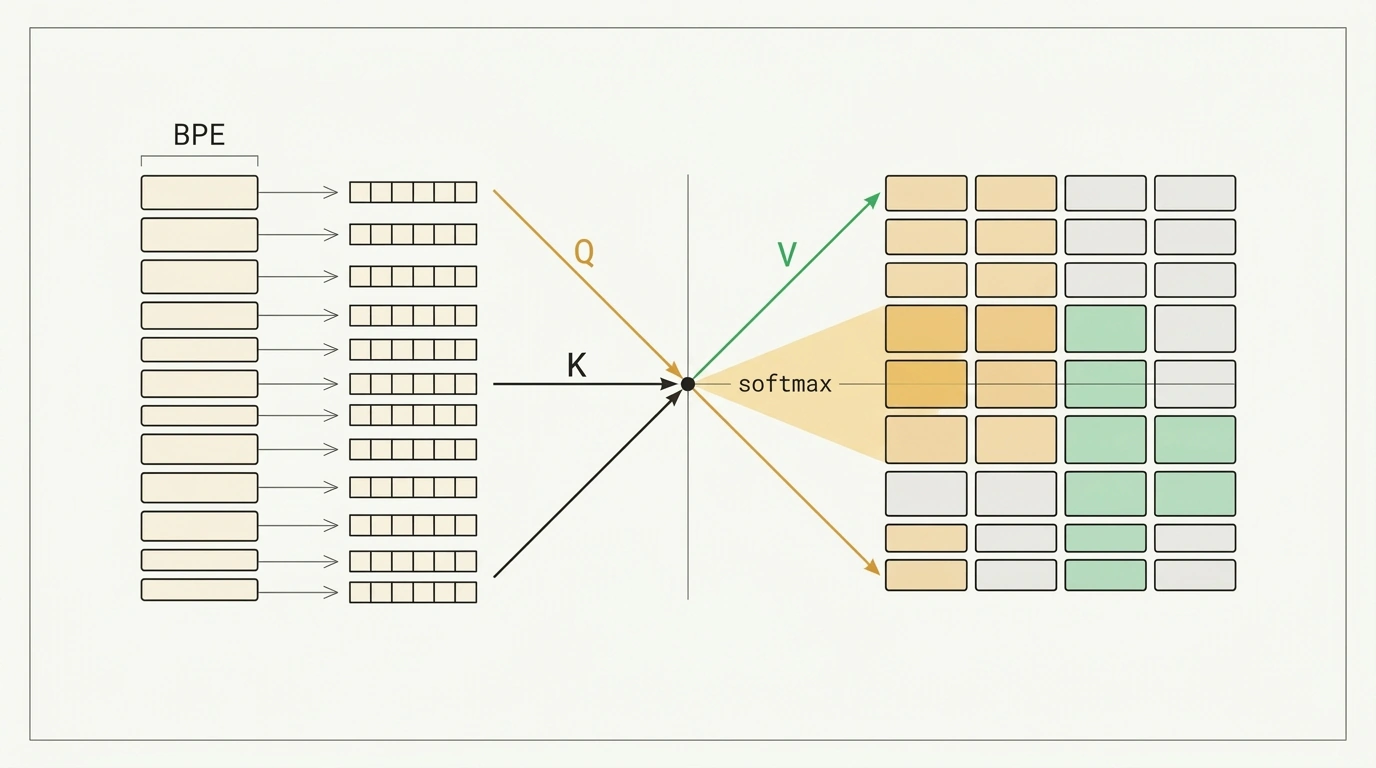
Сначала текст режется на токены с помощью алгоритмов вроде Byte-Pair Encoding (BPE) или SentencePiece. Токеном может быть целое короткое слово, слог или знак препинания. Затем каждый токен превращается в уникальный номер и проецируется в вектор эмбеддинга — цепочку дробных чисел из тысяч измерений, где близкие по смыслу слова лежат рядом.
Дальше вступает механизм внимания (Scaled Dot-Product Self-Attention):
На пальцах это устроено наглядно. Представь темную библиотеку карточек со словами (Values). У каждой карточки есть бирка-ключ (Key). Для входящего токена модель формирует запрос (Query): «Какое слово в контексте мне сейчас важнее всего?» Запрос перемножается с ключами, и модель направляет мысленный луч фонарика на связанные карточки, смешивая их векторы с учетом весов внимания.
Здесь важно различать два подхода:
- Плотные модели (Dense): на каждый токен задействуются все параметры сети. Это дает максимальную эрудицию, но требует огромных вычислительных затрат.
- Разреженные модели (MoE, Mixture of Experts): сеть разделена на экспертов, и для конкретного токена активируется лишь небольшая их часть (например, 8 из 256). Сеть остается емкой, но шаг генерации обходится заметно дешевле.
Как мы отмечали, разбирая новые рубежи архитектур ИИ, именно разреженные MoE-архитектуры и расширенные контекстные окна сделали возможной работу со сложными документами и кодовыми базами без экспоненциального взлета серверных затрат.
Три этапа обучения: от сырых весов до диалога
Если просто обучить нейросеть на терабайтах текстов из интернета, общаться с ней не получится. Путь модели состоит из трех четких стадий:
- Базовое предобучение (Pre-training): Модель читает триллионы токенов и учится строго одному навыку — предсказывать следующий токен. На вопрос «Как приготовить суп?» она может выдать «— спросил герой романа», продолжая текст как отрывок из книги.
- Дообучение с учителем (SFT): Инженеры скармливают модели сотни тысяч выверенных пар «запрос пользователя — идеальный ответ ассистента». Модель перестраивается и осваивает саму форму диалога.
- Выравнивание (RLHF, DPO, KTO): С помощью обратной связи от людей или моделей-судей алгоритм штрафуют за дезинформацию и поощряют за точность и полезность. Так формируется предсказуемое и безопасное поведение.
Индустрия смещается от слепого наращивания параметров к парадигме Test-Time Compute: вместо моментальной выдачи первого токена модель генерирует скрытые цепочки рассуждений, взвешивает гипотезы и отсекает тупиковые варианты перед тем, как показать ответ.
Агентный контур: инструменты и скрытая ловушка ошибок
Что превращает чат-бота в автономного агента? Программная обвязка (harness) и вызовы инструментов (Function Calling).
Модели дают возможность читать и менять файлы, выполнять bash-команды и дергать внешние API через циклы ReAct или Code-Act: мысль -> действие -> результат вызова функции -> корректировка шага.
Но здесь кроется главная ловушка: экспоненциальное накопление ошибок. Если надежность каждого шага агента составляет солидные 95%, то в цепочке из 10 действий вероятность успеха падает до $0{,}95^{10} \approx 60%$, а на 30 шагах — до 21%. Без внешних детерминированных тестов агент быстро уходит в галлюцинации и начинает ломать работающий проект.
Поэтому инженерия автономных ИИ-агентов сегодня требует жестких контрактных рамок, песочниц и проверки каждого шага компилятором, а не слепого доверия языковой модели.
Сухой остаток
Искусственный интеллект — это не сверхъестественный разум, а сложнейший инженерный механизм. В его основе лежат теплоотвод дата-центров, пропускная способность кремниевых шин HBM3e, элегантная линейная алгебра внимания и строгие алгоритмические обвязки. Понимая эти реальные шестеренки, ты сможешь трезво оценивать громкие обещания и строить надежные практические системы.