

Долгое время выбор открытой языковой модели для работы на собственном железе напоминал хождение по лезвию ножа. Маленькие модели на 7–8 миллиардов параметров быстро отвечали, но путались в сложной логике и регулярно выдавали синтаксические ошибки при генерации JSON. А гиганты на 70 миллиардов весов требовали дорогущих серверных карт и на обычных видеокартах ползли со скоростью черепахи.
Google DeepMind решил эту дилемму, представив поколение открытых моделей Gemma 4. Флагманом линейки стала модель плотной (Dense) архитектуры на 30,7 миллиарда параметров — Gemma 4 31B. Она выходит под чистой коммерческой лицензией Apache 2.0, поддерживает контекст в 256 000 токенов и умеет нативно вызывать функции.
Давай посмотрим на результаты ее бенчмарков и разберем, как собрать llama.cpp и запустить модель на пользовательском компьютере.
Рекорды в бенчмарках: скачок от 6% до 86%
Главная сенсация релиза — способность компактной плотной сети соревноваться с моделями кратно большего размера:
- В сложнейшем математическом соревновании AIME 2026 модель набрала 89,2%, опередив Llama 4 (88,3%).
- В академическом тесте GPQA Diamond показан результат 84,3%.
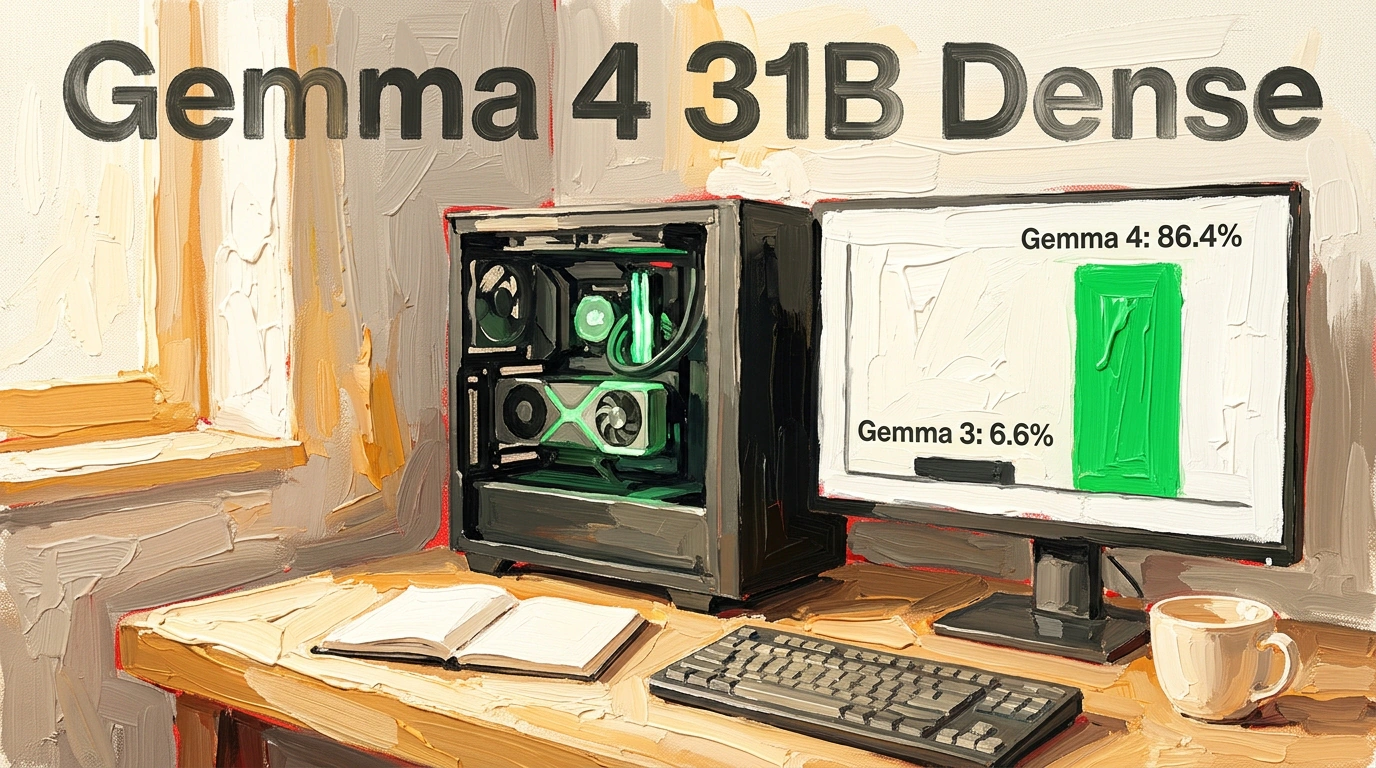
- Но самый драматичный прорыв случился в агентных сценариях автоматизации: если прошлая Gemma 3 набирала скромные 6,6%, то Gemma 4 31B совершила рывок до 86,4%.
- В рейтинге Chatbot Arena модель зафиксировала ELO 1452, вплотную приблизившись к закрытым коммерческим API.
Ранее мы детально исследовали локальные модели для кода и оптимизацию инференса, а также разбирали сжатие контекста и квантование нейросетей. Gemma 4 доказывает, что плотная 31B-модель в формате 4-битного квантования GGUF становится идеальной рабочей лошадкой для домашней рабочей станции.
Сборка llama.cpp с поддержкой аппаратного ускорения
Для максимальной скорости инференса рекомендуется собрать утилиту llama.cpp из исходного кода с поддержкой CUDA под видеокарты NVIDIA или Metal под macOS:
git clone https://github.com/ggerganov/llama.cpp
cd llama.cpp

# Сборка с аппаратным ускорением CUDA для карт NVIDIA
cmake -B build -DGGML_CUDA=ON
cmake --build build --config Release -j$(nproc)
Если ты запускаешь модель на Mac с процессором Apple Silicon, при конфигурировании вместо флага CUDA указывается -DGGML_METAL=ON.
Загрузка весов и запуск в консоли
Загружаем файл модели в сбалансированном квантовании Q4_K_M (занимает порядка 18–19 ГБ VRAM) и запускаем интерактивную сессию:
# Загрузка квантованных весов через huggingface-cli
huggingface-cli download bartowski/gemma-4-31b-it-GGUF   --include "*Q4_K_M*"   --local-dir ./models

# Интерактивный запуск с выгрузкой всех слоев на GPU
./build/bin/llama-cli   -m ./models/gemma-4-31b-it-Q4_K_M.gguf   --chat-template gemma   -ngl 99   -c 32768   --temp 0.2   -p "You are an expert systems engineer. Analyze this architecture specification and suggest refactoring steps."
Модель Gemma 4 использует специфические управляющие токены для разметки диалога и скрытых цепочек рассуждений (<|channel>thought ... <channel|>). Если ты забудешь указать параметр --chat-template gemma, утилита применит стандартный шаблон, и модель начнет генерировать бессмысленный мусор.
Контекстное окно в 256K токенов требует солидного объема памяти под KV-кэш. Чтобы кэш не вытеснил веса модели из видеопамяти, добавь в команду запуска флаги 8-битного квантования кэша: -ctk q8_0 -ctv q8_0.
Итог
Gemma 4 31B — это настоящий подарок для тех, кто ценит независимость и приватность. Свободная лицензия Apache 2.0 позволяет использовать ее в любых коммерческих сервисах, а скромные аппаратные аппетиты дают возможность развернуть полноценный агентный контур на одной потребительской видеокарте.