

Ты наверняка ловил себя на этом странном ощущении в конце рабочего дня: вроде бы ты не написал ни строчки сложного кода вручную, в терминале крутились несколько сессий с кодинг-агентами, коммиты сыпались десятками, а голова гудит так, будто ты разгружал фуру с серверами. Это не просто усталость, а классический эффект «выжженного мозга» (Fried Brain Effect), с которым столкнулись многие инженеры при переходе на мультиагентную разработку.
Я сам долго не мог понять, почему обещанная революция продуктивности обернулась изнуряющим микроменеджментом. Нам продавали красивую картинку: запускаешь пятерых умных помощников, раздаешь задачи и спокойно пьешь кофе. В реальности же ты превращаешься в дерганого диспетчера: каждые две минуты одна вкладка требует подтвердить команду git rebase, вторая споткнулась о конфликт версий, третья галлюцинирует методом в API, а четвертая молча переписала половину архитектуры проекта. Внимание рвется на куски, состояние потока испаряется, а продуктивность падает.
Давай снимем глянцевую обертку с агентного хайпа, разберем механику этой ловушки и посмотрим, как в Google Research и сообществе автономных фабрик предлагают разорвать замкнутый круг с помощью самообучающихся обвязок Harness².
Ловушка диспетчера: почему параллельные сессии ломают фокус
Корень проблемы кроется в фундаментальном биологическом ограничении: человеческий мозг принципиально однопоточен при решении сложных инженерных задач. Мы умеем глубоко фокусироваться на одной проблеме, удерживая в оперативной памяти граф зависимостей и краевые условия. Когда ты запускаешь параллельные чат-сессии, твой мозг переходит в режим контекстного трэшинга (Context Thrashing) — точно так же, как перегруженная ОС, которая тратит почти все ресурсы на переключение страниц памяти вместо полезной работы.
В концепции «AI Software Factory», которую развивает исследователь Коул Медин, это противоречие формулируется предельно четко: параллелизация на уровне человека не работает. Если агент дергает тебя каждые три минуты за подтверждением очередного шага, он не экономит твое время, а забирает его без остатка.
Каждое переключение внимания между контекстами несвязанных задач отнимает у инженера от 10 до 15 минут на восстановление глубокой мысли. Пять активных сессий генерируют до 30 прерываний в час, полностью уничтожая способность замечать тонкие архитектурные дефекты.
Выход из тупика — отказ от интерактивного «бэбиситтинга». Зрелый процесс переходит к парадигме предварительного выравнивания (upfront alignment) и пакетной валидации. Ты тратишь 15–20 минут на формулирование строгого ТЗ, генерацию детерминированных тестов и ограничений окружения, а затем отправляешь агента в автономный цикл на несколько часов. Ты не смотришь на промежуточные логи, а открываешь готовый пул-реквест только тогда, когда агент завершил все проверки в изолированной ветке.
Как мы уже разбирали в исследовании про архитектуру агентных циклов и луп-инжиниринг, настоящий скачок продуктивности начинается с замкнутой петли обратной связи. Но здесь встает следующий вопрос: как научить агента не наступать на одни и те же грабли при длительной работе?
Мозг против обвязки: где на самом деле живет надежность
Долгое время считалось: чтобы агент стал стабильнее, нужно дождаться следующей версии базовой модели от гигантов индустрии. Заплатить больше за гигантскую LLM — и проблемы исчезнут.
Однако команда Google Research в работе Harness²: Recursive Agent Harnessing for an Open World показала: базовая модель — это лишь сырой «мозг», процессор общих рассуждений. А итоговый успех задачи целиком определяет его «обвязка» (Agent Harness).
Обвязка объединяет восемь критических компонентов окружения:
- Системный промпт и ролевые инструкции.
- Защитные барьеры и валидаторы безопасности (Guardrails).
- Пространство долговременной памяти и накопленный опыт.
- Специализированные навыки и регламенты (Skills).
- Документация и сигнатуры инструментов (Tools Documentation).
- Вспомогательные исполняемые скрипты и хуки окружения.
- Иерархия вызываемых суб-агентов.
- Промежуточное программное обеспечение (Middleware).
Если документация к библиотеке описана невнятно или в системном промпте не заданы типы аргументов, даже передовой флагман будет сыпать ошибками. Но если обвязка настроена строго, легкая и быстрая модель легко обходит тяжелые закрытые системы.
Вот как выглядит практический манифест конфигурации обвязки автономного агента, изолирующей риски исполнения:
# agent_harness_config.yaml
version: "2.0"
agent:
  id: "software-factory-worker"
  base_model: "gemini-2.5-pro"
  temperature: 0.1
harness:
  max_autonomous_turns: 50
  reflection_cycle:
    enabled: true
    trigger: "on_task_completion"
    evaluation_benchmark: "internal_test_suite"
    persist_lessons_to: ".agents/memory/experience_log.json"
  guardrails:
    forbidden_commands:
      - "rm -rf /"
      - "git push --force origin main"
    budget_limit_usd: 15.00
    timeout_seconds: 7200
  tool_scaffolding:
    dynamic_guidance: true
    retry_on_syntax_error: 3
    verify_with_linter: true
Обрати внимание на секцию guardrails: финансовый лимит и таймаут задаются аппаратно на уровне среды выполнения, а не мягкими просьбами в системном промпте. Если агент завис в цикле, система принудительно останавливает процесс.
Рекурсивная оптимизация Harness²: обучение без изменения весов
Главное новшество фреймворка Harness² от Google Research — автоматический двухконтурный механизм рекурсивного улучшения обвязки.
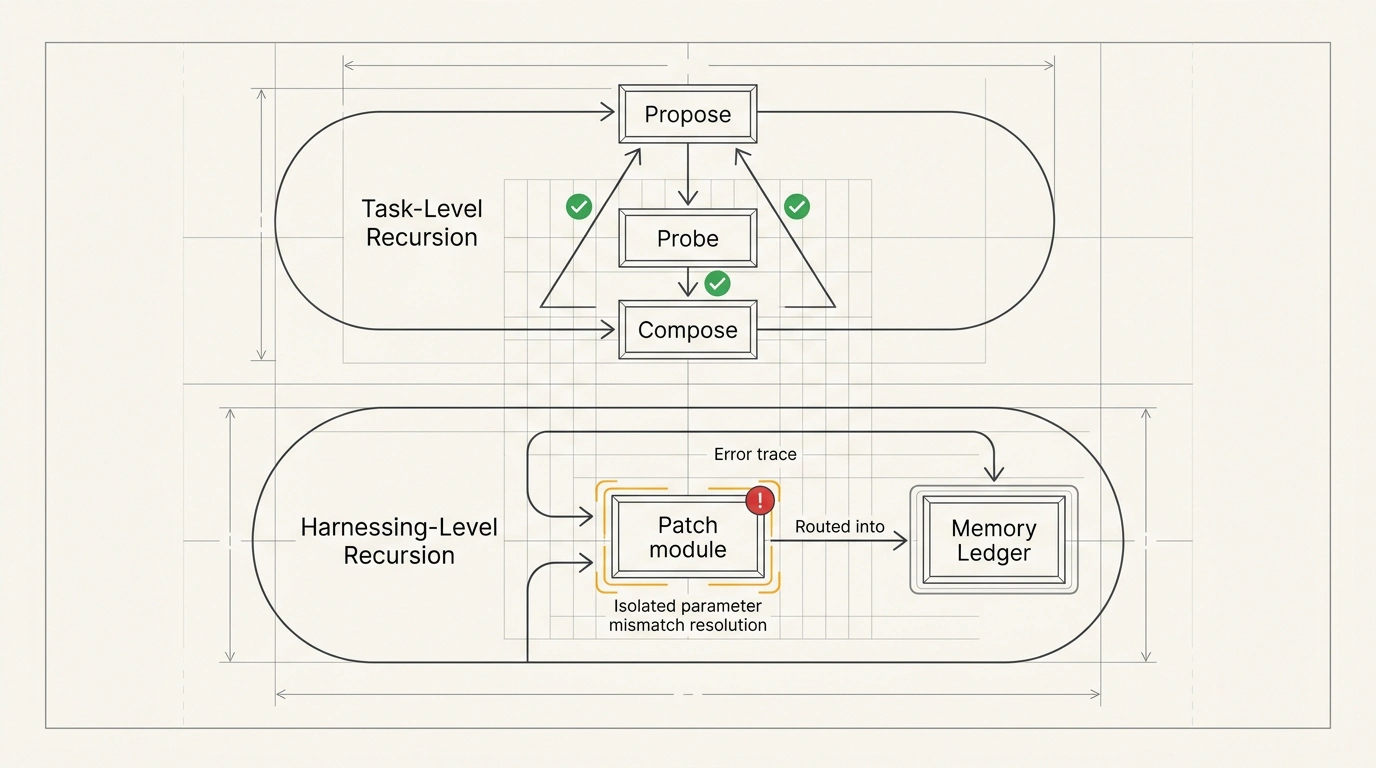
Первый контур — Task-Level Recursion (Propose–Probe–Compose). Получив задачу, система формулирует альтернативные варианты использования инструментов и промптов, проверяет их на зондирующих запросах и синтезирует лучшую траекторию. Оценка идет без участия человека — по объективным маркерам: прохождению тестов, отсутствию синтаксических сбоев компилятора и кодам ответов API.
Второй контур — Harnessing-Level Recursion. После завершения задачи модуль рефлексии анализирует лог: где инструмент вернул ошибку параметров, где модель ошиблась в типах данных. Затем фреймворк автоматически патчит обвязку: дописывает в документацию инструментов подсказки о краевых условиях, обновляет правила самопроверки и сохраняет урок в файл долговременной памяти.
На бенчмарке офисных задач WorkBuddy-Bench фреймворк Harness² показал прирост в +11.5 пунктов, на JobBench — +4.5 пунктов, а на юридическом бенчмарке LAB — +11.8 процентных пунктов при снижении ошибок вызова инструментов на 36%. И всё это — на неизменной базовой модели.
Ниже показан пример модуля рефлексии на Python, отслеживающего траекторию выполнения и обновляющего системную базу уроков:
"""
Рекурсивный модуль рефлексии обвязки агента (Harness Reflection Loop).
Анализирует траекторию выполнения, выявляет ошибки в вызовах инструментов
и обновляет системную документацию без модификации весов модели.
"""
from dataclasses import dataclass
from typing import List, Dict, Any
import json
import os

@dataclass
class ExecutionTrace:
    task_id: str
    tool_calls: List[Dict[str, Any]]
    errors_encountered: List[str]
    success: bool

class HarnessOptimizer:
    def __init__(self, memory_path: str):
        self.memory_path = memory_path
        os.makedirs(os.path.dirname(self.memory_path), exist_ok=True)

    def analyze_trace_and_adapt(self, trace: ExecutionTrace) -> Dict[str, str]:
        improvements: Dict[str, str] = {}
        if not trace.success or trace.errors_encountered:
            for error in trace.errors_encountered:
                if "parameter mismatch" in error.lower():
                    improvements["tool_guidance"] = (
                        "Внимание: строго проверяйте типы аргументов API перед вызовом. "
                        f"Зафиксирована ошибка: {error}"
                    )
            lesson = {
                "task_id": trace.task_id,
                "errors": trace.errors_encountered,
                "updates": improvements
            }
            self._save_lesson(lesson)
        return improvements

    def _save_lesson(self, lesson: Dict[str, Any]) -> None:
        with open(self.memory_path, "a", encoding="utf-8") as f:
            f.write(json.dumps(lesson, ensure_ascii=False) + "\n")
Как видишь, вместо бесконечной ручной правки промптов обвязка сама устраняет узкие места. Как отмечалось в исследовании о харнес-инжиниринге и самообучении агентов, именно эволюция окружения становится главным фактором надежности автономных систем.
Не проверяй промежуточные коммиты агента на лету. Настрой локальный CI-пайплайн так, чтобы агент сам прогонял линтеры, тесты и генерировал сводку изменений. Твое ревью должно начинаться только тогда, когда все автоматические тесты уже успешно пройдены.
Где проходит граница автономности
Рекурсивные обвязки показывают отличную надежность на детерминированных задачах со строгой обратной связью: рефакторинг легаси-кода, покрытие тестами, генерация изолированных микросервисов и миграция схем баз данных. В них компилятор и тестовый фреймворк служат объективным арбитром.
Однако в открытых продуктовых вопросах без участия человека агент быстро начинает оптимизировать несуществующие метрики или плодить избыточные абстракции. Поэтому роль архитектора остается за тобой: формулировать цели, ставить границы и валидировать готовый результат. А рутину ловли синтаксических ошибок и синхронизации окружения пора полностью переложить на плечи надежных обвязок.