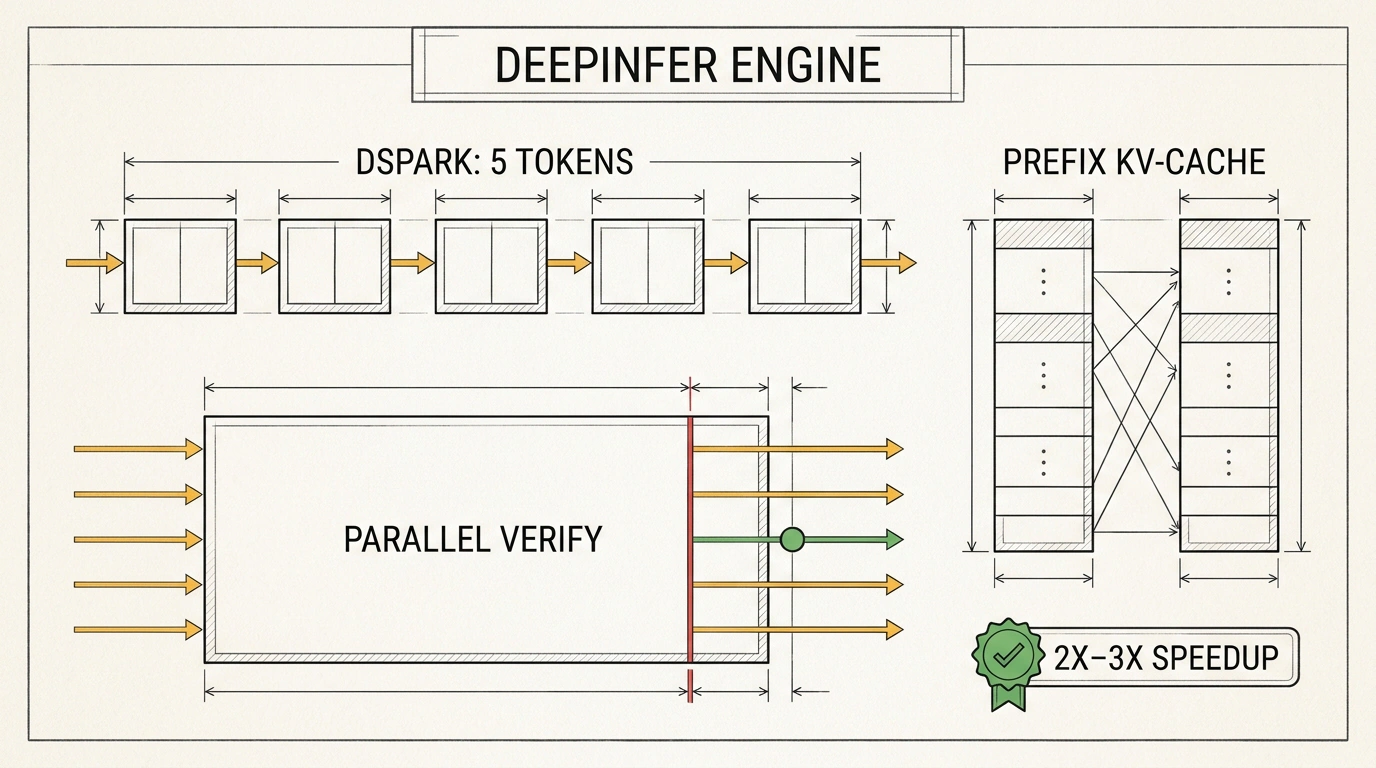

Если ты запускал большие языковые модели локально или через открытые API, то наверняка знаешь главную боль кодинг-ассистентов: мучительное ожидание первого токена и унылая посимвольная печать ответа. Когда тебе нужно быстро сгенерировать микросервис или протестировать гипотезу в терминале, скорость в 30–40 токенов в секунду превращает работу в испытание терпения. Долгое время казалось, что бешеная скорость (сотни токенов в секунду) — это эксклюзивная привилегия закрытых аппаратных провайдеров вроде Groq или Cerebras с их сверхдорогими специализированными чипами.
Но китайская исследовательская лаборатория DeepSeek в очередной раз смешала карты гигантам индустрии. Команда выложила в открытый доступ под свободной лицензией Apache 2.0 исходный код своего производственного серверного движка DeepInfer, а заодно выкатила оптимизированный чекпоинт модели DeepSeek V4.1 Flash (сборка 1017), заточенный под автономную генерацию кода.
Я внимательно покопался в кодовой базе репозитория, и сегодня мы разберем две ключевые архитектурные хитрости, позволившие DeepSeek обогнать классические серверные движки, а также посмотрим, как развернуть этот стек на собственном оборудовании.
Проблема авторегрессионного тупика: почему стандартные LLM тормозят
Чтобы понять, в чем прорыв DeepInfer, давай вспомним, как работает классическая языковая модель. Архитектура Transformer по своей природе авторегрессионна: чтобы выдать следующий токен, модель должна прогнать через все свои слои весь предыдущий контекст.
Один шаг генерации — один токен. Модель тратит гигантские вычислительные мощности видеокарты на то, чтобы загрузить триллионы весов из медленной видеопамяти VRAM в быстрые регистры чипа ради предсказания одного-единственного символа или короткого слога. В результате 80% времени современные ускорители NVIDIA попросту простаивают в ожидании пересылки данных по шине памяти. Это фундаментальное бутылочное горлышко (Memory-Bound Bottleneck), о которое разбиваются все наивные попытки ускорения.
Вторая беда агентных систем — длинный повторяющийся контекст. Когда кодинг-агент делает десятки итераций, он каждый раз отправляет в модель системный промпт, правила проекта, документацию и историю правок. В стандартных движках видеокарта вынуждена заново пересчитывать математическое внимание для этих неизменных сотен тысяч токенов, сжигая вычислительные циклы впустую.
Две пружины DeepInfer: спекулятивный DSpark и умный KV-кэш
Инженеры DeepSeek решили обе эти проблемы на уровне архитектуры инференс-сервера.
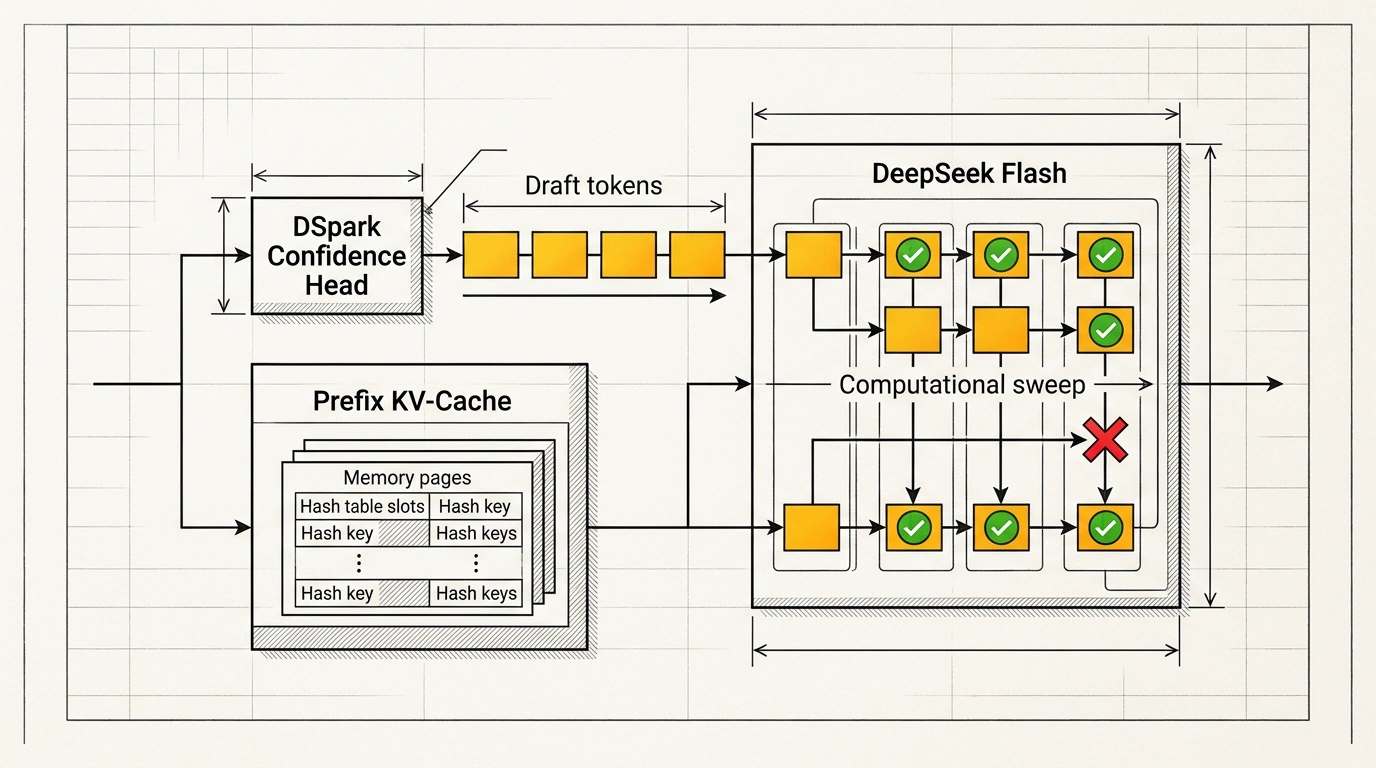
Первая пружина — спекулятивное декодирование DSpark (Speculative Decoding).
Вместо того чтобы гонять тяжелую основную модель ради каждого токена, в движок встроена легковесная голова предсказания (Confidence Head). Она работает почти мгновенно и генерирует сразу пачку из 3–5 черновых токенов (Draft Tokens). Например, в коде после ключевого слова def почти наверняка пойдет пробел и название функции, а после return — переменная.
Затем основная тяжелая модель делает всего один прямой вычислительный проход и параллельно верифицирует всю пачку предложенных токенов. Если черновая голова угадала 4 токена из 5, система принимает их все за один такт! Задержка генерации падает в 2–3 раза при сохранении 100% математической точности тяжелой модели.
Вторая пружина — префиксный KV-кэш без повторного чтения (KV-Cache Prefix Sharing). Движок DeepInfer разбивает память ключей и значений (KV-кэш) на страницы и хеширует неизменяемый системный префикс. Когда агент отправляет очередной запрос, движок мгновенно подтягивает уже готовые вычисления из памяти, считывая только дельту последнего сообщения. Это сокращает объем вычислений на агентных пайплайнах почти на 50%.
Как мы уже разбирали в материале об открытом движке DeepInfer и модели Flash 1017, сочетание этих подходов позволяет выжимать максимум производительности из стандартных серверных графических карт.
Развертывание производственного сервера DeepInfer
Серверная часть DeepInfer написана на чистом C++ с оптимизированными ядрами CUDA и поддерживает как серверные ускорители NVIDIA (A100, H100, B200), так и NPU-чипы Huawei Ascend.
Вот пример боевой команды запуска инференс-сервера с активированным спекулятивным движком DSpark и распределением на 4 видеокарты:
# Запуск производственного сервера DeepInfer для DeepSeek-V4.1-Flash-1017
python3 -m deepinfer.entrypoints.openai.api_server \
  --model deepseek-ai/deepseek-v4.1-flash-1017 \
  --speculative-engine dspark \
  --speculative-draft-tokens 5 \
  --speculative-confidence-threshold 0.85 \
  --kv-cache-prefix-caching \
  --max-model-len 131072 \
  --tensor-parallel-size 4 \
  --port 8000
Обрати внимание на флаг --speculative-confidence-threshold 0.85: он задает порог уверенности черновой головы. Если вероятность предсказания падает ниже 85%, система не рискует и мгновенно переключается на стандартный режим, предотвращая лишние откаты.
А вот как выглядит клиентский вызов развернутого эндпоинта через стандартную библиотеку OpenAI на Python:
"""
Вызов инференс-сервера DeepInfer с активированным DSpark.
Получение сгенерированного кода со сверхнизкой задержкой первого токена (TTFT).
"""
from openai import OpenAI

client = OpenAI(
    base_url="http://localhost:8000/v1",
    api_key="deepinfer-local-token"
)

response = client.chat.completions.create(
    model="deepseek-v4.1-flash-1017",
    messages=[
        {"role": "system", "content": "You are an expert autonomous software engineer."},
        {"role": "user", "content": "Напиши автономный микросервис на Go для мониторинга KV-кэша инференс-сервера."}
    ],
    temperature=0.2,
    max_tokens=2048
)

print(response.choices[0].message.content)
При генерации строго типизированного кода (Go, Rust, TypeScript) порог уверенности --speculative-confidence-threshold можно смело снижать до 0.75: за счет предсказуемости синтаксиса процент принятых токенов вырастает до 80–90%, обеспечивая максимальную скорость потока.
Чекпоинт Flash 1017 в бою: связка с OpenCode
Сам по себе быстрый движок бесполезен без модели, способной писать качественный код без синтаксических сбоев. Обновленный чекпоинт DeepSeek V4.1 Flash (сборка 1017) оптимизирован специально для автономных сред разработки вроде OpenCode.
С контекстным окном до 1 млн токенов модель демонстрирует впечатляющие результаты в синтетической сборке full-stack приложений. В тестовых сценариях по одной текстовой инструкции модель за один присест генерирует:
- Рабочий клон тетриса на чистом JavaScript с плавной анимацией и обработкой счета;
- Интерактивные трехмерные сцены на Three.js/WebGL без багов рендеринга;
- Полноценные REST API микросервисы на Go с автоматической генерацией Swagger-документации.
Как показано в исследовании об экосистеме OpenCode, открытый стек кодинга вплотную приблизился к проприетарным флагманам, обеспечивая при этом десятикратную экономию на стоимости токенов.
Аппаратная реальность: о чем молчат бенчмарки
При всей привлекательности открытого релиза важно отдавать себе отчет в системных требованиях:
- Объем видеопамяти. Для удержания модели V4.1 Flash вместе с контекстом в 131k токенов и KV-кэшем требуется не менее двух карт уровня NVIDIA RTX 4090 (48 ГБ суммарно) в квантованном виде либо серверная карта уровня A100/H100 на 80 ГБ для работы в полном FP16.
- Падение скорости на сложных алгоритмах. Спекулятивное декодирование дает максимальный эффект на предсказуемом синтаксисе (бойлерплейт, верстка, типовые CRUD-запросы). На сложных математических формулах или нестандартных алгоритмах черновая голова ошибается чаще, и выигрыш в скорости снижается до скромных 20–30%.
Тем не менее, шаг DeepSeek имеет колоссальное значение для всей индустрии: передовые алгоритмы инференса больше не заперты за проприетарными облачными воротами. Любая команда может развернуть скоростной кодинг-контур на собственном железе.