
Ты задумывался, насколько расточительно и нелепо мы используем современные большие языковые модели? Представь сценарий: автоматизированной производственной линии или агентному пайплайну нужно ответить на элементарный вопрос — «Безопасно ли пускать этот пул-реквест в прод?» или «Есть ли дефект на снимке детали?». Вместо того чтобы выдать одно число или ответ «да/нет», тяжелая трансформерная модель начинает посимвольно генерировать пространный текст: «Здравствуйте! Проанализировав предоставленный фрагмент кода, я прихожу к выводу, что...».
На эту бессмысленную генерацию слов уходят сотни миллисекунд драгоценного времени и миллионы ватт энергии. Мы забиваем микроскопом гвозди просто потому, что привыкли к авторегрессионным чат-ботам.
Но стартап Liquid AI, созданный выходцами из лаборатории CSAIL Массачусетского технологического института (MIT) под руководством Рамина Хасани, предложил радикальный выход из этого тупика. Их новая мультимодальная модель d1-ultra принадлежит к принципиально иному классу систем — это не генеративная модель, а модель принятия решений (Decision Model). У нее параметр output_tokens буквально равен нулю.
Я внимательно изучил архитектуру этой модели и результаты в бенчмарках, чтобы показать тебе, почему динамические нейросети могут стать главным арбитром в автономных системах будущего.
Квадратичное проклятие внимания: почему трансформеры уперлись в стену
Все современные LLM — от GPT-4 до Claude и Gemini — построены на архитектуре Transformer и механизме внимания (Self-Attention). Этот механизм великолепен для улавливания контекста, но у него есть фатальный математический изъян: квадратичная вычислительная сложность $O(N^2)$.
Если ты удваиваешь длину входного контекста, объем необходимых вычислений и памяти под кэш внимания возрастает в четыре раза. Если увеличиваешь в десять раз — в сто раз. Когда дело касается непрерывных потоков данных (видеопоток с камер безопасности, телеметрия автопилота или миллионы строк логов сервера), трансформеры моментально задыхаются.
Команда Liquid AI пошла другим путем: они заменили дискретные матрицы внимания на «жидкие нейросети» (Liquid Neural Networks, LNN) и непрерывные пространства состояний (Continuous-Time State Space Models). Их математический аппарат опирается на дифференциальные уравнения с динамическими коэффициентами. Поведение нейронов адаптируется к поступающим данным «на лету», как жидкость, огибающая препятствие.
Главное вычислительное следствие этого перехода: сложность обработки последовательностей падает с квадратичной до линейной или субквадратичной $O(N)$. Модель может непрерывно считывать бесконечный поток информации с постоянной скоростью и фиксированным расходом памяти.
Анатомия Decision Model: когда слова не нужны
Модель d1-ultra устроена так, что она в принципе не способна генерировать текст. Она принимает на вход текст, изображение или их комбинацию, пропускает через динамическую сеть и за один прямой проход возвращает скалярное решение или распределение вероятностей.
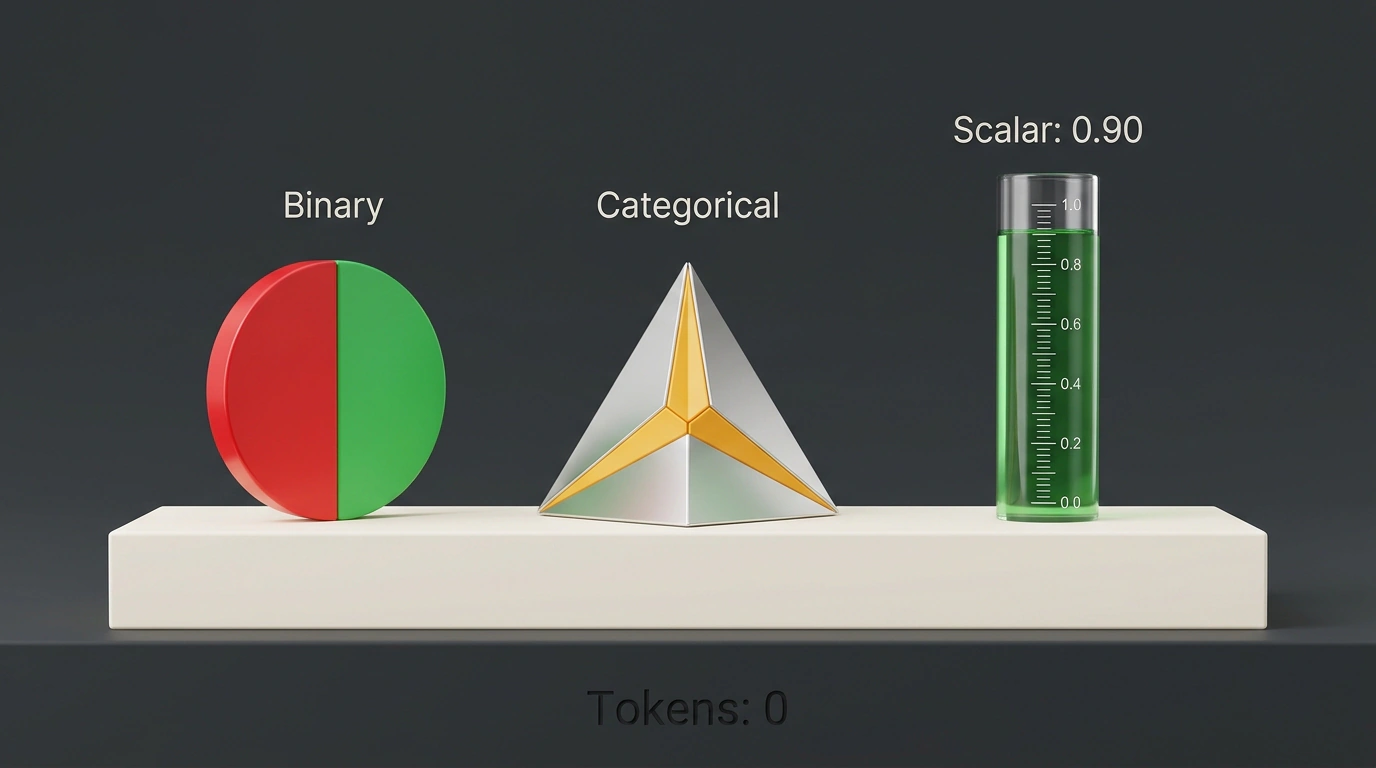
Архитектура поддерживает три базовых типа запросов:
- Бинарный выбор (Binary Decision): четкий ответ Да/Нет с оценкой риска (например, есть ли утечка секретов в коммите).
- Дискретный выбор (Categorical Choice): выбор оптимальной категории из заданного списка без необходимости парсить текстовый ответ регуляторными выражениями.
- Калиброванная шкала (Calibrated Scalar): численная оценка уверенности от 0.0 до 1.0 (например, степень соответствия резюме требованиям вакансии).
Посмотри на практический пример вызова Decision Engine через Python:
"""
Интеграция с Liquid AI Decision Engine.
Модель оценивает пригодность pull request к автоматическому слиянию
и возвращает калиброванную вероятность без генерации текстовых токенов.
"""
import requests
import json

API_URL = "https://api.liquid.ai/v1/decide"
API_KEY = "lqd_live_sample_token"

payload = {
    "model": "d1-ultra",
    "inputs": {
        "text": "PR #402: Refactored database connection pooling. Added retry logic for transient timeouts. All 142 unit tests passed. No schema migrations.",
        "question": "Безопасно ли выполнять автоматический deploy в production без ручного аппрува лида?",
        "decision_type": "binary",
        "confidence_threshold": 0.90
    }
}

headers = {
    "Authorization": f"Bearer {API_KEY}",
    "Content-Type": "application/json"
}

response = requests.post(API_URL, json=payload, headers=headers)
result = response.json()

# Модель возвращает результат с нулевым расходом output-токенов
print(f"Вердикт: {result['decision']}")
print(f"Уверенность: {result['confidence']:.4f}")
print(f"Потреблено токенов: Вход={result['usage']['input_tokens']}, Выход={result['usage']['output_tokens']}")
Обрати внимание на последнюю строчку: output_tokens: 0. Ты не платишь за генерацию слов и не ждешь, пока модель закончит печатать вводные фразы. Ответ приходит за считанные миллисекунды.
А вот пример мультимодальной оценки дефектов на промышленном конвейере:
"""
Оценка дефекта изделия по фото и описанию допуска в d1-ultra.
"""
import base64
import requests

def check_component_defect(image_bytes: bytes, tolerance_rule: str) -> dict:
    b64_img = base64.b64encode(image_bytes).decode('utf-8')
    data = {
        "model": "d1-ultra",
        "inputs": {
            "image": f"data:image/jpeg;base64,{b64_img}",
            "text": tolerance_rule,
            "question": "Присутствуют ли микротрещины на поверхности кристалла?",
            "decision_type": "binary"
        }
    }
    res = requests.post(
        "https://api.liquid.ai/v1/decide",
        json=data,
        headers={"Authorization": "Bearer lqd_live_sample_token"}
    )
    return res.json()
Классическая LLM обучена предсказывать следующий наиболее вероятный токен в предложении, что провоцирует болтливость и ложную уверенность (overconfidence). Модель решений d1-ultra обучается на минимизацию ошибки прогноза целевого исхода, обеспечивая честную математическую калибровку вероятностей.
Рекорд в Artificial Analysis Decision Index и победа над самонадеянностью
Главный бич традиционных нейросетей при оценке рисков — патологическая самонадеянность. Чат-бот может с уверенностью 99% заявлять полную чушь, вводя автоматические пайплайны в заблуждение.
В бенчмарке Artificial Analysis Decision Index модель d1-ultra набрала около 65 баллов, опередив ближайшего специализированного соперника (линейку Jev от TypeSafe) более чем на 8 пунктов.
Но важнее другое: d1-ultra продемонстрировала практически идеальную калибровку вероятностей. Если модель указывает вероятность ошибки 85%, это означает, что в реальной выборке из ста подобных ситуаций ошибка действительно возникает ровно в 85 случаях. Для финансового скоринга, медицинской сортировки и контроля качества это критически важный фактор надежности.
Экономика инференса при этом меняется кардинально: стоимость API составляет порядка $0.042 за миллион входных токенов при нулевой стоимости выходных. В линейку Liquid AI входят флагман D1 Ultra, сбалансированная D1 Base, сверхлегкая 3B для периферийных устройств и мультимодальная Omni.
Как мы подробно обсуждали в статье о моделях принятия решений для ИИ-агентов, разделение ролей на «генератора» и «судью-арбитра» становится золотым стандартом надежной автоматизации.
Границы применимости: для чего Liquid AI не подходит
При всем восторге от архитектурной элегантности LNN важно помнить о четких границах инструмента:
- Полная непригодность для генерации контента. Модель d1-ultra не напишет тебе статью, не придумает креативный сценарий и не поддержит разговор по душам. Это чисто аналитический вычислительный блок.
- Специфика серверного окружения. Существующие библиотеки оптимизации инференса (vLLM, TensorRT-LLM) заточены под внимание трансформеров. Для запуска жидких нейросетей на собственных серверах требуются специализированные ядра от Liquid AI.
Идеальное место для d1-ultra в современной архитектуре — роль мгновенного арбитра (Judge) и маршрутизатора в агентных фабриках. Пока большие генеративные модели пишут код, d1-ultra за миллисекунды и доли цента проверяет безопасность, отсеивает галлюцинации и принимает объективные решения.