
Если ты хоть раз пробовал решать реальные баги из продакшна с помощью открытых нейросетей, то прекрасно знаешь горькую правду: локальные модели бодро писали простые скрипты на Python, но стоило столкнуть их с многофайловым репозиторием и запутанной архитектурой, как они мгновенно расписывались в собственном бессилии. Престижный бенчмарк реального программирования SWE-bench Verified долго оставался неприступной крепостью гигантов: планка выше 80% покорялась исключительно закрытым проприетарным сетям (Claude 3.5 Sonnet, OpenAI o1, GPT-4o), заставляя бизнес отдавать свои исходники в чужие облака.
Релиз модели Ornith 1.5-122B под свободной лицензией MIT перевернул правила игры. Архитектура разреженной смеси экспертов (Sparse MoE) не просто дотянулась до лидеров, показав рекордные 84.5% на SWE-bench Verified, но и сделала это с прицелом на запуск на единственном графическом ускорителе.
Внутренняя кухня: архитектура MoE и петля самообучения
Разработчики Ornith применили подход, позволивший обойти ограничения классических «плотных» (dense) сетей:
- Смесь экспертов (Mixture of Experts): номинальный объем модели составляет 122 миллиарда параметров (~125B). Однако благодаря разреженной активации для обработки каждого отдельного токена задействуется лишь специализированная подгруппа весов. Это сохраняет колоссальную эрудицию модели без чудовищных требований к вычислительной мощности на шаге генерации.
- Гигантский контекст: контекстное окно расширено до 262,000 токенов (262K). В такую память без труда помещается ядро среднего веб-сервиса со всеми вспомогательными модулями и тестами.
- Автономный цикл самообучения (Self-Training Loop): модель училась программировать не по учебникам. В замкнутом цикле сеть сама генерировала программные задачи разного уровня сложности, создавала обвязку автоматических тестов (test scaffolding), генерировала десятки вариантов решений (rollouts), запускала их и обновляла веса через обучение с подкреплением (RL) на основе результатов прохождения тестов.
Результаты на независимых замерах подтверждают зрелость:
- SWE-bench Verified: 84.5%;
- SWE-bench Pro (no-hack): 76.9% (для сравнения: средний уровень открытых моделей прошлого поколения держался в районе 44%);
- TerminalBench 2.1: 81.2% при работе со сложными консольными сценариями.
Практический запуск: поднимаем сервер на одной карте
В исходной точности (FP16/BF16) для запуска 122B параметров по-прежнему требуется серверная ферма из 4 карт уровня A100. Но ключевое инженерное достоинство Ornith 1.5 раскрывается при 4-битном квантовании (AWQ): модель комфортно помещается в память единственной профессиональной видеокарты с 48 ГБ VRAM (например, NVIDIA RTX 6000 Ada) или H100 (80 ГБ).
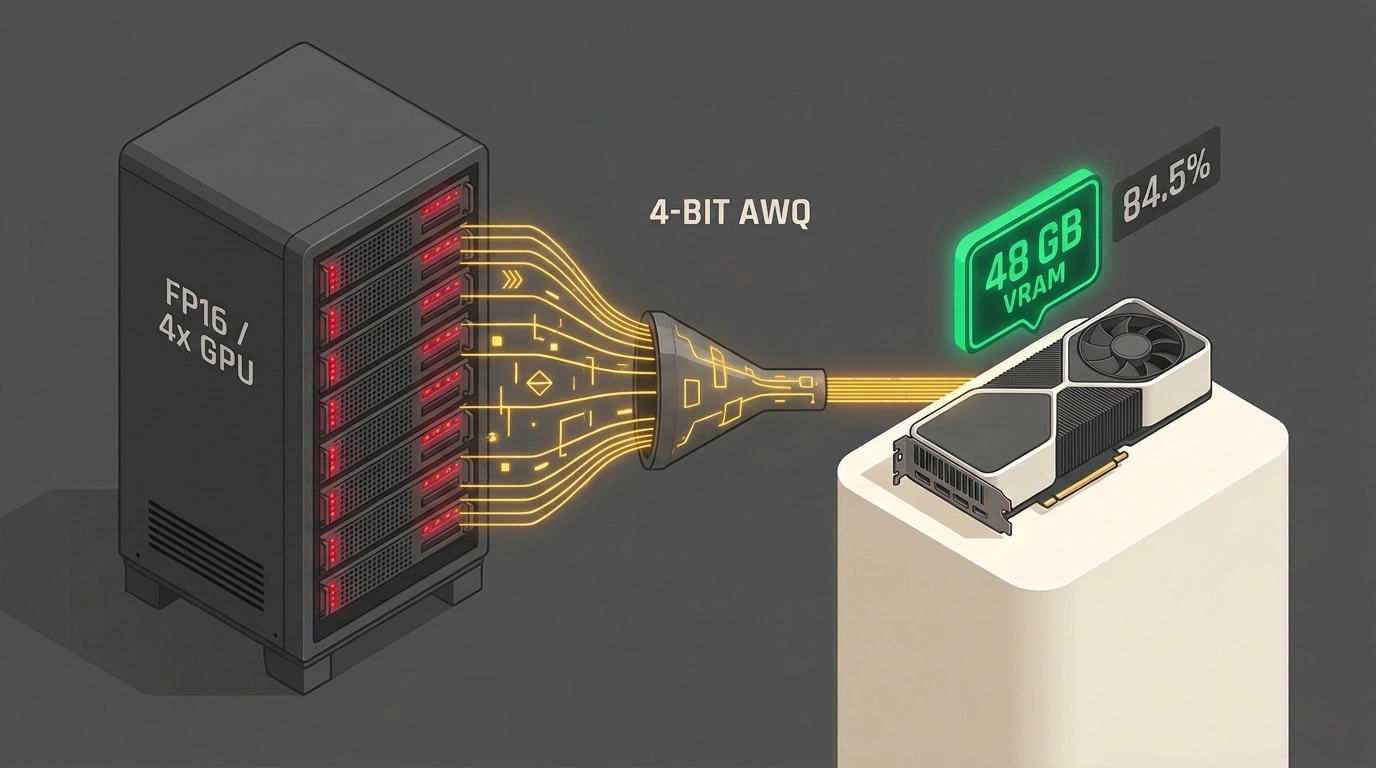
Вот как выглядит запуск OpenAI-совместимого сервера через движок vLLM:
# Запуск инференс-сервера Ornith 1.5 с квантованием AWQ на одном GPU
python3 -m vllm.entrypoints.openai.api_server \
    --model ornith/ornith-1.5-122b-awq \
    --tensor-parallel-size 1 \
    --gpu-memory-utilization 0.95 \
    --max-model-len 131072 \
    --trust-remote-code \
    --port 8000
После старта сервера ты можешь подключить его к любому агентному клиенту (Cursor, OpenCode или скрипту на Python) как стандартный эндпоинт:
from openai import OpenAI

# Подключение к локальному серверу инференса
client = OpenAI(base_url="http://localhost:8000/v1", api_key="local-token")

prompt = """Fix the regression in django/db/models/sql/query.py:
The clone() method incorrectly shares internal join aliases when subqueries are chained.
Return minimal unified diff format only."""

response = client.chat.completions.create(
    model="ornith-1.5-122b-awq",
    messages=[
        {"role": "system", "content": "You are Ornith 1.5, an expert software engineering model. Produce production-ready diff patches."},
        {"role": "user", "content": prompt}
    ],
    temperature=0.0,
    max_tokens=4096
)

print(response.choices[0].message.content)
При 4-битном квантовании на редких диалектах SQL или малораспространенных языках вроде Haskell может наблюдаться легкая деградация точности. Для мейнстримных стеков (Python, TypeScript, Go, Rust) качество генерации диффов остается на уровне старших облачных сетей.
В контексте развития терминальных сред, о которых мы говорили в обзоре экосистемы OpenCode 2.0, выход Ornith 1.5 — это настоящий тектонический сдвиг. Компании больше не обязаны платить за каждый токен проприетарным облакам: мощный кодинг-агент промышленного уровня теперь спокойно помещается в закрытом серверном контуре.