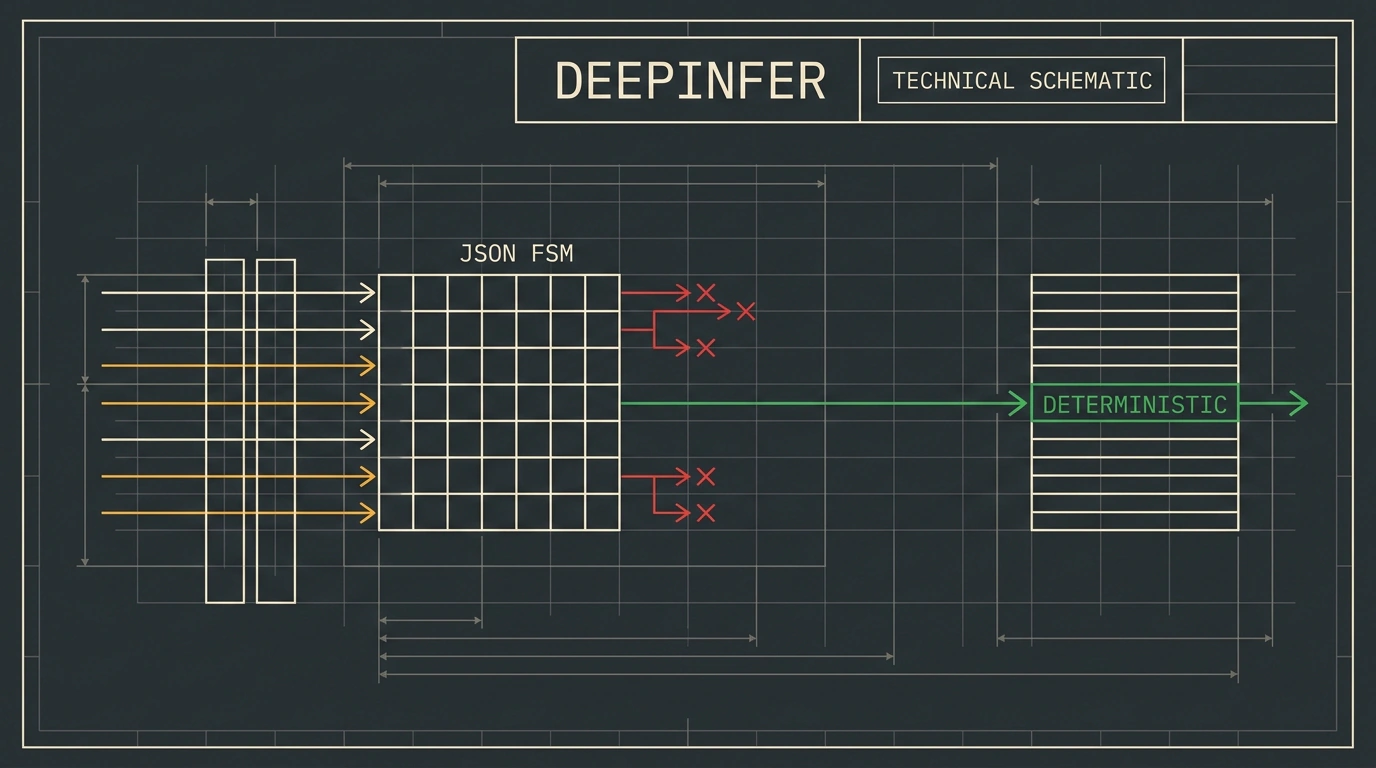

Каждый бэкенд-инженер, пытавшийся внедрить языковую модель в строгий программный конвейер, не понаслышке знает главную боль генеративного ИИ: вероятностную непредсказуемость. Ты выставляешь параметр temperature=0, фиксируешь seed, описываешь строгую схему ответа — а через сотню запросов сервер падает с ошибкой парсинга JSON, потому что модель внезапно пропустила закрывающую фигурную скобку или выдала текст перед валидным объектом. Хуже того: при динамическом батчинге на GPU один и тот же запрос выдает разные токены в зависимости от того, сколько чужих запросов обрабатывалось на видеокарте в ту же миллисекунду.
Исследовательская лаборатория DeepSeek выкатила масштабное обновление своего открытого движка инференса DeepInfer, призванное раз и навсегда закрыть эти фундаментальные компромиссы при самостоятельном хостинге моделей (в первую очередь скоростной DeepSeek V4.1 Flash).
Детерминизм без оглядки на батчинг
Главное архитектурное новшество — режим математической независимости от размера батча (Batch-Invariant Inference), активируемый переменной окружения DEEPINFER_BATCH_INVARIANT=1.
В классических движках инференса параллельные запросы объединяются в динамические группы ради утилизации ядер GPU. Однако операции с плавающей точкой (FP16/BF16) не ассоциативны: порядок суммирования векторов в ядре внимания меняется в зависимости от соседних запросов в батче. DeepInfer переработал низкоуровневые CUDA-ядра так, что при фиксированном seed ответ модели на заданный промпт гарантированно бит в бит совпадает, независимо от того, нагружен ли сервер одним запросом или разрывается под сотней параллельных обращений.
Грамматическое декодирование: модель физически не может выдать битый JSON
Второе фундаментальное улучшение — аппаратное грамматическое декодирование (Grammar-Guided Decoding). Вместо того чтобы надеяться на послушание модели и парсить сырой текст через внешние библиотеки Python на процессоре, схема компилируется в конечный автомат (FSM) прямо в памяти видеокарты.
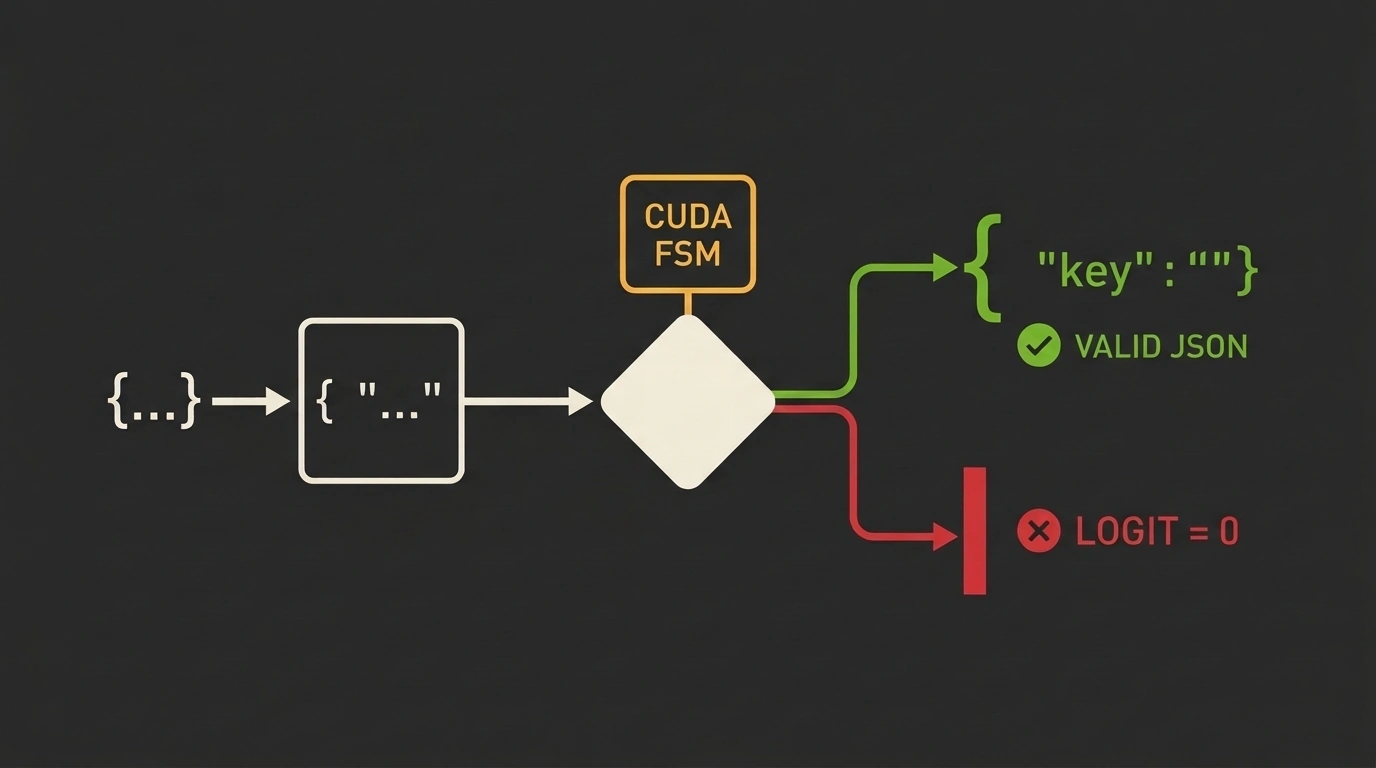
На каждом шаге предсказания следующего токена движок накладывает маску на логиты: токены, нарушающие синтаксис переданной JSON-схемы, физически получают нулевую вероятность генерации. Если по схеме ожидается число, модель технически не способна сгенерировать букву или кавычку.
Вот как выглядит запуск сервера DeepInfer с аппаратным ускорением грамматик и гарантией детерминизма:
# Запуск инференс-сервера DeepInfer с аппаратным контролем схем
export DEEPINFER_BATCH_INVARIANT=1
export CUDA_VISIBLE_DEVICES=0

python3 -m deepinfer.server \
    --model deepseek-ai/DeepSeek-V4.1-Flash \
    --max-batch-size 64 \
    --grammar-acceleration cuda \
    --port 8080
А вот пример клиентского запроса на Python, где в API передается строгая JSON-схема классификации входящего обращения в техподдержку:
import requests

# Определение ожидаемой схемы структурированного ответа
support_schema = {
    "type": "object",
    "properties": {
        "intent": {"type": "string", "enum": ["billing", "technical", "feature_request"]},
        "priority": {"type": "integer", "minimum": 1, "maximum": 5},
        "order_id": {"type": ["string", "null"]}
    },
    "required": ["intent", "priority", "order_id"]
}

payload = {
    "prompt": "Ticket: Не проходит оплата продления сервера #ORD-7711, помогите срочно!",
    "temperature": 0.0,
    "seed": 1337,
    "structured_output": {
        "schema_type": "json",
        "schema": support_schema
    }
}

response = requests.post("http://localhost:8080/v1/generate", json=payload)
print(response.json()["text"])
# Вывод гарантированно соответствует схеме:
# {"intent": "billing", "priority": 5, "order_id": "ORD-7711"}
Включение флага DEEPINFER_BATCH_INVARIANT=1 отключает режим спекулятивного предсказания нескольких токенов (Multi-Token Prediction), что снижает пиковую скорость генерации примерно на 10–15%. Для агентных цепочек и автоматических интеграционных тестов стабильность вывода с лихвой окупает это замедление.
В дополнение к грамматикам движок получил встроенные библиотеки рецептов (Recipe Libraries) под типовые задачи: извлечение именованных сущностей (NER), валидацию SQL и трансформацию документов. Как мы отмечали в разборе архитектуры ультрабыстрого инференса DeepInfer, открытые движки перестают быть просто обертками над весами: они превращаются в отказоустойчивую промышленную инфраструктуру.