
В мире генеративного ИИ долгое время царила гигантомания. Корпорации соревновались, кто построит модель с большим количеством нулей в графе параметров: 70 миллиардов, 400 миллиардов, три триллиона. Но когда разработчик спускается с небес маркетинговых презентаций на землю реальной продуктовой разработки, он сталкивается с суровой реальностью: содержать собственный парк серверов с картами H100 безумно дорого, а публичные облачные API страдают от сетевых задержек, очередей и регулярных падений.
Что, если для большинства повседневных агентных задач — маршрутизации команд, вызова функций (function calling), парсинга JSON и классификации входящих данных — гигантские модели просто не нужны?
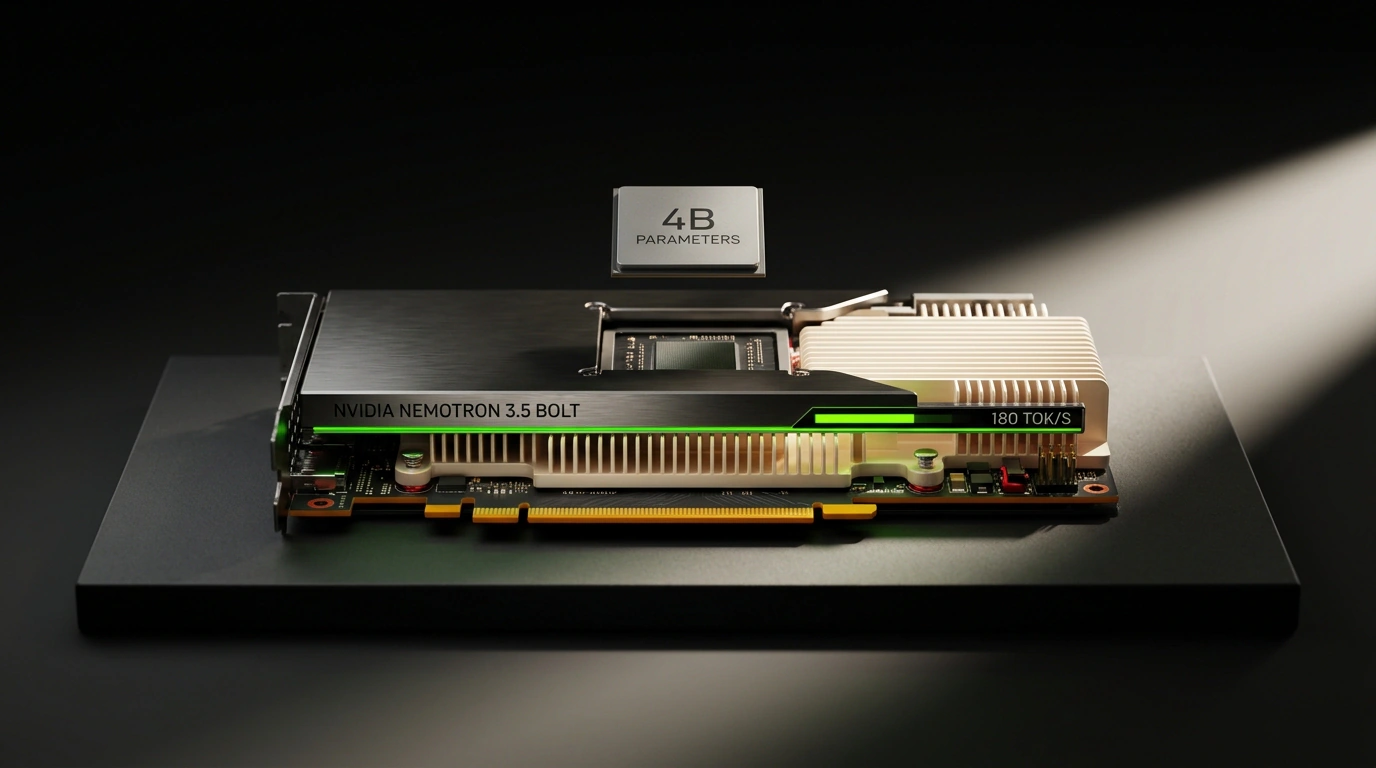
Компания NVIDIA ответила на этот вопрос релизом Nemotron 3.5 Bolt — компактной модели масштаба 4 миллиардов параметров (4B), спроектированной специально под сверхбыстрый локальный инференс на потребительских видеокартах семейства GeForce RTX. Мы уже анализировали мультимодальные возможности линейки Nemotron 3.5 Super VL и тестировали гибридные локальные архитектуры. Давайте посмотрим, на что способен 4B-малыш в реальном бою.
Маленькая модель с повадками гиганта: архитектура 4B параметров
Создать хорошую маленькую модель гораздо сложнее, чем обучить гиганта. Если в модели на 70B параметров избыточность весов прощает огрехи датасета, то в объеме 4B каждый отдельный параметр обязан нести максимальную смысловую нагрузку.
Инженеры NVIDIA применили в Nemotron 3.5 Bolt многоступенчатую процедуру дистилляции знаний (knowledge distillation) из флагманских проприетарных моделей Nemotron Ultra, подкрепив ее специализированным обучением с подкреплением на синтетических трассах вызовов инструментов (Tool Calling RL):
- Модель обучалась не на художественной литературе или бессвязных диалогах, а на миллионах примеров строгого взаимодействия с API, генерации валидного программного кода и следования системным инструкциям.
- Архитектура получила расширенный словарь токенизатора, оптимизированный под синтаксис популярных языков программирования (Python, TypeScript, Go, Rust, Bash).
- Нативная поддержка контекстного окна составляет 64 000 токенов, чего с головой хватает для удержания средних файлов документации или схем баз данных.
Запуск на потребительских картах RTX: квантование и скорость в 180 токенов
Самая приятная новость для энтузиастов и независимых разработчиков — предельно скромные требования к аппаратному обеспечению. Для запуска Nemotron 3.5 Bolt не нужны серверные стойки с жидкостным охлаждением:
- В 8-битном формате (FP8) модель занимает около 4.5 ГБ видеопамяти.
- В жестком 4-битном квантовании (INT4 / AWQ) размер весов падает до невероятных 2.6 ГБ, что позволяет запускать ее даже на бюджетных мобильных видеокартах ноутбуков уровня RTX 4050 или RTX 4060 с 6–8 ГБ VRAM.
- При запуске через специализированный движок TensorRT-LLM скорость генерации на настольной карте RTX 4070 или RTX 5070 превышает 180 токенов в секунду.
Когда текст льется на экран с такой скоростью, взаимодействие перестает ощущаться как разговор с удаленным сервером. Ответ появляется мгновенно, без малейшего намека на задержку первого токена (TTFT составляет буквально 15–25 миллисекунд).
Маршрутизация запросов и вызов функций на локальном железе
Где компактный Bolt раскрывает свой потенциал на 100%? Его коронная дисциплина — роль локального шлюза-маршрутизатора (Router & Function Caller).
Представь сложную корпоративную систему автоматизации:
- На вход поступает поток из тысяч разнородных пользовательских обращений в минуту.
- Отправлять каждый запрос в дорогую облачную модель уровня Claude Opus или GPT-6 — чистое финансовое самоубийство.
- Вместо этого на локальной машине поднимается инстанс Nemotron 3.5 Bolt.
Малыш мгновенно анализирует текст, классифицирует интент пользователя, извлекает именованные сущности (даты, суммы, номера заказов) и формирует строгий JSON-пакет для вызова внутренней бизнес-логики. В бенчмарке Berkeley Function-Calling Leaderboard (BFCL) Nemotron 3.5 Bolt показал точность генерации аргументов свыше 88%, опередив многие модели в весовой категории 14B–32B.
Если запрос оказывается тривиальным (справочный вопрос или стандартное действие), Bolt закрывает его самостоятельно. Если же задача требует глубокого философского синтеза или сложного системного планирования, Bolt аккуратно перенаправляет запрос на внешний облачный флагман.
Границы возможностей: когда 4B физически не хватает глубины
Было бы преступлением умолчать об ограничениях компактных сетей. Чудес в физике полупроводников не бывает: четыре миллиарда параметров имеют строгий физический предел емкости памяти (information capacity).
Nemotron 3.5 Bolt категорически не подходит для:
- Написания многостраничных художественных текстов, где требуется тонкое чувство стиля, скрытый подтекст и богатые литературные метафоры.
- Многошагового математического рассуждения с доказательством сложных теорем — здесь модель быстро начинает путать логические связки и выдавать правдоподобные, но ошибочные выкладки.
- Глубокого рефакторинга архитектуры проектов из десятков взаимосвязанных микросервисов.
Но от нее этого никто и не требует. Nemotron 3.5 Bolt — это великолепная, отточенная до блеска «рабочая лошадка» для локального терминала, умного дома и быстрых бессерверных микросервисов, доказывающая, что умный локальный ИИ может быть быстрым, компактным и абсолютно бесплатным в эксплуатации.