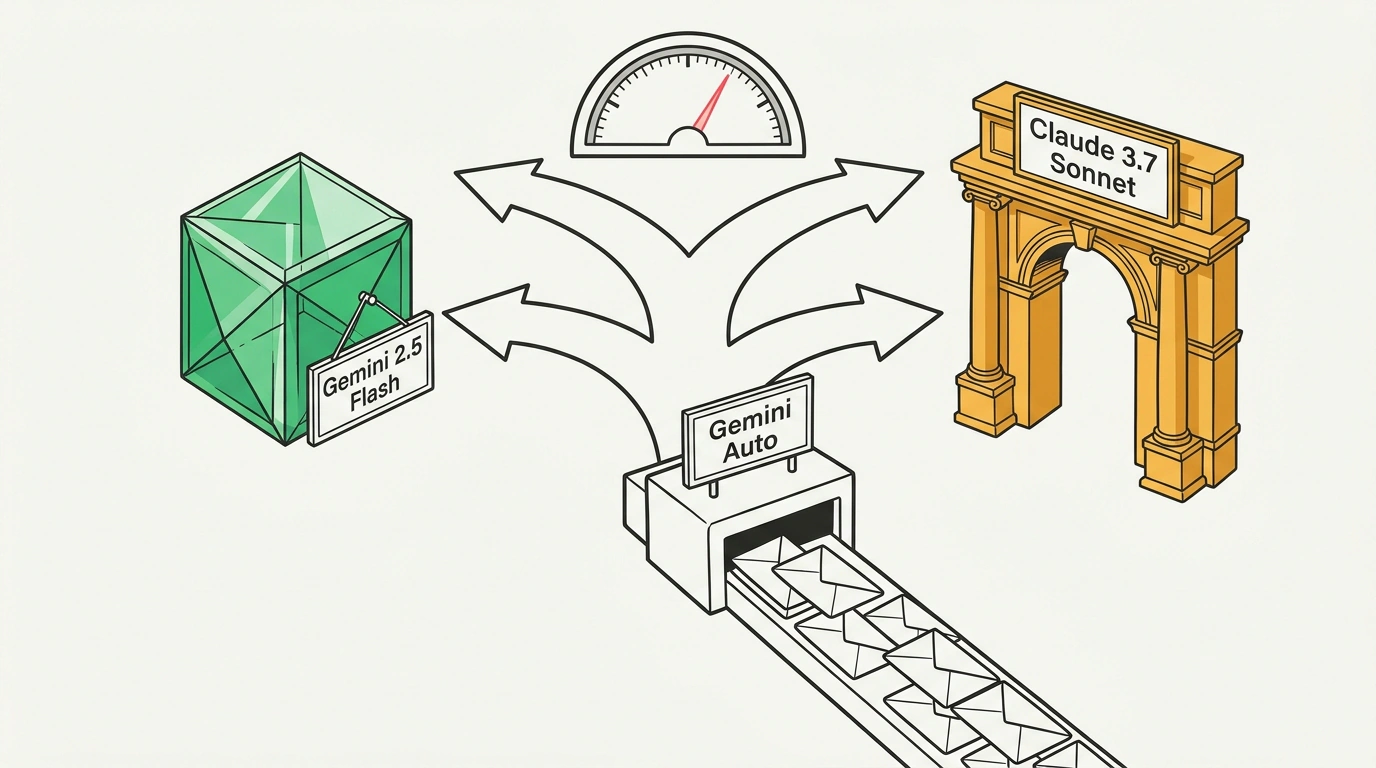

В корпоративной ИИ-разработке давно назревал кризис операционной неэффективности. Архитекторы корпоративных систем ежедневно сталкивались с неприятной дилеммой: если отправлять абсолютно все входящие запросы в самые мощные и тяжелые языковые модели (вроде Claude 3.5 Sonnet или GPT-6), бюджет компании на токены тает на глазах, а пользователи жалуются на медленные ответы в простых сценариях. Если же перевести конвейер целиком на ультралегкие и скоростные модели (вроде Gemini Flash), система начинает спотыкаться и галлюцинировать при решении сложных математических задач, глубоком аудите безопасности и архитектурном анализе кода.
На конференции Gemini at Work команда Google Cloud представила прагматичный и давно назревший ответ на этот вызов — бессерверный интеллектуальный шлюз API Gateway Model Routing с корпоративным режимом Auto Mode. Главная сенсация анонса заключается в том, что Google отказалась от монопольного продвижения исключительно собственных сетей: шлюз умеет динамически направлять входящие запросы не только на разные уровни Gemini, но и на конкурирующие флагманские модели Anthropic Claude, доступные в каталоге Vertex AI Model Garden.
Я исследовал архитектуру шлюза маршрутизации, разобрал спецификацию OpenAPI-манифеста и протестировал сценарии автоматического распределения трафика на реальных задачах. Давай посмотрим, как устроен этот умный коммутатор и как настроить динамическую балансировку моделей в своей инфраструктуре.
Как устроен серверный классификатор сложности
Вместо того чтобы заставлять разработчиков писать сложные самописные правила или обучать локальные классификаторы, режим Auto Mode выносит логику маршрутизации непосредственно на уровень управляемого бессерверного прокси-шлюза Google Cloud.
Входящий запрос анализируется за доли миллисекунды специализированной легковесной моделью-арбитром по нескольким ключевым критериям:
- Оценка семантической сложности: Простые задачи (классификация тональности, извлечение именованных сущностей, перевод текста или форматирование таблиц) немедленно уходят на скоростную модель Gemini 4 Flash;
- Длина контекста и мультимодальность: Запросы, содержащие длинные видеозаписи, сотни страниц PDF или гигантские дампы логов свыше 128,000 токенов, направляются на длинноконтекстный флагман Gemini 4 Carbon с контекстным окном до 2 миллионов токенов;
- Комплексный рефакторинг и архитектурный анализ: Если в запросе обнаружены многофайловые зависимости, требование к глубоким рассуждениям или сложному проектированию логики, шлюз плавно переключает сессию на Anthropic Claude 3.5 Sonnet.
Для клиентского приложения шлюз выглядит как обычный унифицированный эндпоинт, полностью совместимый со спецификацией OpenAI Chat Completions. Разработчикам больше не нужно вносить изменения в исходный код программ: достаточно настроить декларативный манифест.
Декларативная спецификация маршрутизации и код вызова
Правила балансировки трафика описываются через стандартную спецификацию OpenAPI 3.x с корпоративным расширением x-google-api-management:
openapi: 3.0.0
info:
  title: Enterprise AI Model Router
  version: 1.0.0
paths:
  /v1/chat/completions:
    post:
      summary: Unified Auto Routing Endpoint
      x-google-backend:
        address: https://vertexai-router.googleapis.com/v1/auto
      x-google-api-management:
        routing_strategy:
          default_model: "gemini-4-flash"
          rules:
            - match:
                intent: "code_refactor_or_complex_reasoning"
                min_complexity_score: 0.75
              target_model: "anthropic.claude-3-5-sonnet"
            - match:
                context_length_tokens_gt: 128000
              target_model: "gemini-4-carbon"
А на стороне клиентского приложения вызов унифицированного шлюза на Python выглядит предельно просто и прозрачно:
import os
from openai import OpenAI

# Подключение к шлюзу Google Cloud Vertex AI через OpenAI-совместимый интерфейс
client = OpenAI(
    base_url="https://gateway.endpoints.my-enterprise-project.cloud.goog/v1",
    api_key=os.environ["VERTEX_ROUTER_API_KEY"]
)

# Запрос с указанием модели "auto": шлюз сам выберет между Flash, Carbon и Claude
response = client.chat.completions.create(
    model="auto",
    messages=[
        {"role": "system", "content": "Ты корпоративный инженерный ассистент."},
        {"role": "user", "content": "Проанализируй этот pull request, выяви потенциальные гонки данных в горутинах и предложи архитектурный патч."}
    ],
    temperature=0.2
)

# Метаданные ответа содержат имя реально вызванной модели
actual_model = response.model
print(f"[Маршрутизатор сработал] Задача выполнена моделью: {actual_model}")
print(response.choices[0].message.content)
В заголовках ответа шлюз возвращает точное имя модели, которая выполнила генерацию, а также балл сложности, вычисленный классификатором. Это позволяет вести сквозную аналитику и при необходимости тонко корректировать пороги переключения.
Экономика и корпоративная безопасность
Внедрение режима Auto Mode приносит колоссальный финансовый эффект. В типовых корпоративных сценариях от 70% до 85% всех запросов пользователей и агентов являются относительно простыми и с легкостью закрываются дешевой моделью Gemini 4 Flash. Перевод этих потоков с тяжелых сетей снижает совокупные затраты компании на API на 60–75%.
При этом интеграция моделей Claude через инфраструктуру Google Cloud снимает главную головную боль корпоративных юристов и безопасников:
- Все запросы исполняются внутри закрытого виртуального облака компании (VPC Service Controls);
- Действуют строгие политики разграничения прав доступа Cloud IAM;
- Корпоративные данные клиентов гарантированно не используются для дообучения моделей внешними провайдерами;
- Ведется сквозной аудит всех транзакций в Cloud Audit Logs с фиксацией IP-адресов и идентификаторов пользователей.
Режим Auto в Google Gemini наглядно доказывает наступление эпохи мультимодельной прагматики: будущее принадлежит не отдельным закрытым монополиям, а умным шлюзам, способным извлекать максимум пользы из лучших мировых алгоритмов.