
Если ты следишь за развитием инструментов разработки, то наверняка помнишь тот восторг, когда в IDE впервые появился GitHub Copilot. Модель подсказывала пару строк в функции, дописывала регулярные выражения или генерировала однотипные геттеры. Это казалось будущим. Но сегодня, в конце 2026 года, попытка использовать ИИ как интерактивное автодополнение в редакторе выглядит как попытка возить бревна на спортивном болиде. Настоящая революция началась там, где человек перестал писать код руками и доверил терминал автономным агентам.
Однако здесь большинство инженеров расшибает лоб о суровую реальность. Ты даешь агенту сложную задачу, отходишь на полчаса за кофе, возвращаешься — а в репозитории царит хаос: стерты рабочие конфиги, закоммичено 80 бесполезных тестов-заглушек, контекстное окно забито мусорными логами сборщика, а логика сервиса сломана к чертям.
Инженер и серийный предприниматель Дэвид Ондрей прошел через этот ад лично. За последние три года он провел в боевом режиме более 2 500 часов чистого автономного кодинга и закрыл свыше 15 700 практических агентных сессий. На базе этой инфраструктуры он в одиночку поднял и развивает три коммерческих стартапа, отправляя в прод от 100 до 200 чистых коммитов в сутки (более 10 500 коммитов в год). Его платформа с открытым кодом Cloudroom и сопутствующая библиотека навыков аккумулируют колоссальный опыт практической агентной инженерии. Давай без корпоративного пафоса и маркетинговой шелухи разберем анатомию этой фабрики: как изолировать песочницы, фильтровать контекст, заставить Claude и модели OpenAI перепроверять друг друга и почему 90% сгенерированных нейросетями тестов нужно нещадно отправлять в корзину.
Парадигма Agentic Engineering: конец эпохи автодополнения в редакторе
Главный ментальный сдвиг, который отделяет начинающего «вайб-кодера» от системного инженера нового поколения, заключается в смене роли. Ты больше не строчишь синтаксические конструкции и не споришь с линтером. Ты выступаешь в роли технического директора и главного архитектора, управляющего фабрикой автономных разработчиков.
В классическом цикле разработки программист тратит 80% времени на механику: набор символов, вызов утилит, чтение стектрейсов, ручной поиск опечаток в JSON-схемах. В парадигме Agentic Engineering всю черновую работу забирает агент, наделенный полным доступом к окружению:
- Прямое исполнение консольных команд в шелле (сборка, запуск тестов, миграции БД).
- Чтение и модификация файлового дерева проекта.
- Навигация по документации и API через headless-браузеры.
- Параллельное ведение независимых исследовательских веток.
Модели калибра Claude Opus 5.5 от Anthropic или новейшие линейки OpenAI Astra и GPT-6.1 Sol обладают достаточной емкостью рассуждений, чтобы удерживать сложную бизнес-логику. Но если ты предоставишь агенту карт-бланш без жестких рамок и строгой изоляции, энтропия мгновенно уничтожит проект. Именно поэтому дисциплина агентной разработки требует перехода от абстрактных диалогов к детерминированным конвейерам, как это описано в аналитике автономных конвейеров и фабрик ПО.
Архитектура Cloudroom: изолированные песочницы на Rust и гигиена контекста
Чтобы агент не превратил рабочую машину в выжженную пустыню случайной командой rm -rf или некорректным дропом продакшен-базы, Дэвид Ондрей построил платформу Cloudroom. Ее ядро cloudroom-core написано на Rust и сфокусировано на сверхбыстрой виртуализации и изоляции сред.
Вместо того чтобы пускать нейросеть напрямую в хостовую операционную систему, Cloudroom разворачивает для каждой микрозадачи легковесную изолированную песочницу (sandbox). Это не тяжеловесная виртуальная машина, стартующая две минуты, а мгновенно инициализируемый контейнер с контролем системных вызовов через cgroups и seccomp. О принципах устройства таких сред мы подробно говорили в обзоре изолированных песочниц Cloudroom.
Каждая сессия описывается декларативным манифестом, строго ограничивающим ресурсы и права агента:
{
  "taskId": "task-auth-session-091",
  "runtime": "container-isolated",
  "baseImage": "node:22-bookworm-slim",
  "workingDirectory": "/workspace/service",
  "resourceLimits": {
    "memoryLimitMb": 6144,
    "cpuCores": 4,
    "maxExecutionMinutes": 45
  },
  "mountedDirectories": [
    {
      "hostPath": "./backend/src",
      "containerPath": "/workspace/service/src",
      "writeable": true
    },
    {
      "hostPath": "./backend/tests",
      "containerPath": "/workspace/service/tests",
      "writeable": true
    }
  ],
  "agentPolicy": {
    "primaryModel": "anthropic/claude-opus-5.5",
    "reviewerModel": "openai/astra-2026",
    "allowUnattendedBash": true,
    "enforceTestReproduction": true,
    "maxGeneratedTestFiles": 2
  }
}
Второй критический элемент архитектуры — жесткая гигиена контекстного окна. Самая частая причина «оглупления» больших языковых моделей на длинных дистанциях — замусоривание контекста. Представь: агент запускает сборку TypeScript-проекта, компилятор падает, и в терминал вываливается 8 000 строк простыни логов и зависимостей npm. Если запихнуть этот шум в промпт целиком, механизм внимания модели (attention) расплывается. Модель теряет нить рассуждений и начинает галлюцинировать.
В Cloudroom встроен промежуточный модуль сжатия контекста (context compaction). Он на лету парсит вывод команд, вырезает дублирующиеся стектрейсы, отсекает пути сторонних библиотек из node_modules и оставляет агенту компактную выжимку: сигнатуру сбойной функции, строку файла и конкретную ошибку типов. Чистый контекст — залог ясного мышления нейросети.
Принцип изолированных потоков: правило одного коммита
Многие новички пытаются вести с агентом один бесконечный чат: «Привет, добавь авторизацию по JWT... Отлично, а теперь почини баг в корзине... Слушай, а давай еще перепишем стили на Tailwind!». Это верный способ похоронить проект. Через три-четыре итерации модель путает контексты, забывает, какие файлы модифицировала час назад, и начинает переписывать собственный рабочий код.
В инженерном регламенте Cloudroom действует фундаментальное правило: одна атомарная задача — один изолированный поток (Thread).
Поток открывается под строго очерченную фичу или локализованный дефект:
- Если агент решает проблему утечки соединений в пуле PostgreSQL, он не имеет права трогать компоненты фронтенда.
- Если в процессе работы у инженера возникла блестящая идея отрефакторить смежный микросервис, текущая сессия немедленно форкается (
room fork), либо создается отдельный дочерний поток. - После успешного завершения задачи изменения коммитятся в изолированную ветку, а контейнер уничтожается вместе со всеми временными артефактами. Никаких хвостов и накопленного контекстного мусора.
Воспроизведение багов от первого лица и безжалостная борьба со slop-тестами
Как обычный разработчик просит ИИ починить ошибку? Копирует строчку из лога и пишет: «У меня падает сервер при вызове вебхука Stripe, почини пожалуйста». Агент тут же радостно выдает заплатку, которая закрывает конкретное условие if (data === null), но ломает всю транзакционность базы данных.
Опыт 15 700 сессий сформировал непререкаемый протокол: сквозное воспроизведение ошибки (End-to-End Reproduction). Агенту категорически запрещено прикасаться к исходному коду, пока он лично не воспроизведет проблему в изолированном рантайме.
Алгоритм выглядит так:
- Агент изучает описание бага.
- В песочнице поднимается окружение и запускается headless-браузер или curl-скрипт.
- Агент обязан воспроизвести сбой собственными действиями, зафиксировать падение и сохранить снимок ошибки (стектрейс или скриншот UI).
- Только после того, как наличие бага подтверждено объективным поведением системы, разрешается локализация в коде.
А теперь — самая больная тема: автоматизированное тестирование. Нейросети обожают писать тесты. Если дать Claude команду «напиши тесты для покрытия модуля», модель мгновенно нагенерирует 50 файлов с моками на каждую строчку.
Дэвид Ондрей называет это явление slop-тестами (мусорным кодом). Такие тесты создают иллюзию бурной деятельности: формальное покрытие растет до 98%, но в реальности эти тесты проверяют лишь то, что функция возвращает то, что ей только что скормили в моке. При малейшем рефакторинге внутрянки вся эта армия тестов с грохотом падает, заставляя команду тратить часы на починку фиктивных проверок. Пайплайны CI/CD замедляются в разы.
В Cloudroom действует жесткий лимит: агенту запрещено раздувать тестовую базу. Вместо сотен бессмысленных моков агент обязан написать ровно один или два точечных интеграционных теста, которые моделируют реальный сценарий отказа и падают до исправления бага, а после внесения правок — гарантированно проходят в зеленой зоне. Качество всегда бьет количество.
Кросс-модельное ревью: почему Claude Opus должен проверять агент OpenAI
Даже самая мощная языковая модель обладает слепыми зонами. Если Claude Opus 5.5 допустил тонкую логическую ошибку — например, оставил потенциальное состояние гонки (race condition) в асинхронном генераторе, — то при повторном вопросе «проверь свой код» он с высокой вероятностью повторит свою аргументацию. Модель влюблена в собственную логику.
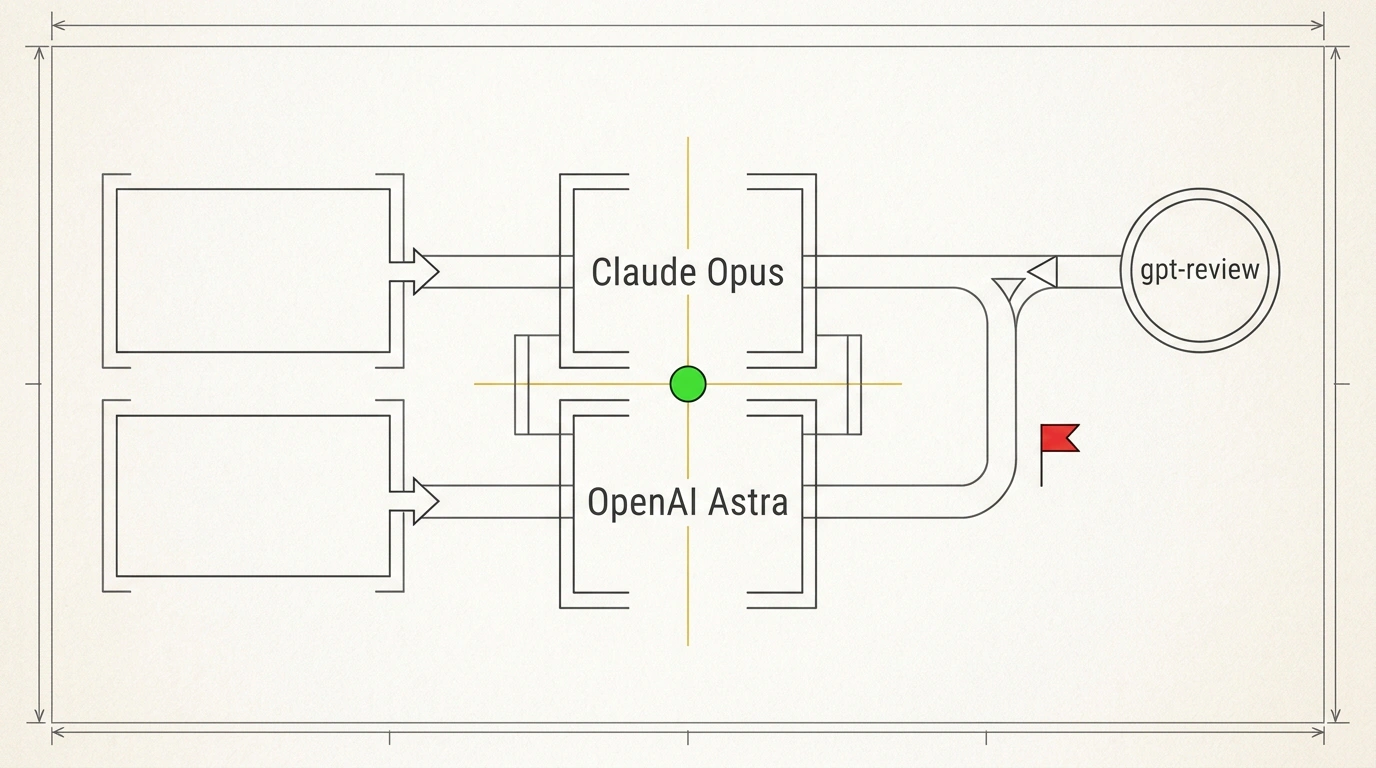
Решением проблемы стало кросс-модельное ревью (Cross-Frontier Review) через специализированный навык gpt-review из открытого репозитория davidondrej/skills.
Принцип прост и элегантен: код, сгенерированный агентом от Anthropic (Claude Opus 5.5), отправляется на ревизию независимой модели конкурентов — OpenAI Astra или GPT-6.1 Sol. Модели разных лабораторий обучались на разных датасетах, обладают различными внутренними эвристиками и не имеют общей предвзятости.
Модель-ревьюер получает сырой git-дифф и жесткий чеклист проверки:
- Потокобезопасность и параллелизм (deadlocks, race conditions).
- Утечки памяти и незакрытые дескрипторы соединений.
- Соответствие типам и корректность обработки ошибок.
- Наличие скрытого оверинжиниринга и лишних зависимостей.
По статистике Дэвида Ондрея, внедрение перекрестной верификации снижает число критических скрытых дефектов в продакшене более чем на 90%. Для наиболее ответственных модулей (биллинг, криптография, управление доступом) запускается консорциум из трех-четырех моделей с последующей автоматической дедупликацией замечаний. Именно так строятся настоящие «темные фабрики» программного кода.
Алгоритм 4x4: извлечение 16 фундаментальных решений за 3 минуты
Когда разработчик поручает агенту крупный архитектурный модуль, самая большая ошибка — ограничиться кратким ТЗ. Агент начнет додумывать детали на свой вкус, выбирая самые экзотические решения из своего датасета.
Чтобы синхронизировать видение инженера и модели до единой строчки кода, Дэвид внедрил практику предварительного брифинга по алгоритму 4x4. Навык инициирует структурированный опрос разработчика, состоящий ровно из 4 тематических блоков по 4 вопроса (всего 16 ключевых решений), который проходится за 3–4 минуты:
- Системные границы и компоненты: какие внешние API задействованы, где проходит граница ответственности сервиса, какие протоколы взаимодействия используются, как устроена схема данных.
- Инженерные компромиссы: что приоритетнее — скорость отклика или консистентность, допускается ли асинхронная обработка с задержкой, какую сложность поддержки готова нести команда.
- Производительность и отказоустойчивость: ожидаемые пиковые нагрузки (RPS), стратегия кэширования (Redis / in-memory), тайм-ауты соединений, поведение при падении смежных сервисов.
- Краевые случаи и безопасность: валидация входных данных, обработка дублирующихся запросов (идемпотентность), требования к аудиту действий и шифрованию.
Пока человек не ответит на эти 16 пунктов, агент не генерирует ни одного файла. Это начисто исключает разочарование в духе «я имел в виду совсем другое».
Практический конвейер: пошаговый цикл от форка ветки до продакшена
Давай сведем всю теорию в осязаемый практический сценарий. Представим задачу: устранить состояние гонки при начислении баланса по вебхуку платежной системы в бэкенд-сервисе.
Вот как выглядит пошаговый цикл управления в консоли Cloudroom через утилиту room CLI:
# Шаг 1. Создаем изолированный атомарный поток задачи
room thread new --title "Fix Stripe webhook race condition" --path ./backend

# Шаг 2. Воспроизводим проблему: запускаем конкурентный нагрузочный тест
room exec "npm run test:e2e:webhook-concurrency"
# [FAIL] Баланс пользователя увеличился дважды из-за отсутствия блокировки

# Шаг 3. Делегируем задачу модели Claude Opus 5.5 с предохранительным навыком
room agent execute \
  --model "anthropic/claude-opus-5.5" \
  --skill "risky-changes" \
  --prompt "Локализуй гонку в обработчике вебхука платежей. \
            Внедри блокировку на уровне строк БД (SELECT FOR UPDATE) \
            или транзакционный мьютекс. \
            Напиши ровно ОДИН регрессионный тест, подтверждающий атомарность."

# Шаг 4. Отправляем полученный дифф на кросс-модельное ревью в OpenAI Astra
room review \
  --with "openai/astra-2026" \
  --criteria "concurrency,row-level-locks,deadlocks" \
  --strict

# Шаг 5. Финальный прогон линтеров, сборки и регрессионных тестов в контейнере
room exec "npm run typecheck && npm test"
# [PASS] Все 12 интеграционных тестов завершены успешно за 4.2с

# Шаг 6. Фиксация коммита и закрытие потока
room commit -m "fix(billing): eliminate concurrent webhook balance race condition"
room thread close --archive
Обрати внимание на эргономику: разработчик не правит код руками, но держит под абсолютным контролем каждый критический рубеж: постановку задачи, воспроизведение сбоя, архитектурные рамки, независимый аудит и результаты тестов.
Экономика токенов, пределы автономии и ликвидация скрытого техдолга
Один из частых вопросов скептиков: сколько стоит такой подход? Не разорит ли компанию бесконечный вызов топовых моделей с миллионными контекстными окнами?
Опыт 15 700 сессий дает однозначный ответ: экономить на моделях в агентной разработке — самое дорогое удовольствие. Попытки использовать удешевленные и урезанные модели (Claude Haiku, GPT-4o-mini, Gemini Flash) в сложных архитектурных задачах приводят к тому, что инженер тратит 90% своего времени на исправление глупых ошибок, ручной разбор зацикливаний и бесконечные перепромпты. Время квалифицированного разработчика стоит несоизмеримо дороже API-токенов.
Топовые тарифы (Claude Max за $200 в месяц или аккаунты OpenAI Pro) окупаются в первые же дни, позволяя одному специалисту выполнять объем работы небольшого аутсорс-отдела из 5–7 человек.
Однако у парадигмы есть четко очерченные границы применимости:
- Легаси-монолиты без модульности. Если в проекте нет тестов, нет вменяемой архитектуры, а файл
server.jsсодержит 40 000 строк спагетти-кода без типизации, любой автономный агент захлебнется в контексте и наломает дров. - Сверхжесткие регуляторные ограничения. В банковских системах высшей категории надежности и закрытых военных контурах передача кода во внешние облачные API фронтирных моделей строго запрещена политиками безопасности.
Во всех остальных сценариях — от динамичных стартапов до продуктовой разработки в зрелых IT-компаниях — агентная инженерия уже перестала быть диковинным экспериментом. Это новый индустриальный стандарт. Тот, кто сегодня освоит изоляцию песочниц, гигиену контекста и кросс-модельный аудит, завтра будет управлять армией алгоритмов, пока конкуренты продолжают вручную выискивать пропущенные точки с запятой.