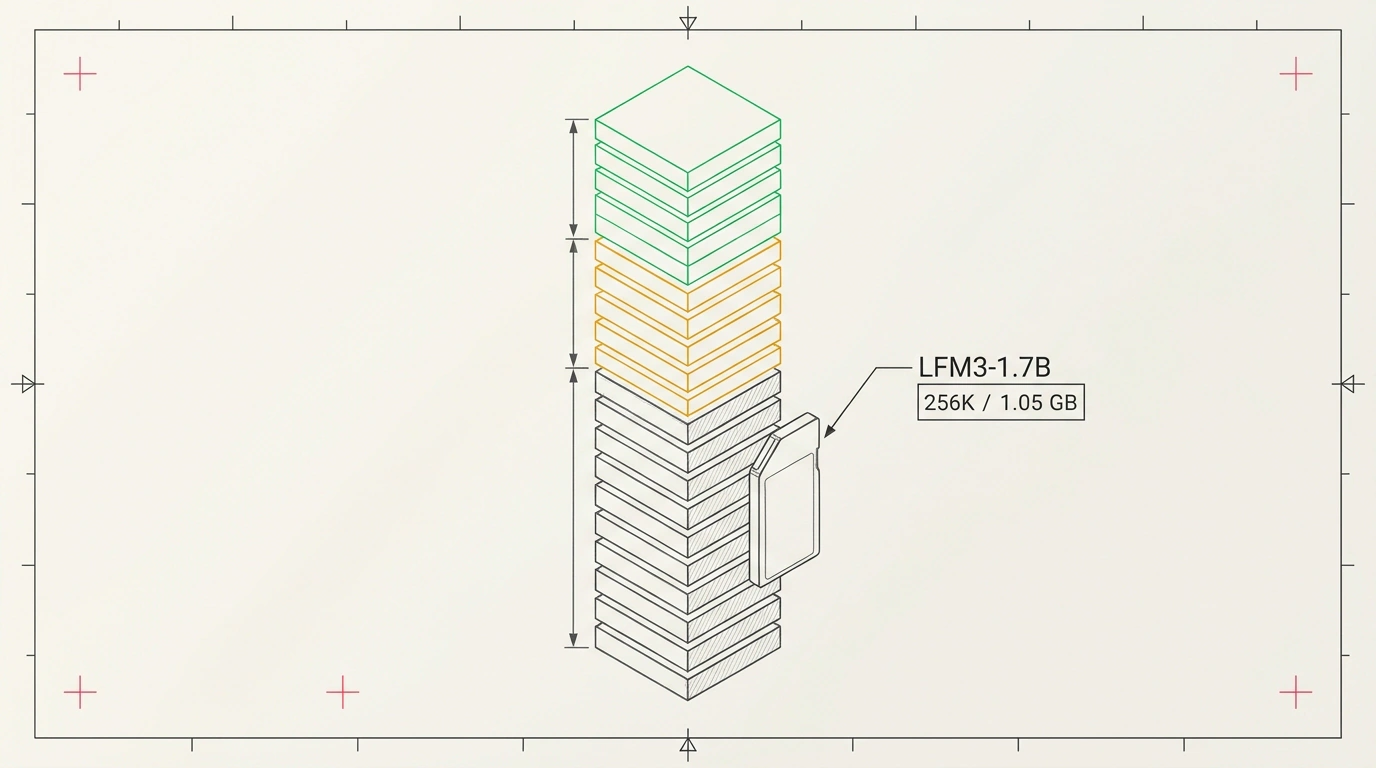

Если ты следишь за развитием больших языковых моделей, то наверняка заметил парадокс: модели становятся умнее, но их прожорливость растет пугающими темпами. Чтобы скормить нейросети объемную книгу или базу кода на пару сотен тысяч токенов, серверу требуются терабайты оперативной памяти. Причина этого тупика заложена в самом сердце архитектуры Transformer — механизме внимания (self-attention). Чем длиннее текст, тем больше вычислений приходится делать алгоритму на каждом слове, причем сложность растет не линейно, а квадратично.
Именно поэтому анонс от стартапа Liquid AI, созданного выходцами из лаборатории MIT CSAIL, вызвал бурю восторга среди инженеров. 27 октября 2026 года команда выкатила в открытый доступ семейство Liquid Foundation Models третьего поколения — LFM 3. Флагман линейки компактных моделей, LFM3-1.7B, предлагает гигантское контекстное окно в 256 000 токенов, но весит в 4-битном квантовании всего один гигабайт и легко запускается даже на одноплатном микрокомпьютере. Давай разберем по винтикам эту необычную «жидкую» архитектуру и посмотрим, как создателям удалось победить квадратичную сложность.
Проклятие квадратичного внимания: тупик классических трансформеров
Давай на секунду представим, как читает текст обычный классический трансформер. Встречая каждое новое слово, он вынужден мысленно сопоставить его со всеми предыдущими словами, которые уже лежат в его памяти. Если в запросе 1 000 слов, матрица связей требует миллион операций. Но если ты загружаешь 250 000 слов, количество связей взлетает до астрономических 62 миллиардов.
Вся эта прорва промежуточных данных оседает в специальном хранилище видеопамяти — KV-кэше (Key-Value cache). В обычных трансформерах KV-кэш для длинного контекста быстро разрастается до сотен гигабайт, моментально съедая всю память GPU. Именно поэтому запуск моделей с контекстом в 128K или 256K токенов до сих пор оставался привилегией гигантских серверных кластеров.
Команда Liquid AI пошла на смелый архитектурный эксперимент. Вместо того чтобы в сотый раз оптимизировать классический трансформер, они разработали принципиально новую не-трансформерную модель, опирающуюся на непрерывные динамические системы (Liquid Neural Networks). В таких сетях параметры нейронов могут плавно адаптироваться под поток входящих данных, подобно жидкости, меняющей форму под воздействием внешних сил.
Архитектура Tri-hybrid: 24 слоя с тремя типами обработки
Главная инженерная изюминка LFM3-1.7B — это ее «тригибридная» (tri-hybrid) внутренняя структура. Модель состоит из 24 глубоких слоев, но устроены они совершенно по-разному:
- 13 слоев стробированных сверток (Gated Convolutions с окном k=7): Они составляют костяк модели. В отличие от механизма внимания, свертки обладают строгой линейной сложностью O(N). Они отвечают за мгновенную обработку локального синтаксиса, порядка слов и грамматических связей. Сверточный слой не требует гигантского KV-кэша и обрабатывает входящий поток данных практически мгновенно.
- 5 слоев локального скользящего внимания (Sliding-window Attention): Эти слои удерживают в фокусе внимания ближайший контекст (несколько сотен соседних токенов), позволяя модели точно связывать местоимения с существительными и удерживать локальную нить рассуждений.
- 6 слоев глобального внимания (Global Attention): Их задача — связывать далекие смысловые узлы документа через гигантские интервалы текста. Но благодаря тому, что глобальных слоев всего шесть, общая нагрузка на память остается крошечной.
Такой гибридный подход позволил снизить потребление памяти KV-кэша на 82% по сравнению с чистыми трансформерами аналогичного размера. Модель была обучена на колоссальном массиве данных в 22 триллиона токенов (22T), что гарантировало ей глубокое понимание естественных языков и синтаксиса программирования.
256 тысяч токенов в кармане: замеры и запуск на краевых устройствах
Сухие цифры спецификаций производят неизгладимое впечатление:
- Контекстное окно: 256 000 токенов (хватит на полсотни глав «Войны и мира» целиком);
- Объем параметров: 1,73 миллиарда (1.73B);
- Размер файла в 4-битном квантовании GGUF (Q4_K_M): всего 1,05 гигабайта;
- Пропускная способность на Apple Silicon: свыше 85 токенов в секунду через MLX.
Я специально изучил результаты синтетических тестов на извлечение скрытой информации из огромного массива текста (needle-in-a-haystack в тесте LongEval). Модель LFM3-1.7B показала точность нахождения факта в 99,1% на всем протяжении 256-килобайтного контекста. Она не «забывает» детали из середины документа, чем часто грешат даже тяжелые закрытые системы.
В общеязыковых тестах компактная модель держится на уровне крепких решений класса 7B предыдущего поколения: MMLU составил 68,4%, а математический бенчмарк GSM8K — 74,2%. Модель выложена под открытой лицензией и сразу получила нативную поддержку в популярных средах инференса vLLM, Ollama и llama.cpp. Как мы подробно разбирали в обзоре семейства моделей LFM 3, такой скачок в эффективности переводит работу с длинными документами из облака прямо на персональные устройства пользователей.
Где жидкие нейросети меняют правила игры
Благодаря весу в один гигабайт LFM3-1.7B открывает дорогу сценариям, которые раньше казались научной фантастикой:
- Персональные агенты на смартфонах и часах: модель можно развернуть прямо на мобильном телефоне для анализа всей личной переписки, заметок и чеков без отправки конфиденциальных данных в чужие облака.
- Бортовые системы и IoT: автономный анализ телеметрии, логов датчиков промышленного оборудования или квадрокоптеров на микроконтроллерах Raspberry Pi 5.
- Локальный аудит кодовых баз: быстрый поиск архитектурных несоответствий и уязвимостей в корпоративных репозиториях без риска утечки коммерческой тайны.
Границы применимости: в чем подвох
Однако не стоит думать, что модель на 1,7 миллиарда параметров способна полностью заменить тяжелые флагманы вроде GPT-6 или Claude Opus. Чудес не бывает: компактный размер накладывает объективные ограничения.
Во-первых, у модели ограничен объем фоновых энциклопедических знаний. Если тебе требуется подробный исторический очерк или глубокий анализ узкого правового прецедента без предоставления исходного текста, модель начнет путаться в датах и именах. Она идеальный аналитик предоставленного текста, но скромный генератор собственных фактов.
Во-вторых, на дистанции свыше 150 000 токенов модель слегка теряет точность при выполнении сложного многошагового синтеза, когда требуется не просто найти факт, а сопоставить противоречивые гипотезы из десяти разных глав отчета.
LFM 3 — это важнейший сигнал всей индустрии: монополия классических трансформеров подходит к концу. Жидкие нейросети доказали, что умение работать с колоссальным объемом информации зависит не от количества терабайт в серверной стойке, а от изящества математической архитектуры.