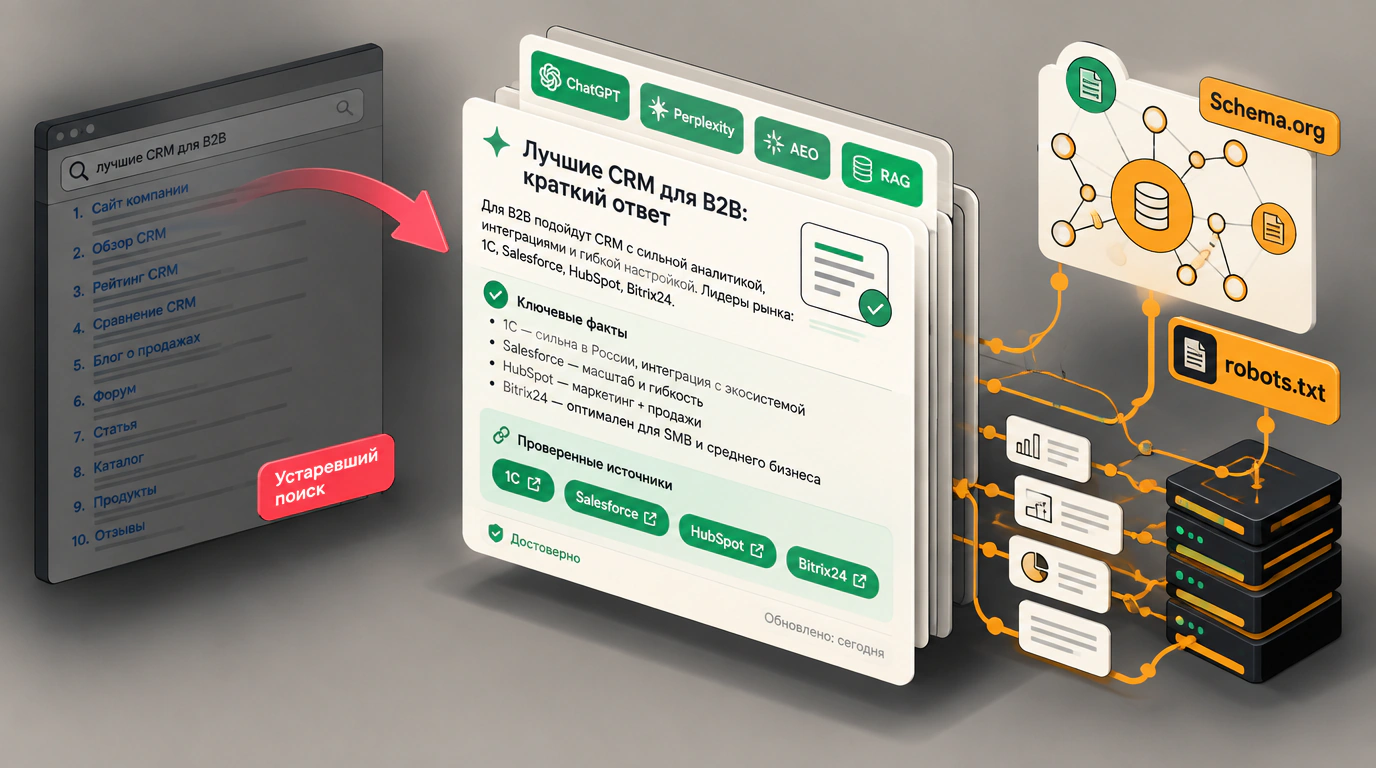


Поисковый рынок переживает крупнейшую трансформацию за двадцать лет. Привычный алгоритм — ввод ключевого слова, просмотр десяти синих ссылок и переход на сайты — уступает место генеративным ответам. Пользователи задают прикладные вопросы напрямую ChatGPT Search, Perplexity, Google Gemini и умным ассистентам Яндекса. Вместо списка страниц человек получает связный аналитический ответ, где модель обобщает проверенные данные и указывает ссылки на рекомендованные сервисы.
Для бизнеса это меняет правила игры: наращивание ссылочной массы и механическая вставка ключей больше не гарантируют клиентов. На смену классическому поисковому продвижению приходят новые направления — оптимизация под поисковые ответы (AEO — Answer Engine Optimization) и генеративная поисковая оптимизация (GEO — Generative Engine Optimization). Эксперты Академии HubSpot и специалист по органическому росту Нил Патель представили практическую методологию адаптации контента под требования алгоритмов искусственного интеллекта.
От классического SEO к AEO и GEO
Классический поисковый робот сканирует страницу, индексирует слова и сопоставляет их с частотными запросами. Генеративные модели работают на базе архитектуры RAG (Retrieval-Augmented Generation — генерация с расширенным поиском):
- Получив вопрос, модель в реальном времени формулирует внутренние поисковые запросы;
- Сканирует наиболее авторитетные веб-документы по теме;
- Извлекает конкретную фактуру, цифры и тезисы;
- Синтезирует структурированный ответ, расставляя ссылки на первоисточники.
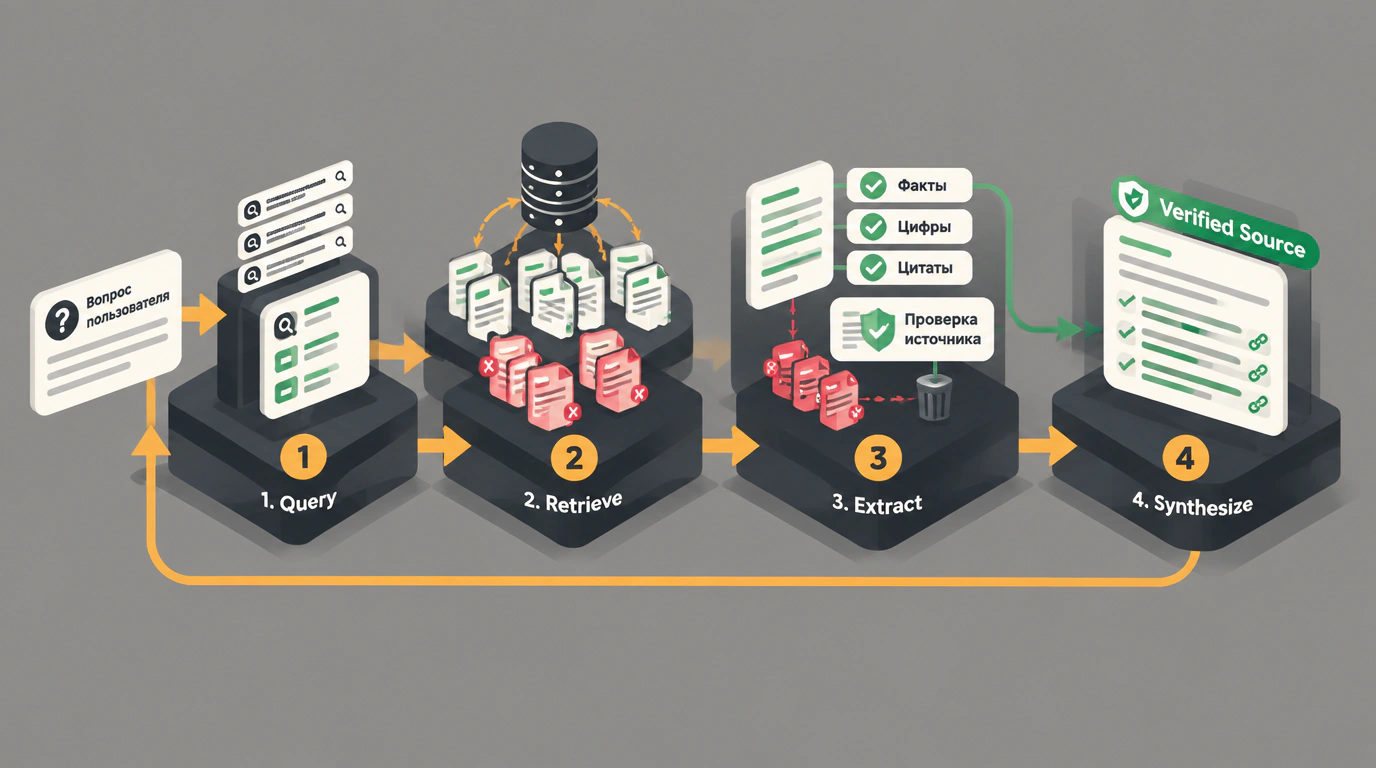
Задача AEO и GEO — стать тем самым первоисточником, из которого языковая модель берет факты. Попадание в справку ИИ формирует максимальное доверие пользователя, так как рекомендация воспринимается как объективный экспертный вердикт.
Принцип тематической глубины: почему универсальные сайты проигрывают
Ошибкой прошлого было стремление писать обо всем подряд. Сайты выпускали сотни поверхностных заметок, рассчитывая собрать разрозненный низкочастотный трафик.
В генеративном поиске этот подход ведет к пессимизации. Модели оценивают авторитетность сущности (Entity Authority) и тематическую глубину (Topical Authority):
- Сайт, публикующий одновременно статьи о бухгалтерии, ремонте квартир и криптовалютах, воспринимается как агрегатор без собственного экспертного ядра;
- Ресурс с узким фокусом, подробно разбирающий все нюансы конкретной ниши, получает наивысший приоритет при генерации ответов.
Генеративные алгоритмы выбирают ресурсы с узкой и глубокой специализацией. Вместо распыления бизнесу выгодно развивать тематические кластеры, досконально закрывающие одну индустрию.
Стратегия строится по модели «Хаб и спицы» (Hub and Spoke): фундаментальная страница (Pillar Page) дает системный обзор темы, а 10–15 детальных прикладных статей раскрывают отдельные вопросы и ссылаются на хаб.
Структура контента для цитирования в RAG
Нейросети парсят факты, отсекая рекламные преамбулы. Чтобы материал стал донором для RAG-архитектуры, верстка и подача должны отвечать трем стандартам:
- Сжатые формулировки в начале блоков. Сразу после подзаголовка размещается абзац из двух-трех предложений с прямым определением процесса или понятия. Модель чаще всего забирает в ответ именно этот сжатый фрагмент;
- Фактологические таблицы и сравнительные матрицы. Нейросети легко считывают табличные данные: сопоставления характеристик, тарифные сетки, матрицы плюсов и минусов, сроки внедрения. Таблицы цитируются в разы чаще сплошного текста;
- Цифры и проверяемые источники. Любой тезис должен подкрепляться процентами эффективности, сроками окупаемости, ссылками на ГОСТы, государственные стандарты или научные публикации.
Технический фундамент сайта для взаимодействия с ИИ
Помимо смысловой упаковки, критически важна техническая доступность ресурса для поисковых краулеров:
- Контроль robots.txt. В файле robots.txt должен быть открыт доступ для ключевых роботов: GPTBot (OpenAI), ClaudeBot (Anthropic), PerplexityBot и других поисковых агентов;
- Семантическая микроразметка Schema.org. Использование словарей
Article,FAQPage,Product,HowToиOrganizationпозволяет моделям точно определять тип данных без сложного анализа верстки; - Чистый HTML и серверный рендеринг (SSR). Если текст подгружается через тяжелые клиентские скрипты, поисковый агент может пропустить его из-за таймаута выполнения кода. Быстрая отдача статического HTML гарантирует полное прочтение контента.
Аудит видимости бренда: методология HubSpot AI Search Grader
Для анализа присутствия компании в ответах нейросетей платформа HubSpot выпустила бесплатный сервис AI Search Grader. Инструмент оценивает видимость бренда в ChatGPT, Perplexity и Gemini по трем факторам:
- Частота упоминания бренда: Как регулярно название компании появляется при сравнении поставщиков в нише;
- Сила цитирования первоисточников: Ссылаются ли нейросети на сайт бренда напрямую или берут сведения из сторонних каталогов;
- Соответствие стандартам AEO: Насколько верстка страниц приспособлена к парсингу блоками определений и списков.
Аудит позволяет выявить перекосы: если сайт занимает топ-1 в обычном поиске, но отсутствует в ответах ИИ, причина кроется в нехватке структурированных выжимок и авторитетных внешних цитирований.
Практический сценарий: выбор B2B-решений через Perplexity
Механику отбора наглядно иллюстрирует прикладной сценарий. Пользователь задает в Perplexity запрос: «Какую CRM выбрать дистрибьютору стройматериалов с интеграцией в 1С и поддержкой многоскладского учета?».
Модель сканирует источники и отсекает рекламные лендинги с общими лозунгами. Вместо них цитируется кейс вендора с таблицей параметров синхронизации с 1С, четкими сроками внедрения и описанием протоколов обмена данными. Поставщик, давший точную инженерную фактуру, получает рекомендацию первого выбора.
Пошаговый план: 5 этапов адаптации контента
Для перестройки веб-ресурса под стандарты генеративного поиска маркетинговой команде стоит выполнить пять шагов:
- Технический аудит краулинга: Проверить доступность сайта для GPTBot и PerplexityBot, настроить микроразметку FAQ и Product;
- Инвентаризация семантики: Сгруппировать статьи в кластеры вокруг центральных страниц-хабов;
- Реструктуризация под Q&A: Добавить четкое определение в начало каждого раздела и вынести тезисы в списки;
- Интеграция матриц: Заменить описания сводными таблицами цен, параметров и сценариев использования;
- Мониторинг: Регулярно тестировать целевые запросы в чат-ботах, отслеживая сниппеты и корректируя исходные статьи.
Риски и ограничения генеративной эры
Переход к AEO несет специфические риски. Главный из них — нулевые клики (Zero-Click Searches): получая готовый ответ в диалоге, пользователь реже переходит на сам сайт, что снижает прямой трафик на 40–60%. Также сохраняется опасность галлюцинаций моделей, если формулировки на странице допускают двоякое толкование. Кроме того, быстрая эволюция промптов поисковых систем требует постоянного тестирования и гибкой доработки материалов.