
Если ты до сих пор строишь стратегию поискового продвижения исключительно вокруг подбора ключевых слов, закупки ссылочной массы и вывода страниц в классический ТОП-10 Яндекса и Google, у меня для тебя отрезвляющая новость: привычный органический поиск стремительно теряет монополию на принятие решений.
Поведение пользователей кардинально изменилось. Сегодня человек, столкнувшийся со сложной проблемой — будь то подозрительное новообразование на коже, тяжелый хронический симптом, выбор корпоративного юриста или архитектора высоконагруженных IT-систем, — все реже продирается сквозь рекламные простыни поисковой выдачи. Он открывает диалоговое окно ChatGPT, запускает генеративный режим Алисы или отправляет запрос в Google AI: «Посоветуй лучшего онколога по меланоме в Москве», «Кто ведущий специалист по лечению печени?», «К кому обратиться со сложной беременностью?».
В эту секунду происходит фундаментальный сдвиг. Поисковик больше не отдает пользователю список из десяти синих ссылок на сайты медицинских центров. Он формирует связный текст с конкретными именами экспертов, их профессиональным бэкграундом и прямыми рекомендациями, куда именно нести деньги. Рождается новая реальность — Generative Engine Optimization (GEO), оптимизация под генеративные нейросети.
Но как именно искусственный интеллект принимает решение, какого врача порекомендовать? Понимает ли нейросеть, в какой клинике специалист работает прямо сейчас? И достается ли коммерческий трафик медицинскому центру, который вкладывает миллионы в зарплаты и продвижение своих ключевых кадров?
Чтобы ответить на эти вопросы не умозрительными гипотезами, а строгими цифрами, агентство TexTerra провело масштабное эмпирическое исследование. Команда протестировала рекомендации трех ведущих нейросетей на реальной выборке московских клиник и врачей. Полученные данные вскрыли колоссальный разрыв между личной медийностью специалиста и реальными продажами его работодателя.
Анатомия эксперимента: 360 ответов, 3 нейросети и 5 уровней промптов
Чтобы исключить фактор случайных галлюцинаций моделей, исследователи разработали строгую матричную методологию. В качестве экспериментального поля была выбрана коммерческая медицина — отрасль, где доверие к автору и цена ошибки максимальны, а пациенты выбирают конкретные руки врача не менее придирчиво, чем вывеску клиники.
В выборку вошли пять авторитетных московских медицинских центров разного масштаба и профиля. В каждом из них аналитики отобрали по два специалиста: одного — с широкой публичной известностью и регулярным присутствием в федеральных медиа, второго — с сильной репутацией внутри профессионального сообщества, но меньшим медийным шумом:
- Клиника доктора Ласкова: Михаил Ласков (онколог, руководитель клиники) и Александр Аболмасов (онколог, заместитель руководителя);
- Европейский медицинский центр (ЕМС): Татьяна Полунина (гастроэнтеролог, гепатолог, руководитель профильного центра) и Марина Бережная (руководитель отделения скорой помощи);
- Группа компаний «Мать и дитя»: Марк Курцер (академик РАН, основатель и гендиректор сети) и Нелли Агаронян (исполнительный директор и главврач филиала Лефортово);
- Сеть клиник «Медси»: Геннадий Коновалов (председатель Ученого совета, научный руководитель) и Алексей Баринов (невролог);
- Клиника системной медицины: Зухра Павлова (эндокринолог, доктор медицинских наук, научный руководитель) и Анна Терехова (эндокринолог).
Архитектура тестового промпт-сета повторяла реальный путь пользователя от брендового поиска до холодного выбора в незнакомой тематике. Всего было сформировано 40 сценариев запросов, разделенных на пять функциональных блоков:
- Блок «Кто это» (10 запросов): прямая проверка идентификации конкретного специалиста («Кто такой врач Михаил Ласков?»);
- Блок «Где принимает» (10 запросов): поиск навигационной информации и точки записи («В какой клинике принимает эндокринолог Зухра Павлова?»);
- Блок «Врачи клиники» (5 запросов): проверка знания медицинского состава учреждения («Назови известных врачей Европейского медицинского центра»);
- Блок «Кого почитать» (10 запросов): запрос на экспертный авторитет и медийность в тематике («Каких врачей почитать по теме гепатологии и болезней печени?»);
- Блок «Посоветуй врача» (5 запросов): коммерческий категорийный запрос под острую проблему без упоминания конкретных брендов и фамилий («Посоветуй хорошего онколога по химиотерапии в Москве»).
Сбор фактуры проходил 26–28 октября 2026 года. Каждый из 40 промптов скармливался трем языковым системам: ChatGPT (с включенным веб-поиском и очищенной памятью), Алисе от Яндекса (в режиме нового чата с геопривязкой к Москве) и Google AI (в режиме AI Overviews / генеративного поиска через браузерное инкогнито).
Критически важная деталь: каждый вопрос задавался трижды в абсолютно независимых сессиях. В итоге исследователи получили и вручную разметили массив из 360 развернутых ответов нейросетей, сопоставив их с фактическими данными на официальных сайтах клиник по состоянию на 29–30 октября.
Парадокс видимости: почему 96% точности по имени рушатся до 16% в категории
Первый вывод исследования выглядит обнадеживающе, но содержит в себе коварную ловушку.
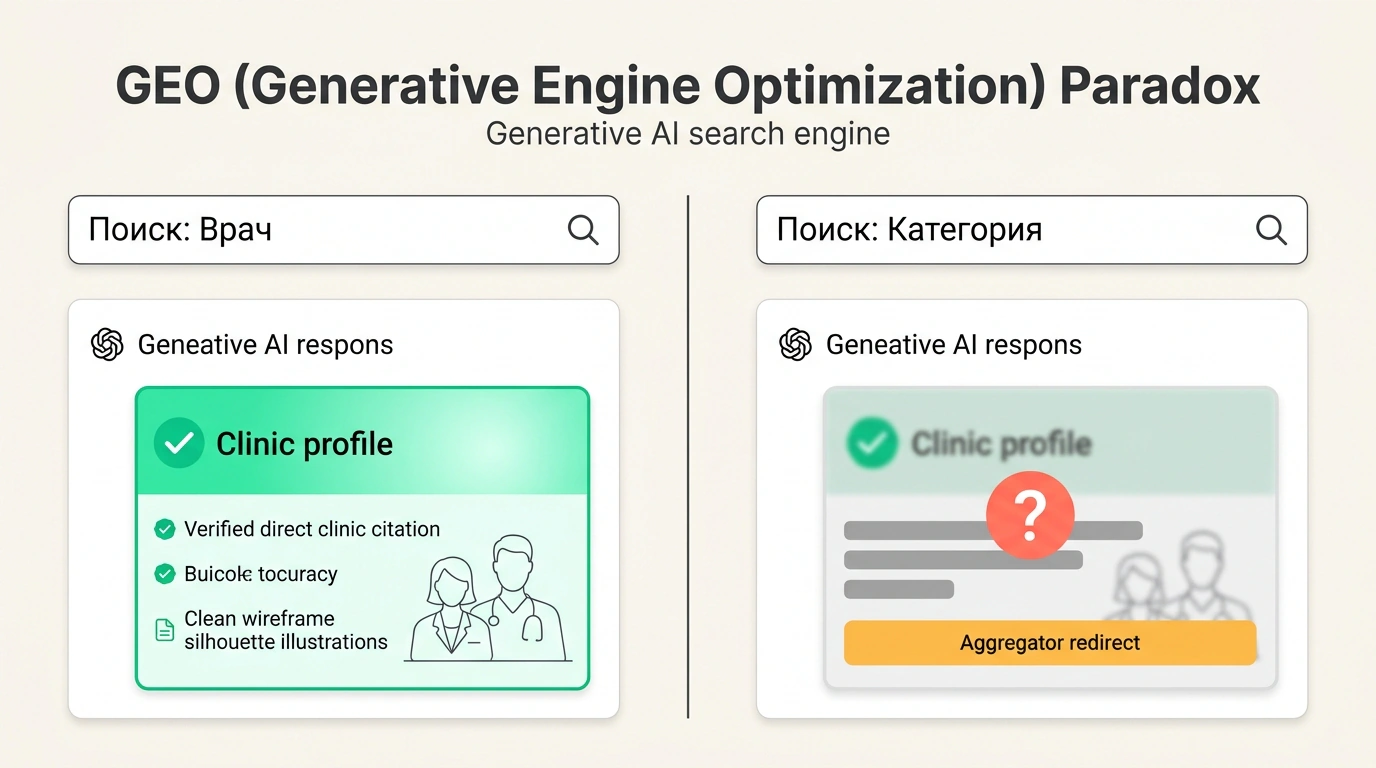
Когда пользователь формулирует запрос с точным указанием фамилии врача (блоки «Кто это» и «Где принимает»), современные нейросети демонстрируют почти безупречную осведомленность. В 173 ответах из 180 (96,1% случаев) алгоритмы безошибочно назвали текущее место работы специалиста. Если пациент уже знает, кого ищет, искусственный интеллект не мешает ему добраться до клиники.
Но как только мы переходим к коммерческим категорийным запросам, где у пациента есть симптом или задача, но нет конкретной фамилии, система демонстрирует катастрофический провал.
В блоках «Кого почитать» и «Посоветуй врача» отобранные эксперты появились в ответах нейросетей лишь 32 раза из 135 возможных. Но самое тревожное для бизнеса произошло на следующем шаге: вместе со своим текущим местом работы врач был назван всего в 22 ответах из 135 (жалкие 16,3%)!
При этом распределение этих 22 результативных упоминаний по платформам вскрыло глубокие различия в алгоритмах:
- ChatGPT: обеспечил 15 корректных связок «врач + клиника»;
- Google AI: дал 7 упоминаний с указанием клиники;
- Алиса: показала абсолютный ноль — ни в одном тематическом ответе отечественная нейросеть не связала эксперта с его работодателем.
Возникает фундаментальный парадокс публичности. Инвестиции в персональный бренд врача работают преимущественно на самого врача как на самостоятельную медийную фигуру. Пациент читает в выдаче фамилию эксперта, но клиника, которая оплачивает его кабинет и оборудование, остается за кадром.
Наглядно проявились три структурные закономерности ранжирования:
- Фактор именного совпадения и тяжелой медийности: абсолютными лидерами по числу упоминаний стали Михаил Ласков (чья фамилия совпадает с брендом учреждения), Марк Курцер (основатель огромного публичного холдинга) и Зухра Павлова (автор популярных книг и регулярный спикер федеральных каналов).
- Барьер внутренней известности: специалисты, чья репутация сосредоточена внутри врачебного сообщества, практически отсутствуют в генеративной выдаче. Научного руководителя «Медси» Геннадия Коновалова нейросети упомянули лишь единожды за весь пул тематических тестов. Высококлассного невролога Алексея Баринова не назвал ни один алгоритм из девяти прогонов о врачах сети.
- Непереносимость статуса: даже если нейросеть великолепно знает врача внутри клиники, она не проецирует это знание на категорийный поиск. Эндокринолога Анну Терехову все три системы без запинки называли в составе Клиники системной медицины, однако в тематических запросах об эндокринологии она не появилась ни единого раза из 27 повторений.
О том, как устроена архитектура цитирования на уровне поисковых роботов, подробно описано в аналитическом материале продвижение бизнеса в генеративных нейросетях: механики цитирования в ChatGPT и Алисе.
Сравнение платформ: разброс выдачи, длина текста и сокрытие источников
Эксперимент доказал: генеративный поиск невероятно стохастичен. Рассчитывать на то, что один раз проверенный промпт будет всегда возвращать стабильный результат, — опаснейшая иллюзия маркетолога.
В категории «Посоветуй врача» не нашлось ни одной фамилии, которую одновременно назвали бы все три конкурирующие системы! Каждая платформа формирует выдачу на базе собственного обучающего корпуса и специфических поисковых индексов.
Даже внутри одной системы ответы от сессии к сессии расходятся радикально. Аналитики сопоставили списки рекомендованных специалистов между повторными генерациями:
- У ChatGPT пересечение фамилий между двумя ответами на идентичный вопрос составило в среднем 24%;
- У Алисы коэффициент повторяемости зафиксирован на уровне 25%;
- У Google AI стабильность оказалась чуть выше — около 30%.
То есть две трети рекомендаций нейросетей меняются от прогона к прогону. Это означает, что мониторить присутствие бренда в ИИ-выдаче по единичному запросу бессмысленно: объективную картину дает только регулярный прогон матричных промпт-сетов.
Существенно различается и сама анатомия ответов:
| Параметр платформы | ChatGPT (OpenAI) | Алиса (Яндекс) | Google AI (Overviews) |
|---|---|---|---|
| Медианный объем ответа | ~5 000 символов | ~6 300 символов | ~2 200 символов |
| Политика ссылок | 626 ссылок (366 уникальных доменов) | Ссылки скрыты в 27 из 30 ответов | Лаконичные карточки со ссылками |
| Поведение в категории | Щедро цитирует блоги и медиа | Формирует длинный связный текст | Сжатая справка с проверенными клиниками |
Алиса выдает самые длинные и подробные эссе, но практически полностью скрывает первоисточники, не оставляя читателю возможности перейти на сайт клиники в один клик. ChatGPT, напротив, действует как контентный агрегатор: в 30 ответах блока «Кто это» система сгенерировала 626 ссылок на 366 уникальных веб-адресов. Однако в Google AI из-за жесткого лимита объема (~2200 знаков) попадание в список становится самым ценным: мест для упоминаний втрое меньше, чем у конкурентов.
Ловушка агрегаторов: как посредники перехватывают горячий трафик
Если ты думаешь, что упоминание твоего ведущего специалиста в ответе нейросети автоматически приносит звонок в твой колл-центр, приготовься к неприятному открытию. В исследовании вскрылась масштабная паразитическая воронка агрегаторов.
В блоке вопросов «Где принимает врач» значительная часть ответов вообще не содержала ссылок на официальные сайты клиник!
- У ChatGPT 6 ответов из 30 вели исключительно на внешние агрегаторы;
- У Алисы таких ответов набралось 7 из 30;
- У Google AI — 3 ответа.
Но самое разрушительное кроется в контактных телефонах. В 31 ответе нейросетей в качестве номера для записи к врачу был указан подменный виртуальный телефон агрегаторов «НаПоправку», «ПроДокторов» или «СберЗдоровье»!
Доходило до гротеска:
- Для записи к академику Марку Курцеру в семи ответах из девяти нейросети выдали единый телефон сервиса «НаПоправку». Пациент звонит в стороннюю службу, платит комиссию агрегатору или вовсе перенаправляется оператором в другое партнерское учреждение.
- Для Александра Аболмасова искусственный интеллект сгенерировал семь различных телефонных номеров в девяти ответах, собрав солянку из старых филиалов и партнерских колл-центров.
Что это значит в экономике клиники? Бизнес платит зарплату врачу, инвестирует в оборудование, а коммерческий лид из генеративного поиска перехватывает агрегатор, требуя с клиники от 1 500 до 5 000 рублей за каждую подтвержденную запись.
В деталях методологию выявления таких дыр в цифровом поле описывает матрица фактов против галлюцинаций: методология GEO-аудита брендов в нейровыдаче от TexTerra.
Синдром цифрового мусора: почему 70% экспертов обрастают дезинформацией
Откуда нейросети берут эти ложные данные? Они галлюцинируют?
Ручная верификация первоисточников показала: нейросети редко выдумывают факты на пустом месте. Они аккуратно зеркалят тот хаос, который царит на общедоступных сайтах интернета.
У 7 из 10 исследованных врачей в сети были обнаружены противоречивые, неполные или грубо устаревшие сведения. И ровно эти ошибки слово в слово всплывали в генеративных ответах:
- Фантомные места работы: врач уволился из государственного НИИ или конкурирующего медцентра три года назад, но старый профиль на агрегаторе остался активным. Нейросеть считывает оба источника и сообщает пациенту, что прием ведется в двух конфликтующих организациях.
- Путаница в должностях и регалиях: расхождения между официальным сайтом клиники и профилями в каталогах приводят к тому, что ИИ путает заведующих отделениями с рядовыми ординаторами.
- Ложные подписи к фотографиям: поисковые краулеры индексируют картинки из новостных публикаций. Если фотография ведущего хирурга размещена в статье рядом с комментарием другого специалиста, нейросеть приписывает чужую цитату и специализацию нашему герою.
- Проблема однофамильцев: когда у авторитетного эксперта есть тезки в смежных специальностях, языковая модель с легкостью склеивает их биографии в единого монстра, наделяя онколога навыками мануального терапевта.
Если клиника не занимается санитарией своего цифрового следа, поисковые боты скармливают нейросетям информационную кашу, разрушая репутацию бренда прямо в момент первого касания с клиентом.
E-E-A-T нового поколения: превращаем эксперта в цифровую сущность
Чтобы заставить генеративные модели устойчиво рекомендовать твоих сотрудников и твой бизнес, нужно понять фундаментальный принцип работы современных LLM: переход от индексации страниц по ключевым словам к построению графов знаний (Knowledge Graphs) на основе смысловых сущностей (Entities).
Поисковая система больше не воспринимает текст как набор ключевиков. Для нее клиника — это сущность типа MedicalOrganization, а врач — сущность типа Physician или Person. Между ними должна быть установлена жесткая, многократно подтвержденная предикатная связь: worksFor (работает в), alumniOf (окончил), hasCredential (имеет квалификацию).
Этот сдвиг напрямую опирается на концепцию Google E-E-A-T (Experience, Expertise, Authoritativeness, Trustworthiness), обновленную летом 2026 года под реалии генеративного поиска. Алгоритмам требуется твердое подтверждение личного практического опыта автора.
Зарубежные замеры сервиса Profound показали, что на профессиональных запросах до 35% цитирований ChatGPT приходится на публикации платформы LinkedIn. А аналитики Meltwater выяснили, что 75% таких цитат ведут на личные профили авторов, причем больше половины из них имеют скромную аудиторию менее 10 000 подписчиков. Нейросети ищут не дутых блогеров-миллионников, а признанных практиков с твердым послужным списком.
В российских реалиях, где доступ к ряду зарубежных платформ ограничен, функции генераторов авторитетности выполняют другие площадки:
- Собственные экспертные блоги на корпоративных доменах;
- Профильные медиа (РБК, Ведомости, Forbes, Хабр, VC);
- Профессиональные отраслевые реестры и базы научных публикаций (eLibrary, КиберЛенинка);
- Независимые верифицированные агрегаторы с жесткой модерацией отзывов.
Пошаговое руководство по адаптации контента под требования алгоритмов нового поколения читай в материале генеративная оптимизация поиска (GEO): как брендам попасть в ответы ChatGPT, Perplexity и Яндекс Нейро.
Регламент GEO-оптимизации: 5 шагов для клиник и B2B-компаний
На основе результатов исследования эксперты TexTerra сформулировали практический чек-лист, который позволяет связать личный бренд эксперта с брендом компании и заставить нейросети отдавать трафик первоисточнику, а не посредникам:
- Шаг 1. Внедрить микроразметку Schema.org на всех посадочных страницах.
Каждый профиль сотрудника на сайте должен быть размечен схемой
PhysicianилиPersonс обязательным заполнением полейworksFor(с прямой ссылкой на корневой домен компании),jobTitle,alumniOfи массивомsameAsсо ссылками на профили в Википедии, агрегаторах и социальных сетях. Это формирует однозначную запись в глобальном графе знаний. - Шаг 2. Ввести правило неразрывной связки в контент-политике. Запрети публикацию любых экспертных колонок, комментариев в прессе и выступлений на конференциях без обязательного указания текущей должности и компании. Формула проста: эксперт нигде не существует как изолированная единица — во всех метаданных, подписях к фото, титрах и дескрипшенах видео он фигурирует исключительно как представитель бренда.
- Шаг 3. Провести генеральную уборку на агрегаторах. Маркетинг обязан взять под контроль карточки врачей на всех платформах-посредниках. Удалить неактуальные профили уволившихся специалистов, актуализировать расписание, вычистить старые филиалы и потребовать замены подменных телефонных номеров на прямой шлюз клиники там, где это позволяет тариф платформы.
- Шаг 4. Создавать контент с уникальной клинической фактурой. Шаблонные рерайты из Википедии алгоритмы игнорируют. Чтобы попасть в обучающую выборку или контекст RAG-поиска, статья должна содержать реальный клинический опыт: разборы атипичных случаев, протоколы лечения, фотофиксацию динамики (с согласия пациентов) и персональные выводы специалиста.
- Шаг 5. Запустить регулярный GEO-мониторинг. Сформируй матричный промпт-сет из 30–50 запросов, охватывающих брендовый, навигационный и проблемный поиск. Прогоняй его раз в квартал минимум в трех независимых итерациях по ChatGPT, Алисе и Google. Отслеживай динамику доли голоса (Share of Voice) и вовремя устраняй всплывающие галлюцинации.