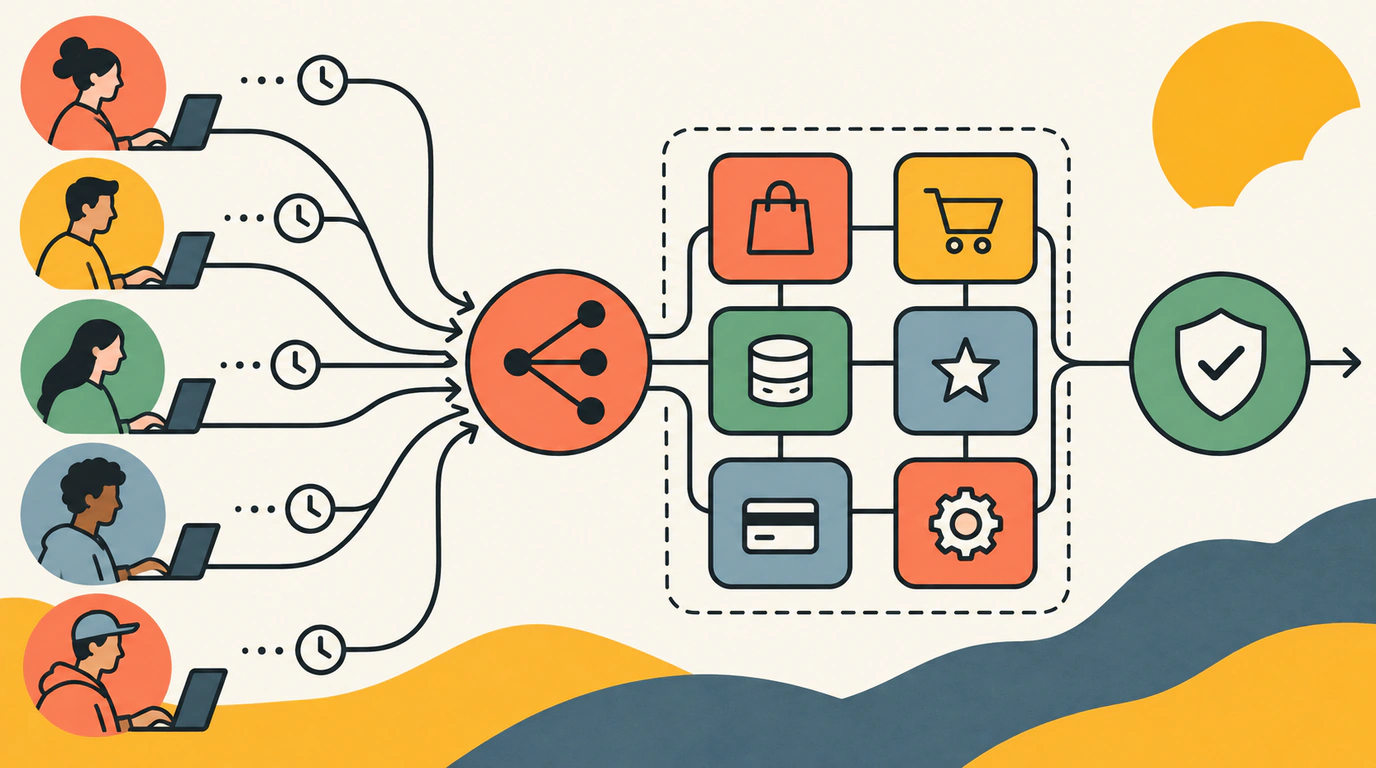

Тестирование производительности распределенных систем часто сводят к хаотичным скриптам: инженер запускает одиночный цикл запросов с локального ноутбука и надеется обнаружить узкие места сервиса. На практике такой подход дает иллюзию стабильности. Реальный трафик в микросервисном кластере неоднороден: пользователи совершают цепочки действий с паузами на размышление, сетевые балансировщики распределяют соединения по пулам подов, а внутренняя деградация одной зависимости способна каскадом обрушить смежные очереди.
Когда тестовый полигон приближается к боевым условиям, разрозненные файлы скриптов быстро становятся неподдерживаемыми. Чтобы получить воспроизводимые и достоверные метрики, нагрузочный тестовый набор должен проектироваться как полноценное приложение со строгим разделением ответственности: от атомарных HTTP-вызовов и пользовательских сценариев до конфигураций профилей нагрузки и декларативных соглашений об уровне обслуживания (SLA).
Полигон: Online Boutique в живом кластере
Для создания репрезентативной нагрузки недостаточно синтетического эхо-сервера или синтетического REST API с одной таблицей. Эталонным стендом для проверки распределенного взаимодействия выступает открытое микросервисное приложение Google Online Boutique. Архитектура проекта объединяет одиннадцать независимых сервисов, написанных на разных языках: веб-витрину (frontend), корзину (cartservice), каталог товаров (productcatalogservice), расчет валют (currencyservice), модуль рекомендаций (recommendationservice) и систему оформления заказов (checkoutservice).
В тестовом окружении на базе kubeadm и операционной системы Ubuntu приложение разворачивается в изолированном пространстве имен:
kubectl create namespace boutique
kubectl apply -n boutique -f \
  https://raw.githubusercontent.com/GoogleCloudPlatform/microservices-demo/main/release/kubernetes-manifests.yaml
Для имитации внешнего входящего трафика сервис веб-витрины публикуется наружу с типом LoadBalancer. В локальных и bare-metal инсталляциях распределение адресов берет на себя контроллер MetalLB. При переходе сервиса frontend-external в активное состояние сетевой балансировщик выделяет кластеру маршрутизируемый внешний IP-адрес (например, 10.4.20.2), через который тестовый генератор взаимодействует с кластером точно так же, как реальные клиенты из внешней сети.
Архитектурные слои тестового набора k6
Главное архитектурное решение при работе с k6 — отказ от монолитного сценария в пользу модульной слоистой структуры каталогов. Монолитные тесты страдают от дублирования кода, жестко зашитых URL и невозможности комбинировать поведение пользователей без переписывания всего файла.
Масштабируемый проект k6-boutique делится на четыре изолированных уровня:
- Конфигурации (
src/config/) — JSON-файлы, определяющие параметры запуска (продолжительность стадий, количество виртуальных пользователейvus, пороговые метрики). Файлыsmoke.config.json,load.config.jsonиstress.config.jsonпереключаются на лету через переменную окруженияCONFIG_FILE. - Сценарии (
src/scenarios/) — цепочки действий пользователя (User Journeys). Сценарии (browseFlow.js,shopperFlow.js) импортируют атомарные скрипты страниц, связывают их во времени и задают естественные паузы (sleep). - Атомарные действия (
src/scripts/) — отдельные файлы (home.js,product.js,cart.js,checkout.js), отвечающие за конкретные операции. Каждое действие инкапсулирует вызовы в именованную группуgroup(). - Инфраструктурная библиотека (
src/lib/) — общий HTTP-клиент, генераторы случайных данных и модуль нормализации тегов запросов.
Особое внимание уделяется кардинальности метрик. Если генерировать динамические URL с идентификаторами товаров напрямую (http.get('/product/' + id)), k6 создаст в хранилище временных рядов отдельную метрику для каждого уникального пути. В результате Prometheus или Grafana Cloud захлебнутся от десятков тысяч временных рядов. Использование явного тега tags: { name: 'GetProduct' } схлопывает все обращения к карточкам товаров в единую аналитическую серию.
Ниже представлен первый уровень цепочки — атомарный скрипт загрузки каталога товаров с нормализацией тегов и локальной проверкой ответа:
import http from 'k6/http';
import { group, check } from 'k6';

// Базовое действие: открытие главной страницы и загрузка каталога товаров
export function viewCatalog(baseUrl) {
  group('Catalog_View', function () {
    const params = {
      tags: { name: 'GetCatalogPage' },
      headers: { 'Accept': 'text/html,application/xhtml+xml' },
    };

    const response = http.get(`${baseUrl}/`, params);

    // Локальная проверка валидности ответа конкретного сервиса
    check(response, {
      'catalog status is 200': (r) => r.status === 200,
      'catalog body is not empty': (r) => r.body && r.body.length > 0,
    });
  });
}
Сборка пользовательских маршрутов
Поведение реальных посетителей интернет-магазина не сводится к бесконечному спаму одного эндпоинта. Одни пользователи быстро просматривают каталог и закрывают вкладку, другие изучают карточки товаров, меняют валюту отображения цен и оформляют покупки.
На уровне сценариев атомарные действия объединяются в сквозной маршрут покупателя. Здесь критически важно воспроизводить время реакции человека (think time). Если виртуальный пользователь (VU) отправляет следующий запрос мгновенно после получения предыдущего ответа, кластер сталкивается с нереалистичным штормом TCP-соединений. Введение интервалов sleep(randomBetween(1, 4)) позволяет получить распределение нагрузки, соответствующее живому трафику.
Второй блок кода развивает наш сценарий: мы импортируем функцию viewCatalog и комбинируем ее с добавлением товара в корзину и переходом к оформлению в рамках одного непрерывного пользовательского потока:
import { sleep, group } from 'k6';
import { viewCatalog } from '../scripts/home.js';
import http from 'k6/http';
import { check } from 'k6';

// Сценарий активного покупателя: просмотр -> добавление в корзину -> оформление
export function shopperFlow(baseUrl) {
  // Шаг 1: Изучение витрины
  viewCatalog(baseUrl);
  sleep(1.5);

  // Шаг 2: Добавление выбранного товара в корзину
  group('Cart_Add_Item', function () {
    const payload = {
      product_id: 'OLJCESPC7Z',
      quantity: 1,
    };
    const params = {
      tags: { name: 'PostAddToCart' },
      headers: { 'Content-Type': 'application/x-www-form-urlencoded' },
    };

    const res = http.post(`${baseUrl}/cart`, payload, params);

    check(res, {
      'item added to cart': (r) => r.status === 200 || r.status === 302,
    });
  });

  sleep(2.0);

  // Шаг 3: Проверка состояния корзины
  group('Cart_View', function () {
    const res = http.get(`${baseUrl}/cart`, {
      tags: { name: 'GetCart' },
    });

    check(res, {
      'cart rendered successfully': (r) => r.status === 200,
    });
  });
}
Проверки ответов против пороговых значений SLA
В нагрузочном тестировании принципиально разделять два механизма контроля качества: функциональные проверки (checks) и пороговые показатели (thresholds).
Функция check() фиксирует корректность единичного HTTP-ответа: равен ли статус 200, пришел ли ожидаемый заголовок или тело документа. Однако check() не останавливает тест при единичном сбое и не может напрямую судить о производительности системы в целом. Для оценки стабильности кластера используются пороги thresholds. Это декларативные правила, применяемые ко всему массиву собранных метрик.
Пороги переводят требования SLA в объективный машинный вердикт:
- Доля ошибок (
http_req_failed): жесткое ограничение процента неуспешных ответов. Для надежных микросервисов типичным является требованиеrate < 0.01(менее 1% отказов). - Время отклика (
http_req_duration): контроль задержки по перцентилям. Среднее арифметическое время скрывает аномальные всплески, поэтому ориентируются на 95-й и 99-й перцентили. Например,p(95) < 500требует, чтобы 95% всех запросов завершались быстрее чем за 500 миллисекунд.
При несоблюдении любого из порогов процесс k6 завершается с ненулевым кодом возврата (exit code 99). Это свойство превращает нагрузочный запуск в автоматический шлюз качества (quality gate) для CI/CD-пайплайнов: если новая сборка замедлила работу корзины или вызвала каскадные ошибки, конвейер деплоя прерывается до релиза на прод.
Завершающий блок кода демонстрирует входную точку тестового комплекса, связывающую ступенчатый профиль нагрузки, сценарий покупателя и жесткие SLA-пороги:
import { shopperFlow } from './scenarios/shopperFlow.js';

// Декларативная конфигурация профиля нагрузки и критериев приемки SLA
export const options = {
  stages: [
    { duration: '30s', target: 5 },   // Плавный разгон (Ramp-up)
    { duration: '1m', target: 15 },   // Стабильное плато рабочей нагрузки
    { duration: '20s', target: 0 },   // Плавное завершение (Ramp-down)
  ],
  thresholds: {
    // Не более 1% сетевых и HTTP-ошибок за весь период прогона
    'http_req_failed': ['rate<0.01'],
    // 95% запросов должны выполняться быстрее 500 мс, а 99% — быстрее 1200 мс
    'http_req_duration': ['p(95)<500', 'p(99)<1200'],
    // Порог на специализированную группу добавления в корзину
    'http_req_duration{name:PostAddToCart}': ['p(95)<400'],
  },
};

const BASE_URL = __ENV.TARGET_URL || 'http://10.4.20.2';

export default function () {
  shopperFlow(BASE_URL);
}
Разбор сетевых сбоев первого прогона
При первом запуске тестов против живого кластера почти всегда вскрываются неожиданные сетевые аномалии. В рассматриваемом кейсе при переходе на этап с 15 одновременными виртуальными пользователями генератор k6 внезапно зафиксировал всплеск ошибок с кодом status 0.
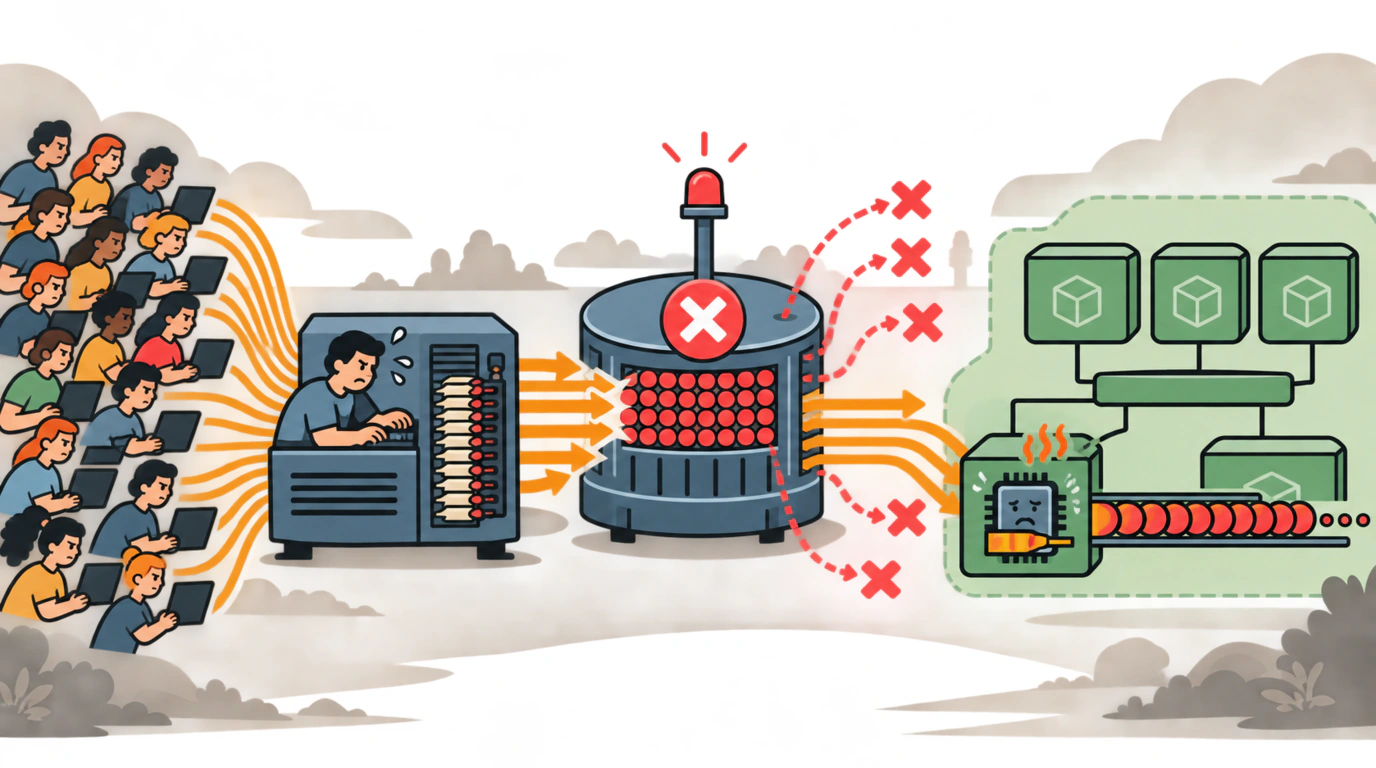
Инженеры часто ошибочно списывают status 0 на падение бэкенда или баг в приложении. Однако статус 0 в k6 означает, что HTTP-ответ от сервера вообще не был получен на уровне операционной системы генератора: произошел сброс соединения (Connection Reset), отказ в рукопожатии TCP (Connection Refused) или истек сетевой таймаут.
Анализ инфраструктуры выявил цепочку узких мест:
- Лимиты соединений сетевого балансировщика: в конфигурации MetalLB и виртуального маршрутизатора быстро исчерпался лимит отслеживания соединений
conntrack. Пакеты от новых виртуальных пользователей отбрасывались еще до попадания в под сервисаfrontend. - Агрессивный цикл запросов без think time: в ранней версии сценария отсутствовали интервалы между вызовами. 15 виртуальных пользователей генерировали плотность обращений, сопоставимую с тысячами реальных клиентов, что привело к мгновенному исчерпанию пула файловых дескрипторов на стороне генератора.
- Недостаток ресурсов подов: pod
currencyserviceуперся в процессорный лимит CPU limits, установленный в манифестах по умолчанию (100m), что привело к троттлингу потоков и росту очереди входящих gRPC-запросов от веб-витрины.
После добавления пауз между шагами пользователя, расширения лимитов процессорного времени и тюнинга параметров сетевого стека показатели вернулись в норму: задержка 95-го перцентиля стабилизировалась на отметке 240 мс, а процент ошибок снизился до абсолютного нуля.
Чек-лист подготовки нагрузочного стенда в Kubernetes
- Развернуть целевое микросервисное приложение в изолированном пространстве имен без фоновой сторонней нагрузки.
- Убедиться, что сетевой балансировщик (MetalLB или облачный Ingress) выделил постоянный внешний IP-адрес.
- Проверить лимиты ресурсов (CPU/Memory requests и limits) для всех сервисов цепочки, исключив ранний троттлинг.
- Реализовать слоистую структуру тестов: изолировать скрипты страниц от сценариев и конфигураций.
- Настроить тег
nameдля всех динамических запросов во избежание взрыва кардинальности метрик. - Внедрить естественные паузы
sleep()для имитации задержки человеческого восприятия. - Сформулировать четкие пороги
thresholdsпо доле ошибок и ключевым перцентилям задержки для автоматической валидации в CI.
Проектирование нагрузочных тестов на базе модульной архитектуры и объективных SLA-порогов превращает k6 из разовой утилиты в надежный инструмент контроля распределенной инфраструктуры. Изоляция атомарных вызовов в независимые файлы и точечная настройка порогов гарантируют, что деградация любого микросервиса будет выявлена задолго до того, как с ней столкнутся реальные пользователи.