
Непрерывная интеграция и доставка кода (CI/CD) в активных продуктовых командах часто упираются в дилемму инфраструктурных затрат и скорости прохождения пайплайнов. Классический подход со статическим пулом виртуальных машин в облаке создает постоянные проблемы. В рабочие часы, когда инженеры одновременно отправляют коммиты и открывают запросы на слияние, задачи выстраиваются в многоминутные очереди. Ночью и в выходные те же самые серверы продолжают работать вхолостую, сжигая бюджет компании.
Попытка решить вопрос покупкой мощных инстансов с фиксированной оплатой приводит к переплатам в три-пять раз. Единственный надежный способ разорвать эту зависимость — динамическое автомасштабирование рабочих узлов (GitLab Runners), поднимающее серверы точно под текущий объем задач и сразу освобождающее мощности после завершения сборки.
Архитектурная модель: от монолитных демонов к легковесному менеджеру
Исторически для автомасштабирования в среде Docker использовался инструмент Docker Machine. Однако проект давно признан устаревшим, не получает обновлений безопасности и плохо адаптирован к современным API облачных провайдеров. В актуальных версиях GitLab Runner архитектура переработана вокруг плагинной модели Fleeting.
В новой схеме инфраструктура разделяется на два независимых контура:
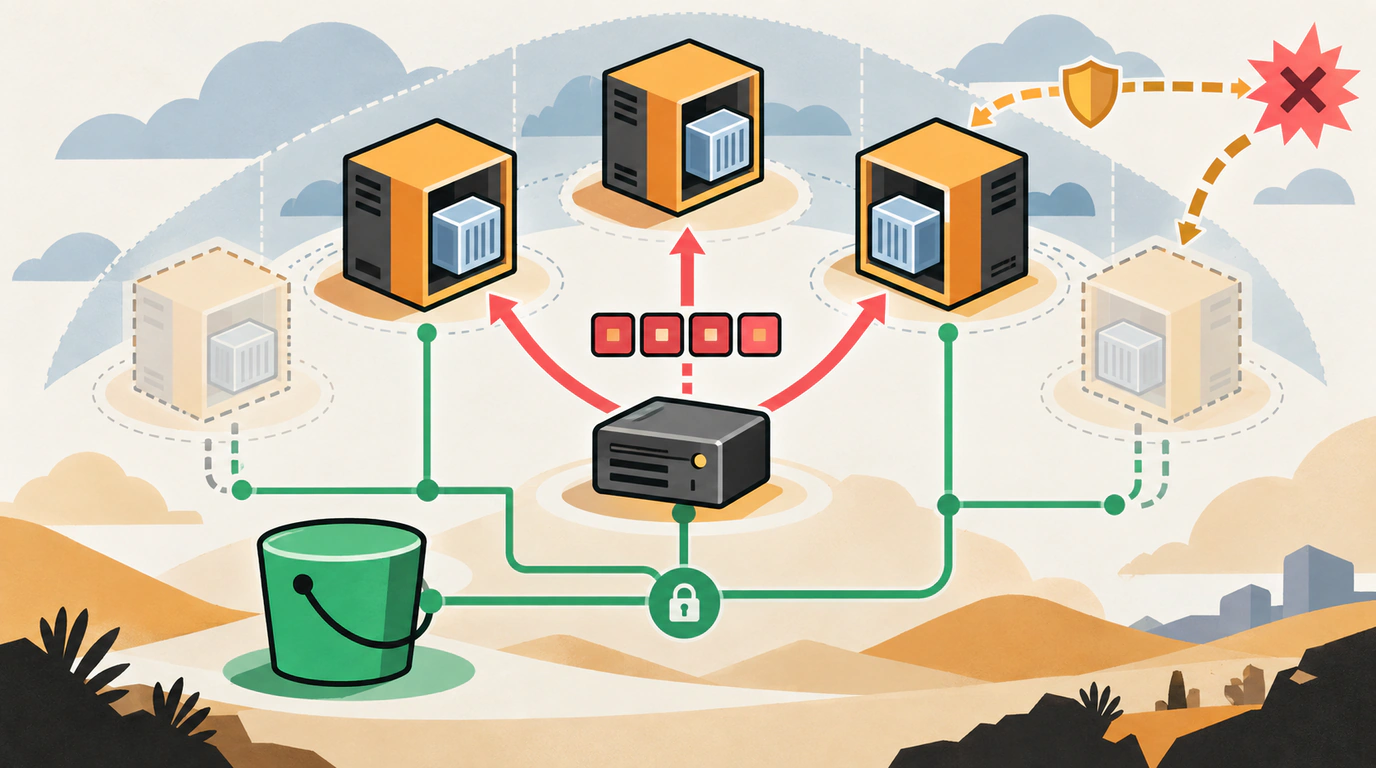
- Управляющий узел (Runner Manager). Небольшой экономичный сервер (например, инстанс AWS EC2 класса
t3.smallилиt3.medium), который работает постоянно. Он не выполняет тяжелую сборку и тестирование проектов, а лишь непрерывно опрашивает координатор GitLab на наличие запланированных задач и взаимодействует с API облака через плагинfleeting-plugin-aws. - Пул динамических воркеров (Worker Fleet). Группа виртуальных машин, создаваемых в рамках AWS Auto Scaling Group (ASG). Когда в очереди появляются новые задачи, менеджер запрашивает расширение группы. Как только воркер инициализируется, на нем стартует изолированный контейнер сборщика, исполняет сценарий пайплайна, отправляет артефакты и уничтожается.
Такое разделение гарантирует стопроцентную изоляцию сборок (Job Isolation). Каждый запуск происходит на чистой виртуальной машине. Это исключает конфликты версий системных библиотек, накопление мусорных слоев Docker на диске и случайные утечки секретов между ветками разных команд.
Экономика Spot-инстансов и защита от прерываний
Главный источник экономии при масштабировании в Amazon Web Services — использование спотовых мощностей (AWS Spot Instances). Спотовые серверы продаются со скидкой до 70–80% по сравнению с фиксированным тарифом On-Demand, поскольку представляют собой свободные резервные мощности дата-центров.
Основной риск спотов — возможность их отзыва облаком при внезапном дефиците ресурсов. Amazon отправляет предупреждение об отзыве (Spot Interruption Notice) всего за две минуты до принудительной остановки виртуальной машины. Если воркер оборвется посреди долгой компиляции, разработчикам придется перезапускать пайплайн вручную. Для защиты от подобных сбоев на уровне инфраструктуры настраивается комплекс мер:
- Диверсификация семейств инстансов. В шаблоне запуска Auto Scaling Group указывается не один конкретный тип сервера, а гибкий список совместимых конфигураций из разных поколений (
c5.xlarge,c5a.xlarge,c6i.xlarge,m5.xlarge). Если в зоне доступности закончатся машины одного типа, AWS автоматически выдаст сервер из альтернативного пула. - Распределение по нескольким зонам доступности (Multi-AZ). Пул разворачивается как минимум в трех независимых дата-центрах региона.
- Механизм Capacity Rebalance. Мониторинг упреждающих сигналов AWS позволяет менеджеру заблаговременно прекратить назначение новых шагов сборки на машину, находящуюся в зоне риска отзыва.
Организация распределенного кеша без лишних сетевых затрат
Поскольку каждый динамический воркер живет всего несколько сборок, локальный кеш зависимостей (пакеты npm, модули Go, слои Docker) стирается вместе с виртуальной машиной. Без общего хранилища каждый запуск пайплайна тратил бы время на повторное скачивание терабайтов библиотек из интернета.
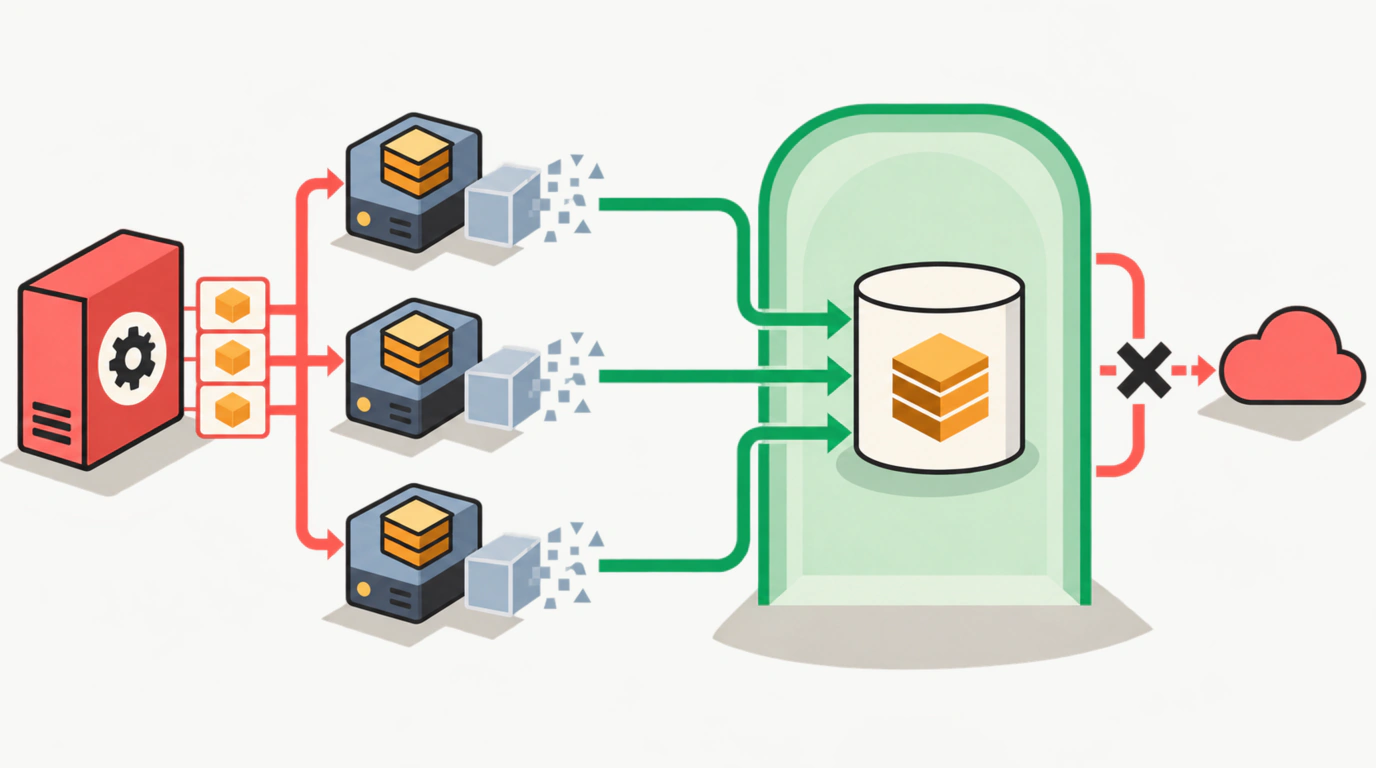
Для решения этой задачи раннеры подключаются к единому бакету Amazon S3. Чтобы кеширование не превратилось в отдельную статью расходов из-за исходящего интернет-трафика (NAT Gateway data egress), подключение к бакету организуется через интерфейсный эндпоинт виртуального частного облака (VPC Endpoint for S3). В этом случае трафик между воркерами и объектным хранилищем циркулирует исключительно по внутренней магистральной сети Amazon с околонулевыми задержками и без тарификации внешнего трафика.
Пошаговая настройка управляющего раннера
Перед конфигурированием демона создаются необходимые сущности в панели управления или через Terraform:
- Выделяется IAM-роль для управляющего узла с разрешениями на управление группой автомасштабирования (
autoscaling:SetDesiredCapacity,autoscaling:TerminateInstanceInAutoScalingGroup,ec2:DescribeInstances) и выполнение команд через AWS Systems Manager (ssm:SendCommand). - Формируется шаблон запуска (Launch Template) воркера на базе Ubuntu 24.04 с предустановленным Docker Engine и агентом AWS SSM. Управление через SSM избавляет от необходимости открывать публичные SSH-порты в корпоративную сеть.
- Создается группа масштабирования (ASG) с минимальным размером 0 инстансов.
На самом управляющем сервере устанавливается менеджер и официальный модуль интеграции:
# Добавление официального репозитория пакетов GitLab
curl -L "https://packages.gitlab.com/install/repositories/runner/gitlab-runner/script.deb.sh" -o gitlab-repo-add.sh
sudo bash gitlab-repo-add.sh
sudo apt-get update && sudo apt-get install -y gitlab-runner

# Установка плагина Fleeting для взаимодействия с AWS Auto Scaling
sudo gitlab-runner fleeting install aws:latest
fleeting-plugin-aws --version
После установки бинарников создается файл конфигурации /etc/gitlab-runner/config.toml. Ниже представлен базовый вариант для одиночного исполнителя Docker на статическом сервере:
concurrent = 4
check_interval = 0
shutdown_timeout = 30

[[runners]]
  name = "static-docker-runner"
  url = "https://gitlab.example.com"
  id = 101
  token = "glrt-STATIC_TOKEN_PLACEHOLDER"
  executor = "docker"

  [runners.docker]
    tls_verify = false
    image = "ubuntu:24.04"
    privileged = false
    disable_entrypoint_overwrite = false
    oom_kill_disable = false
    disable_cache = false
    volumes = ["/cache"]
    shm_size = 0
Для перехода к динамическому облачному пулу конфигурация кардинально модернизируется: тип исполнителя меняется на docker-autoscaler, добавляются секции интеграции с AWS SSM, настройки политик масштабирования по расписанию и прямое подключение к кешу в Amazon S3:
concurrent = 50
check_interval = 0
shutdown_timeout = 30

[session_server]
  session_timeout = 1800

[[runners]]
  name = "aws-ec2-spot-autoscale-runner"
  url = "https://gitlab.example.com"
  id = 102
  token = "glrt-AUTOSCALE_TOKEN_PLACEHOLDER"
  executor = "docker-autoscaler"

  # Конфигурация распределенного кеша в Amazon S3
  [runners.cache]
    Type = "s3"
    Shared = true
    [runners.cache.s3]
      ServerAddress = "s3.eu-central-1.amazonaws.com"
      BucketName = "gitlab-runner-cache-eu-central-1"
      BucketLocation = "eu-central-1"
      AuthenticationType = "iam"

  # Параметры подключения к плагину Fleeting и AWS ASG
  [runners.autoscaler]
    plugin = "aws:latest"
    capacity_per_instance = 1
    max_use_count = 5
    max_instances = 40

    [runners.autoscaler.plugin_config]
      name = "gitlab-ci-runners-asg"
      profile = "default"

    [runners.autoscaler.connector_config]
      username = "ubuntu"
      protocol = "ssm"
      timeout = "15m"

    # Базовая политика: ночью и в выходные держим 0 машин
    [[runners.autoscaler.policy]]
      idle_count = 0
      idle_time = "10m0s"
      scale_factor = 1.2

    # Дневная политика: в рабочее время держим 3 прогретых инстанса
    [[runners.autoscaler.policy]]
      periods = ["* 9-19 * * mon-fri"]
      timezone = "Europe/Moscow"
      idle_count = 3
      idle_time = "20m0s"
      scale_factor = 1.5
      scale_factor_limit = 20
Проверка состояния и диагностика работы пула
После обновления конфигурационного файла сервис перезапускается и проверяется журнал инициализации:
# Перезапуск демона управления раннерами
sudo systemctl restart gitlab-runner
sudo gitlab-runner status

# Просмотр логов в реальном времени для контроля инициализации плагина
sudo journalctl -u gitlab-runner -f -n 50
В журнале должны появиться подтверждения успешного соединения с интерфейсом AWS SSM и регистрации группы масштабирования. При поступлении тестового задания в GitLab менеджер запросит увеличение мощности, инстанс перейдет в состояние готовности, выполнит задачу и начнет отсчет времени ожидания idle_time.
Эксплуатационные тонкости и преодоление холодного старта
В боевой эксплуатации важно учитывать нюанс холодного старта: создание виртуальной машины в AWS, ее загрузка, инициализация демона Docker и подключение по SSM занимают от 45 до 120 секунд. Если пул находится в нулевом состоянии, первая утренняя сборка вынуждена ждать этот интервал.
Именно поэтому в дневной политике масштабирования используется параметр idle_count = 3. Он указывает менеджеру постоянно удерживать три готовых к работе инстанса в режиме ожидания в промежутке с 9:00 до 19:00 по будням. Приходящие задачи подхватываются моментально без задержек.
Второй критически важный параметр — max_use_count = 5. Он ограничивает число задач, выполняемых на одной машине, после чего инстанс плавно выводится из эксплуатации и уничтожается. Это предотвращает деградацию файловой системы и гарантирует, что накопившиеся временные файлы не исчерпают свободное дисковое пространство. В результате инженеры получают полностью автономную систему, готовую к любым пиковым нагрузкам без ручного вмешательства администраторов.