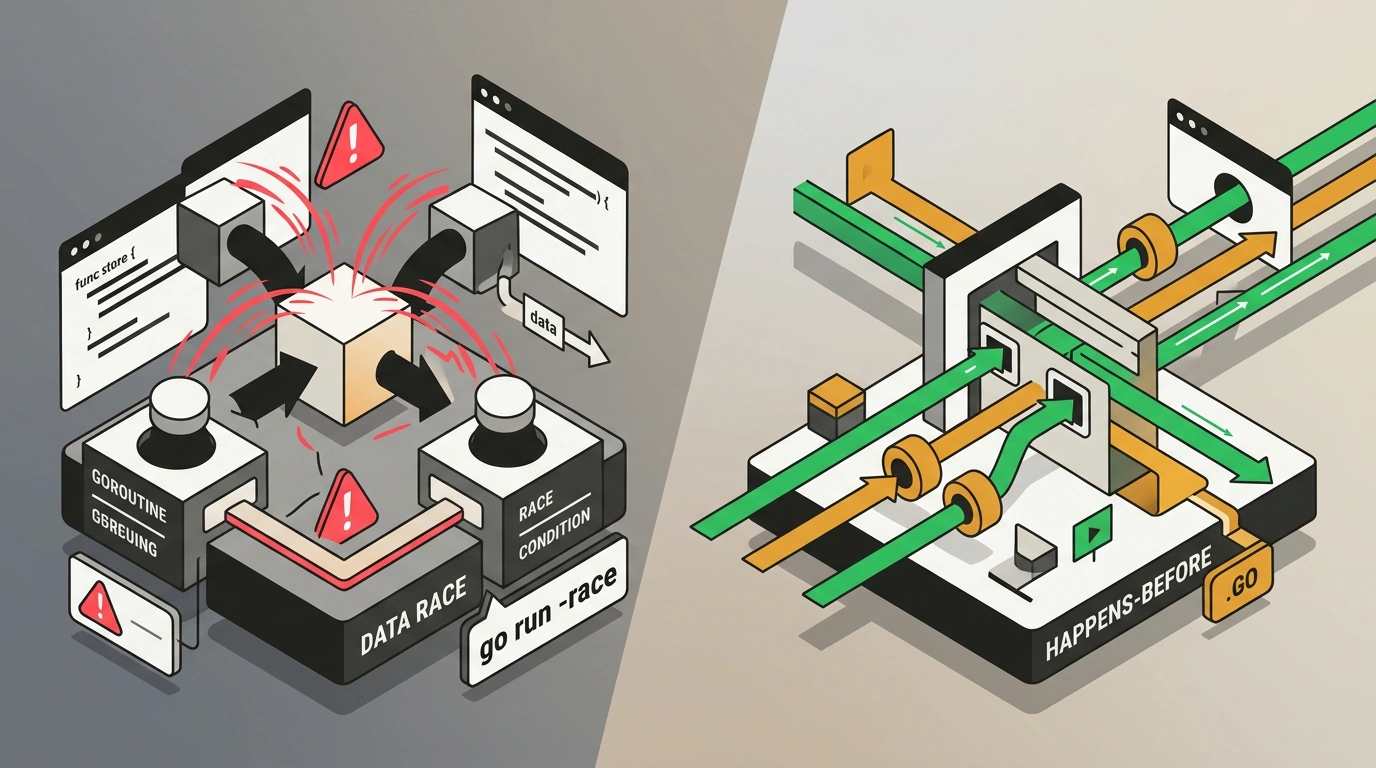

В параллельном программировании на Go существует опасная иллюзия: если программа компилируется без ошибок и локально выдает ожидаемый результат, разработчик считает многопоточную координацию корректной. Однако внешне стабильный код часто скрывает состояние гонки данных (data race), способное разрушить работу сервиса под нагрузкой.
Когда несколько горутин обращаются к общей переменной без механизмов синхронизации, поведение программы перестает быть детерминированным. Ошибки проявляются не сразу: они зависят от архитектуры процессора, оптимизаций компилятора и планировщика операционной системы. Чтобы писать надежные распределенные сервисы, необходимо понимать, как устроена официальная модель памяти Go, почему процессор переупорядочивает инструкции и как стандартные примитивы синхронизации предотвращают повреждение данных.
Анатомия ложной уверенности: как выглядит скрытая гонка данных
Типичный сценарий скрытой гонки — попытка передать результат вычислений из фоновой горутины с помощью самодельного логического флага. Разработчик сохраняет результат в строковую переменную и переключает флаг, пока основной поток ждет этого переключения в цикле:
package main

import (
    "fmt"
)

var (
    done bool
    msg  string
)

func worker() {
    msg = "вычисления завершены"
    done = true
}

func main() {
    go worker()

    for !done {
        // Ожидание завершения фоновой работы
    }

    fmt.Println(msg)
}
При запуске этого фрагмента консоль почти всегда напечатает строку вычисления завершены. Кажется, что логика безупречна: сначала присваивается строка msg, затем выставляется флаг done, а цикл завершает работу только после смены флага.
Однако команда go run -race немедленно фиксирует две критические ошибки Data Race. Первая возникает при одновременной записи в переменную done внутри горутины и ее чтении в цикле for !done. Вторая происходит при чтении строки msg в функции вывода на печать одновременно с ее изменением.
По определению модели памяти Go, состояние гонки данных возникает тогда, когда две или более горутины обращаются к одной ячейке памяти одновременно, хотя бы одно обращение является записью, и между ними нет установленного отношения предшествования (happens-before).
Что делает компилятор: оптимизации SSA и бесконечные циклы
Чтобы понять опасность наивного флага, нужно заглянуть на уровень компилятора Go. При оптимизации промежуточного представления (SSA) компилятор анализирует цикл for !done {}. Внутри тела цикла нет вызовов функций или системных операций, способных изменить глобальное состояние. С точки зрения локального контекста функции main, значение done никем не модифицируется.
В итоге компилятор вправе применить оптимизацию выноса инварианта за пределы цикла или сохранить значение done в регистре процессора один раз перед входом. Машинный код фактически превращается в бесконечный цикл for {}, опрашивающий один и тот же регистр. Если горутина изменит значение done в оперативной памяти миллисекундой позже, поток main об этом не узнает, и программа зависнет, нагружая ядро процессора на 100%.
Подобные оптимизации зависят от версии компилятора, уровня инлайнинга функций и наличия сторонних инструкций. Любой сторонний вызов внутри цикла может временно сбрасывать регистр, маскируя баг до тех пор, пока проект не соберется под новой версией Go в продакшене.
Аппаратный уровень: буферы записи CPU и слабое упорядочивание
Даже если компилятор сгенерирует честное чтение из памяти на каждой итерации, в игру вступает архитектура многоядерных процессоров.
На серверах с архитектурой ARM64 используется слабоупорядоченная модель памяти (weak memory model). Каждое ядро оснащено собственным буфером записи (Store Buffer). Инструкции записи не отправляются сразу в общую память, а накапливаются в локальном буфере, откуда сбрасываются в кэш с задержкой. При этом процессор имеет право переупорядочивать независимые операции:
// Машинный код горутины worker на архитектуре ARM64
// Без барьеров памяти процессор может отправить флаг в кэш раньше данных

ADRP    x0, msg_addr         // Адрес строки msg
STR     x1, [x0]             // Сохранение строки в локальный буфер записи
ADRP    x2, done_addr        // Адрес флага done
MOVB    w3, [x2]             // Запись флага done = true

// На другом процессорном ядре (горутина main)
LDRB    w4, [x2]             // Чтение флага done
CBNZ    w4, print_label      // Если done != 0, переход к чтению msg
LDR     x5, [x0]             // Чтение msg: ядро может прочитать неинициализированный указатель!
Второе ядро может увидеть изменение флага done до того, как строка msg покинет буфер записи первого ядра. Попытка прочитать строку приведет к чтению пустых данных или аварийному завершению программы. Однобайтовая природа bool гарантирует неделимость записи самого байта (MOVB), но не предотвращает переупорядочивание инструкций процессором.
Модель памяти Go и отношение happens-before
Спецификация модели памяти Go (The Go Memory Model) формализует правила видимости результатов записи между горутинами. Ключевое понятие здесь — отношение частичного порядка happens-before («произошло раньше»):
- Внутри одной горутины порядок вычислений соответствует порядку операторов в коде.
- Между разными горутинами запись в память гарантированно видна другой горутине только тогда, когда между ними выстроена явная синхронизирующая граница.
Если запись не связана отношением happens-before с чтением, результат чтения официально не определен: программа может прочитать значение по умолчанию или поврежденное состояние составного объекта.
Исправление антипаттерна: от atomic к мьютексам и каналам
Для устранения гонок стандартная библиотека Go предлагает надежные механизмы, формирующие аппаратные барьеры памяти и строгие отношения happens-before.
package main

import (
    "fmt"
    "sync"
    "sync/atomic"
)

// Вариант 1: Использование sync/atomic для простых флагов
type AtomicCoordinator struct {
    done atomic.Bool
    msg  string
}

func (c *AtomicCoordinator) Run() {
    c.msg = "данные подготовлены через atomic"
    // Атомарная запись выставляет аппаратный барьер памяти
    c.done.Store(true)
}

func (c *AtomicCoordinator) Await() string {
    for !c.done.Load() {
        // Безопасное чтение значения из общей памяти
    }
    return c.msg
}

// Вариант 2: Защита составного состояния через sync.Mutex
type SafeStore struct {
    mu   sync.Mutex
    data string
}

func (s *SafeStore) Set(val string) {
    s.mu.Lock()
    defer s.mu.Unlock()
    s.data = val
}

func (s *SafeStore) Get() string {
    s.mu.Lock()
    defer s.mu.Unlock()
    return s.data
}

func main() {
    // Идиоматичный подход Go: координация через канал
    msgChan := make(chan string, 1)

    go func() {
        msgChan <- "успешная синхронизация через канал"
    }()

    // Чтение из канала блокирует поток без растраты ресурсов CPU
    fmt.Println(<-msgChan)
}
Начиная со спецификации Go 1.19, пакет sync/atomic обеспечивает строгие гарантии памяти: вызов c.done.Store(true) строго предшествует вызову c.done.Load(), вернувшему true. Компилятор и процессор генерируют барьеры памяти, исключая переупорядочивание.
Для защиты взаимосвязанных полей применяется sync.Mutex, обеспечивающий взаимное исключение в критической секции. А для передачи данных между горутинами идиоматично использовать каналы: они не только создают отношение happens-before, но и усыпляют ожидающую горутину, освобождая планировщик от холостых циклов.
Практический чек-лист безопасной параллельности
Правила проверки многопоточного кода в Go
- Запускать автоматические тесты с флагом
-raceна этапе CI. - Не использовать примитивные типы
boolилиintкак флаги безsync/atomic. - Заменять активные циклы опроса каналами или
sync.WaitGroup. - Защищать связанные группы полей единым мьютексом.
- Применять
sync.Onceдля безопасной ленивой инициализации синглтонов.
Конкурентный код в Go требует строгого следования правилам модели памяти. Понимание аппаратных механизмов помогает предотвращать трудноуловимые сбои еще на этапе проектирования архитектуры.