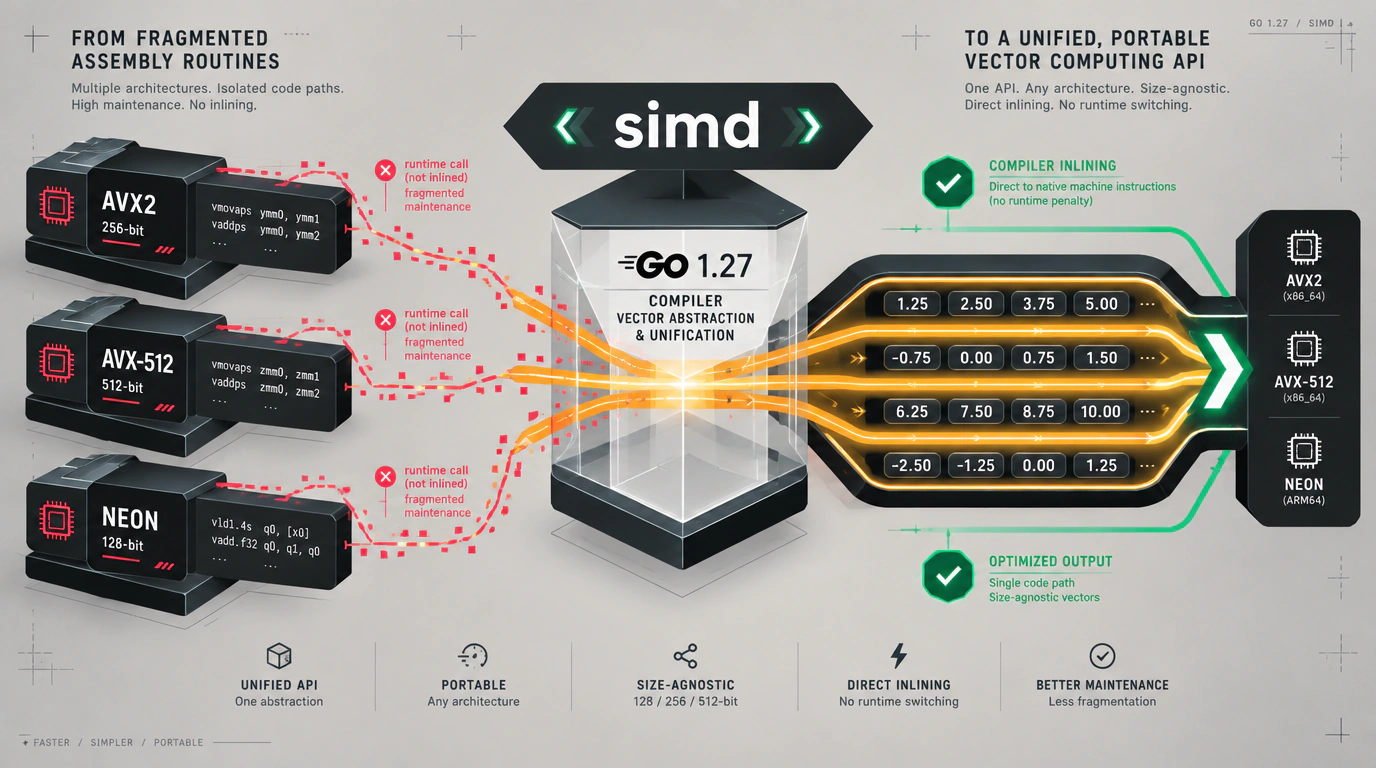

Параллельные вычисления на уровне инструкций процессора (SIMD — Single Instruction, Multiple Data) лежат в основе высокой производительности в числовой обработке данных. Современные процессоры x86-64 и ARM оснащены векторными регистрами шириной 128, 256 и 512 бит. За один такт процессор может выполнить одну операцию — сложение, умножение, сравнение — сразу над массивом из 4, 8 или 16 чисел с плавающей запятой.
Для разработчиков на Go доступ к этим возможностям долгое время оставался серьезным вызовом. Стандартный компилятор Go исторически не предоставлял платформенных интринсиков. Инженерам приходилось писать ассемблерные функции в файлах .s либо генерировать машинный код внешними утилитами. В экспериментальном релизе Go 1.27 представлен пакет simd, призванный изменить эту практику.
Почему ручной ассемблер стал тупиком
Ассемблерные функции в Go имеют заметные издержки. Они не встраиваются компилятором по месту вызова (inlining), поэтому при каждом вызове среда выполнения переключает контекст и сохраняет регистры. Для коротких операций стоимость вызова нередко нивелирует аппаратный выигрыш.
Второй проблемой оставалась фрагментация кодовой базы. Чтобы реализовать векторное ускорение, разработчик создавал и поддерживал несколько реализаций одного алгоритма:
- под AVX2 для архитектуры amd64;
- под AVX-512 для серверов с современными процессорами Intel Xeon и AMD EPYC;
- под расширение NEON для процессоров arm64 (Apple Silicon, AWS Graviton);
- скалярный код на чистом Go для остальных платформ.
Любая правка в логике алгоритма требовала синхронного обновления ассемблерного кода на разных диалектах. В Go 1.26 появился низкоуровневый пакет simd/archsimd для amd64, но он сохранял жесткую привязку к типам конкретной разрядности. В Go 1.27 команда Дэвида Чейза и Цзюньяна Шао из Google предложила переносимый пакет simd.
Концепция Size-Agnostic: устройство нового API
В основу нового пакета легла концепция векторных вычислений без фиксированного размера (Size-Agnostic SIMD), вдохновленная библиотекой Google Highway для C++. Пакет вводит абстрактные типы во множественном числе:
simd.Float32sиsimd.Float64s— для вещественных чисел;simd.Int32s,simd.Int64s,simd.Uint8s— для целых чисел;simd.Mask8s,simd.Mask32s— для масок логических условий.
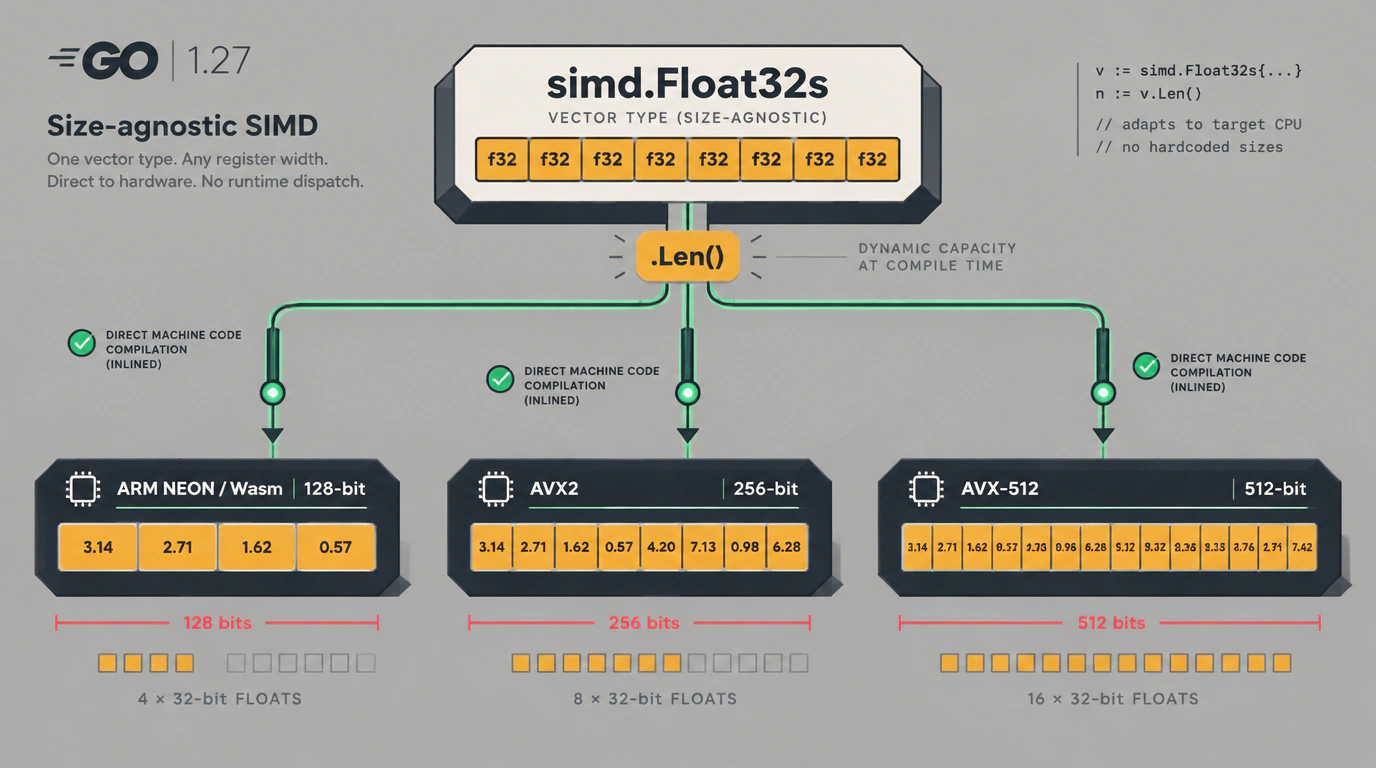
Количество элементов в векторе не фиксируется в коде. Оно определяется на целевой платформе методом .Len(). На процессоре со 128-битными инструкциями ARM NEON или WebAssembly SIMD вектор simd.Float32s вмещает 4 элемента, на AVX2 — 8 элементов, а на AVX-512 — 16 элементов. Компилятор преобразует методы simd напрямую в процессорные инструкции с поддержкой инлайнинга.
Практический сценарий: вычисление скалярного произведения
Рассмотрим задачу вычисления скалярного произведения двух срезов float32, востребованную в машинном обучении и поиске по эмбеддингам. Алгоритм обрабатывает данные блоками длиной acc.Len(), используя метод MulAdd (Fused Multiply-Add):
package main

import (
    "fmt"
    "simd"
)

// InnerProduct вычисляет скалярное произведение двух срезов через SIMD.
func InnerProduct(a, b []float32) float32 {
    if len(a) != len(b) || len(a) == 0 {
        return 0
    }

    var acc simd.Float32s
    step := acc.Len()
    i := 0

    // Основной цикл: параллельная обработка полных векторных регистров
    for i = 0; i <= len(a)-step; i += step {
        va := simd.LoadFloat32s(a[i : i+step])
        vb := simd.LoadFloat32s(b[i : i+step])
        acc = va.MulAdd(vb, acc)
    }

    // Обработка некратного остатка массива через частичную загрузку
    if i < len(a) {
        va, _ := simd.LoadFloat32sPart(a[i:])
        vb, _ := simd.LoadFloat32sPart(b[i:])
        acc = va.MulAdd(vb, acc)
    }

    return horizontalSum(acc)
}

func horizontalSum(v simd.Float32s) float32 {
    buf := make([]float32, v.Len())
    v.Store(buf)
    var total float32
    for _, val := range buf {
        total += val
    }
    return total
}

func main() {
    vecA := []float32{1.5, 2.0, 3.5, 4.0, 5.5, 6.0, 7.5, 8.0, 9.5}
    vecB := []float32{2.0, 1.0, 2.0, 1.0, 2.0, 1.0, 2.0, 1.0, 2.0}
    fmt.Printf("Скалярное произведение: %.2f\n", InnerProduct(vecA, vecB))
}
Конструкция simd.LoadFloat32sPart(a[i:]) безопасно загружает элементы неполного хвоста среза и заполняет остальные позиции нулями. Операция MulAdd выполняется над хвостом за один векторный шаг без риска выхода за границы памяти.
Унифицированное маскирование и условные операции
Разные архитектуры реализуют условные операции над векторами по-разному. В SSE, AVX и ARM NEON маски хранятся в обычных векторных регистрах в виде побайтовых битовых масок. В x86 AVX-512 используются выделенные регистры предикатов (k0-k7), а в ARM SVE — предикатные биты на байт.
Пакет simd объединяет эти механизмы за абстрактными типами масок. Методы сравнения возвращают маску, передаваемую в метод IfElse. Продемонстрируем это на примере функции отсечения отрицательных чисел (ReLU):
package main

import (
    "fmt"
    "simd"
)

// ClampNegative заменяет отрицательные числа в срезе нулями.
func ClampNegative(data []float32) {
    var v simd.Float32s
    step := v.Len()
    zero := simd.BroadcastFloat32s(0.0)
    i := 0

    for i = 0; i <= len(data)-step; i += step {
        chunk := simd.LoadFloat32s(data[i : i+step])

        // Создаем маску: true там, где элемент меньше нуля
        mask := chunk.Less(zero)

        // Условная подстановка: если mask == true, выбираем zero, иначе chunk
        clamped := zero.IfElse(mask, chunk)
        clamped.Store(data[i : i+step])
    }

    for ; i < len(data); i++ {
        if data[i] < 0 {
            data[i] = 0
        }
    }
}

func main() {
    values := []float32{3.2, -1.5, 0.0, -8.4, 12.1, -0.7, 5.6}
    ClampNegative(values)
    fmt.Printf("Результат: %v\n", values)
}
Метод simd.BroadcastFloat32s(0.0) размножает ноль по всему вектору. Вызов chunk.Less(zero) формирует платформенную маску, а zero.IfElse(mask, chunk) транслируется в аппаратную инструкцию слияния (blend), исключая ветвления процессора.
Экосистема и сборщик мусора Green Tea
Пакет simd применяется и для оптимизации самого рантайма Go. В экспериментальном сборщике мусора Green Tea векторные инструкции используются для параллельного сканирования диапазонов адресов в памяти. Это сократило длительность пауз Stop-The-World в высоконагруженных сервисах.
Кроме рантайма, переносимый SIMD востребован в векторных базах данных для расчета расстояний между эмбеддингами без CGO, в криптографических библиотеках и алгоритмах сжатия данных.
Ограничения и запуск эксперимента
Для использования пакета в Go 1.27 требуется флаг компиляции GOEXPERIMENT=simd:
GOEXPERIMENT=simd go build -o app ./main.go
Текущие особенности реализации:
- Горизонтальные редукции: в Go 1.27 нет встроенной функции суммирования элементов одного вектора (
ReduceSum); сворачивание выполняется через выгрузку в буфер. Добавление редукций намечено на Go 1.28. - Программная эмуляция: на платформах без аппаратного SIMD методы транслируются в скалярные циклы на чистом Go, сохраняя работоспособность с небольшими накладными расходами.
- Экспериментальный статус: сигнатуры методов могут корректироваться по итогам тестирования сообществом.
Переносимый пакет simd дает разработчикам на Go возможность писать компактный и безопасный код с аппаратным ускорением на AVX, NEON и WebAssembly, не прибегая к ручному ассемблеру.