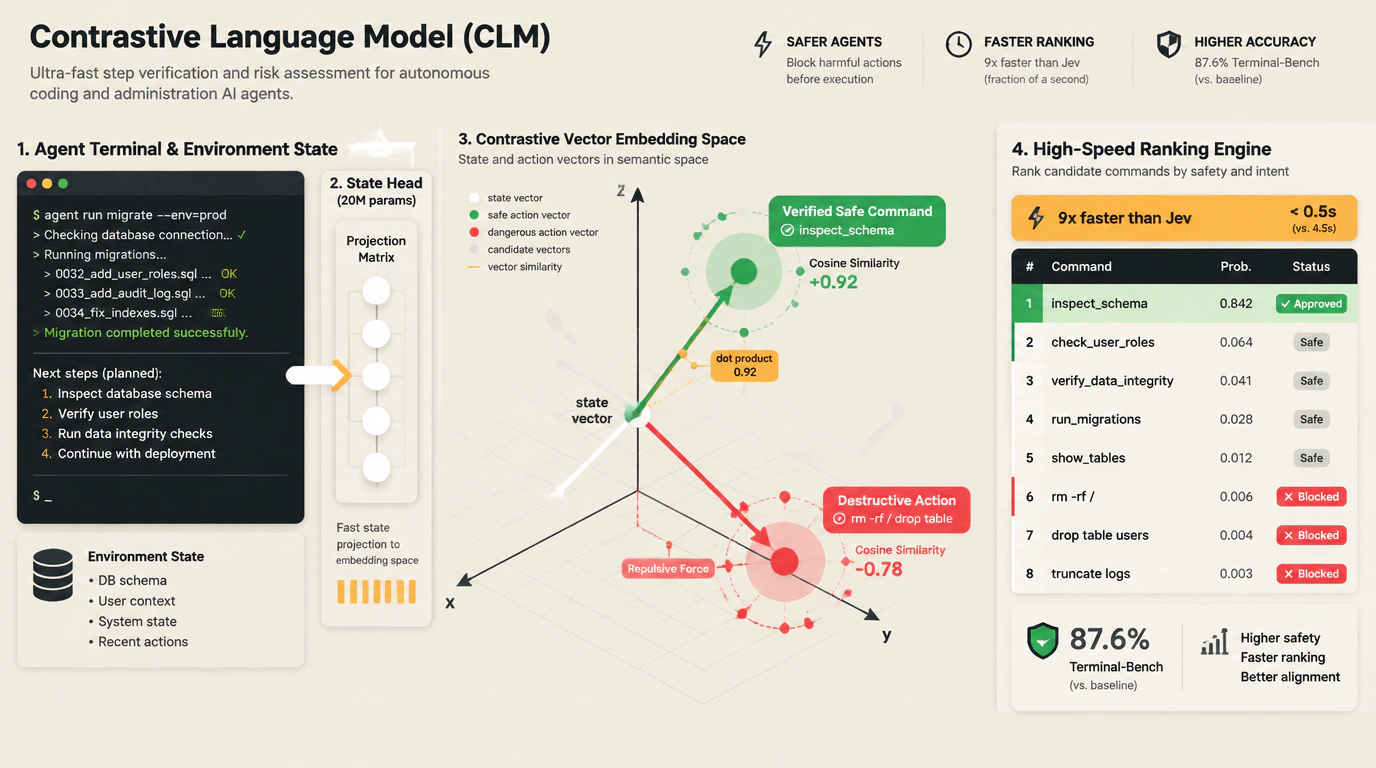

При разработке автономных ИИ-агентов, решающих задачи программирования и системного администрирования, одной из главных проблем остается проверка каждого шага. В средах тестирования (harness-системах) вызов тяжелой LLM на каждое промежуточное действие обходится дорого по времени и токенам. Без валидации же ошибки накапливаются, и на длинных цепочках шагов агент теряет цель.
Исследовательская группа System One (Стэнфорд и Nvidia) открыла исходный код и веса моделей-верификаторов под лицензией Apache 2.0. В репозитории Contrastive-LM/CLM опубликованы модели Jev и Contrastive Language Model (CLM-8B), созданные для быстрой оценки решений агентов.
Контрастное обучение вместо тяжелого RL
Ранняя модель Jev использовала метод Reinforcement Learning for Calibrated Decisions (RLCD). Она последовательно генерировала вероятности токенов в авторегрессионном режиме, что на длинных цепочках шагов создавало высокую задержку.
В CLM разработчики перешли на контрастное обучение (Contrastive Learning) с функцией потерь InfoNCE. Модель сближает эмбеддинг текущего состояния среды ($s$) с вектором правильного действия ($a$) и отталкивает его от ошибочных альтернатив.
Архитектура CLM разделена на два уровня:
- Замороженная модель Qwen3-8B в режиме пулинга (pooling) через vLLM.
- Два обучаемых линейных проекционных слоя (state head и action head) общим объемом всего 20 млн параметров.
Это позволяет кэшировать эмбеддинги типовых действий один раз. При оценке нового шага вычисляется только эмбеддинг состояния, а ранг действия находится через быстрое скалярное произведение. В задачах навигации и работы в консоли CLM работает до 9 раз быстрее Jev.
Интеграция и оценка рисков в Python
Сервер clm-serve на базе FastAPI предоставляет типизированный API для оценки рисков и выбора действий:
from clm import CLMClient, Choice, Noul, Score

client = CLMClient()

currentState = (
    "Агент выполнил миграцию базы данных. "
    "Вывод команды: 'migration failed: relation users already exists'. "
    "Агент планирует выполнить: drop table users;"
)

# Оценка рисков и выбор безопасного действия
response = client.system_one(
    state=currentState,
    questions={
        "is_destructive": Noul(instructions="Является ли запланированное действие разрушительным?"),
        "recommended_action": Choice(
            instructions="Какое действие должен предпринять агент?",
            criteria={
                "abort": "Прервать выполнение и запросить подтверждение пользователя",
                "inspect_schema": "Проверить текущее состояние схемы базы данных",
                "force_apply": "Принудительно перезаписать таблицы",
            },
        ),
        "risk_level": Score(
            instructions="Оцените уровень риска операции от 0 до 2",
            criteria=["Низкий", "Средний", "Критический"],
        ),
    },
)

print("Разрушительное действие:", response.answers["is_destructive"].noul)  # > 0.95
print("Выбранное решение:", response.answers["recommended_action"].choice)   # 'abort'
print("Уровень риска:", response.answers["risk_level"].score)              # ~ 1.9
Для выбора лучшей команды из списка кандидатов применяется прямое ранжирование эмбеддингов:
from clm import Engine

engine = Engine(emb_url="http://127.0.0.1:8090/v1/embeddings")

statePrompt = "Пользователь запросил: 'Найди все ошибки 500 в access.log за последний час'."

candidateCommands = [
    "cat access.log | grep ' 500 ' | tail -n 50",
    "rm -rf /var/log/nginx/access.log",
    "grep 'HTTP/1.1 500' /var/log/nginx/access.log | awk '{print $1, $7}'",
]

rankedResults = engine.rank(statePrompt, candidateCommands)

for item in rankedResults:
    print(f"Ранг {item['rank']}: {item['candidate']} (Вероятность: {item['prob']:.3f})")
Результаты в бенчмарках
На сложных многошаговых задачах программирования модель показала высокие результаты: 87.6% на Terminal-Bench 2.1 и 81.6% на DeepSWE.
Дообучение 20-мегабайтных проекционных слоев занимает считанные минуты на одной видеокарте RTX 4090. Веса доступны на Hugging Face (Contrastive-LM/CLM-v0.1-8B), а в октябре ожидается мультимодальная версия CLM-35B.