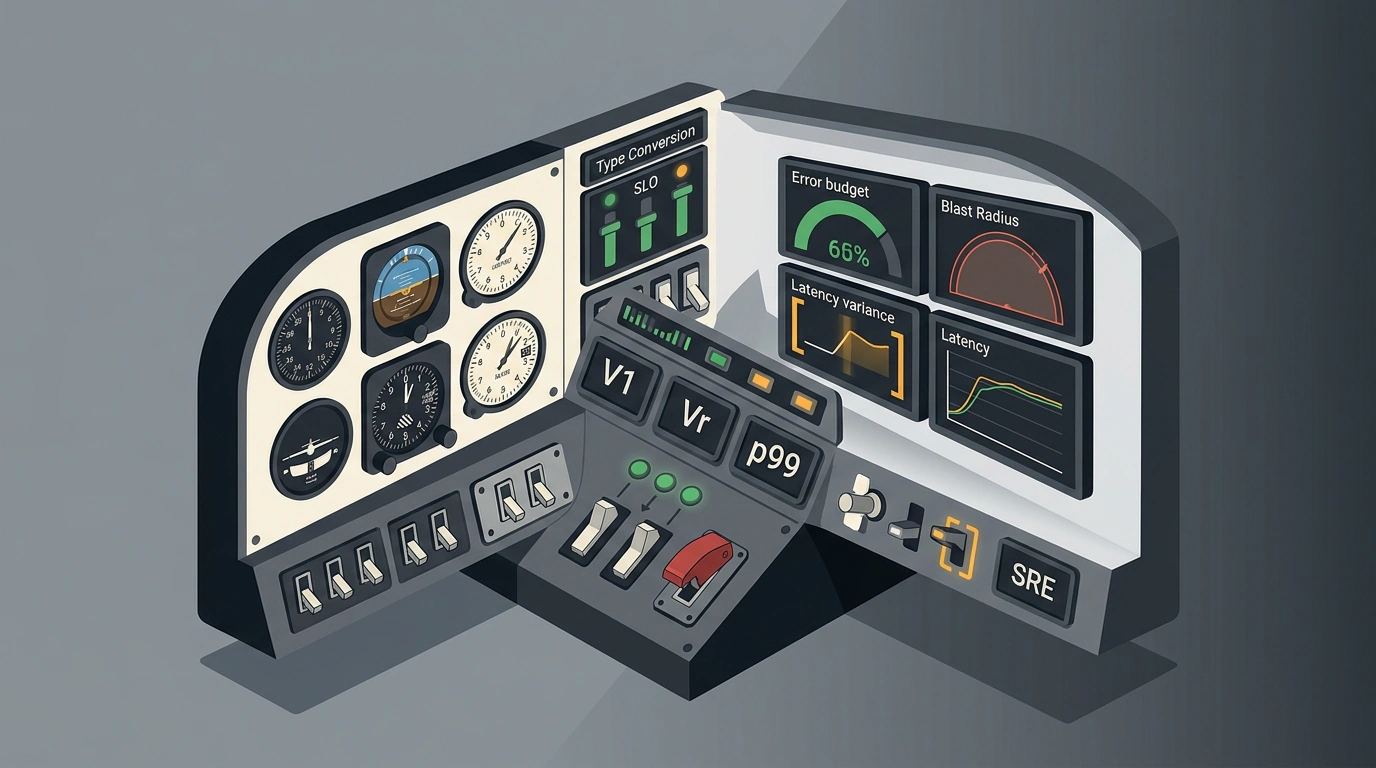

Когда опытный пилот авиакомпании пересаживается со среднемагистрального Airbus A320 на трансконтинентальный Boeing 777, авиационный регулятор не отправляет его заново учить законы физики. Никто не объясняет пилоту с тысячами часов налета, откуда берется подъемная сила или почему самолет теряет управляемость при сваливании. Вместо этого летчик проходит стандартизированную программу Type Conversion — переучивание на тип воздушного судна. Вся ее цель сводится к одной задаче: понять, как базовые принципы полета реализованы в новой кабине и где физически находятся органы управления.
Инженер по надежности инфраструктуры Билл Дункан перенес эту авиационную метафору в разработку распределенных систем. Концепция Type Conversion объясняет, почему онбординг сеньор-инженеров SRE часто превращается в полосу препятствий и как преодолеть период адаптации без аварий в продакшене.
Неизменные законы аэродинамики в незнакомом облаке
Главная ошибка инженера на новом месте работы — ощущение, что все накопленные знания обесценились. Инфраструктура выглядит непривычно: вместо привычного кластера Kubernetes на AWS компания использует Nomad на собственных серверах, а метрики собираются не в Prometheus, а в самописную систему телеметрии.
Однако законы надежности распределенных систем фундаментальны и действуют везде одинаково, подобно силам гравитации и аэродинамического сопротивления:
- Радиус поражения (blast radius): любое изменение конфигурации должно быть изолировано так, чтобы сбой затронул минимальную долю пользователей;
- Бюджеты ошибок (error budgets): баланс между скоростью поставки фич и доступностью сервиса опирается на математику допустимого простоя;
- Обратимость действий: любое развертывание обязано иметь протестированный план быстрого отката назад;
- Временные окна корреляции: при анализе инцидента метрики ошибок и задержек всегда сопоставляются во времени с сетевыми всплесками и релизами.
Эти принципы не зависят от вендора облака или языка микросервисов. Меняется только расположение тумблеров на приборной панели.
Ловушка мышечной памяти: когда рефлексы приводят к авариям
В авиации переход на другой самолет опасен рефлексами. Если в экстренной ситуации пилот машинально потянет рычаг там, где он находился в старом самолете, последствия будут катастрофическими. Например, на легком самолете Piper Cherokee закрылки выпускаются механическим рычагом на полу кабины, а на Cessna 172 — электрическим тумблером на приборной доске.
В IT-инженерии мышечная память работает точно так же. Инженер, годами использовавший декларативный GitOps в ArgoCD, привык, что фиксация коммита в ветке main автоматически синхронизирует состояние продакшена. Попадая в компанию с полуавтоматическими пайплайнами в Jenkins или ручными релизными окнами, он рискует применить привычный паттерн вслепую, вызвав рассинхронизацию баз данных или падение сервиса.
Поиск V-скоростей и калибровка приборной панели
В гражданской авиации каждый борт имеет уникальный набор так называемых V-скоростей: скорость принятия решения о взлете (V1), скорость отрыва передней стойки (Vr) и предельная скорость выпуска закрылков. Пилот обязан знать эти цифры наизусть перед тем, как взяться за штурвал.
Для инженера SRE аналогом V-скоростей служат локальные пороговые значения системы:
- Критический порог задержки ответа (latency p99), при котором срабатывает автоматический сброс нагрузки (circuit breaker);
- Лимиты емкости очередей сообщений перед началом отбрасывания пакетов;
- Правила эскалации алертов: какие события требуют ночного звонка дежурному инженеру, а какие терпят до утреннего стендапа;
- Соглашения об уровне обслуживания (SLO) ключевых платежных и пользовательских шлюзов.
Попытка дежурить без четкого знания этих порогов превращает мониторинг в гадание на кофейной гуще.
Полеты с инструктором и дорожная карта первых недель
Чтобы процесс Type Conversion прошел гладко, первые тридцать дней инженеру стоит посвятить картографированию систем, а не переписыванию инфраструктуры.
Лучшая практика — парные дежурства (shadow on-call), когда новичок наблюдает за действиями опытного коллеги во время реальных инцидентов. Это позволяет увидеть, каким графикам в дашбордах команда доверяет безоговорочно, а какие показания давно искажены запаздыванием сборщиков логов.
Вместо попыток навязать незнакомой инфраструктуре архитектурные шаблоны с прошлого места работы разумный инженер сначала составляет карту приборов, калибрует телеметрию и выясняет исторические причины локальных компромиссов. Только поняв, как управляется конкретный самолет, можно уверенно вести его сквозь зоны турбулентности.