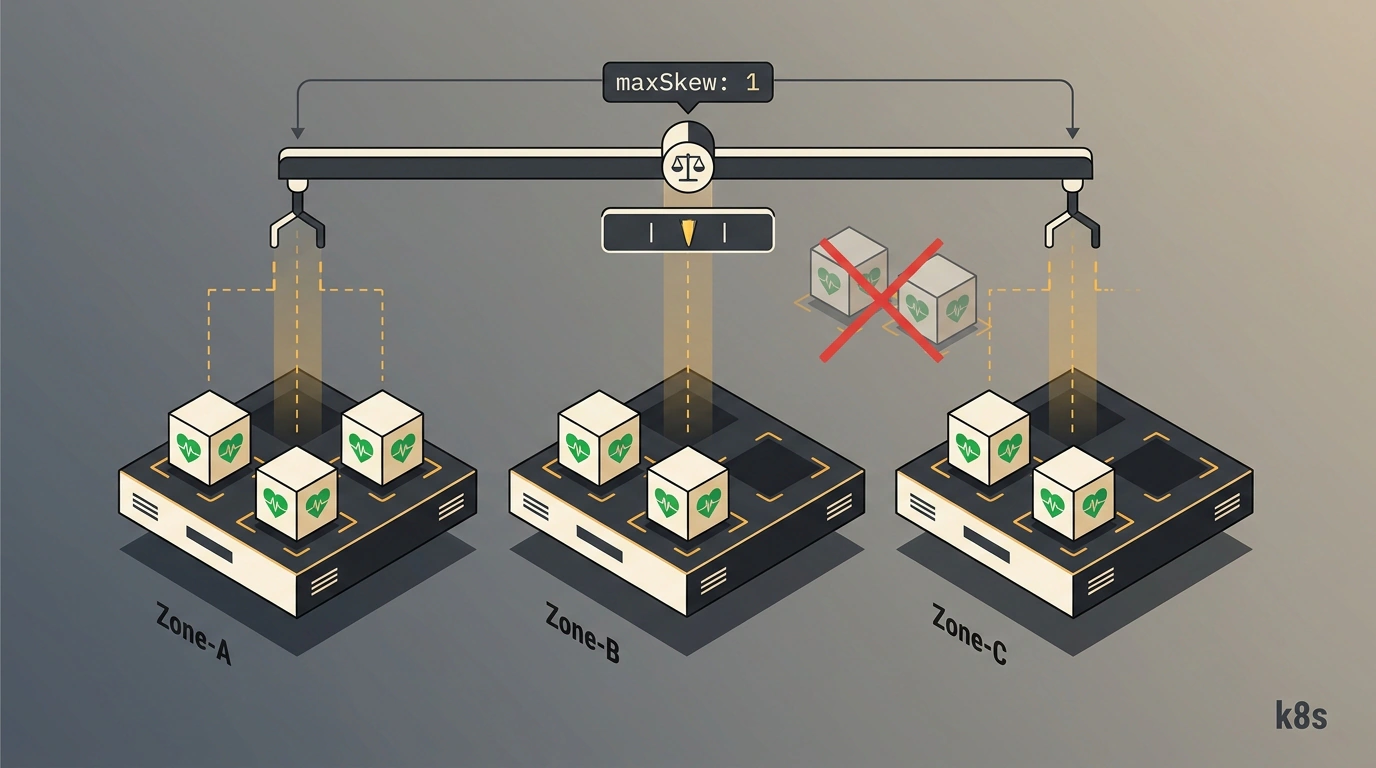

Представьте классическую ситуацию: вы разворачиваете критически важный сервис в облачном кластере Kubernetes. Инфраструктура честно разделена на три независимые зоны доступности (дата-центра). В манифесте Deployment указано шесть реплик приложения — кажется, что сервис защищен от любых катаклизмов.
Но вот в одном из дата-центров происходит авария питания, и ваш сервис внезапно становится полностью недоступен. Расследование показывает неприятную картину: стандартный планировщик kube-scheduler, руководствуясь исключительно доступностью оперативной памяти и ядер процессора на серверах, разместил пять из шести ваших подов именно в том дата-центре, который обесточило.
Решить эту проблему раз и навсегда позволяет механизм Topology Spread Constraints, дающий декларативный контроль над географией размещения контейнеров.
Почему стандартного podAntiAffinity больше недостаточно
Долгое время инженеры пытались решать проблему концентрации с помощью правил анти-сродства (podAntiAffinity). Но этот механизм слишком категоричен:
- Правило
requiredDuringSchedulingработает бинарно: оно либо разрешает запустить строго один под на узел, либо блокирует развертывание. Если у вас 10 подов и всего 3 сервера, планировщик просто откажется запускать «лишние» реплики, оставив их висеть в статусе Pending; - Правило
preferredDuringSchedulingработает слишком мягко: планировщик воспринимает его как ни к чему не обязывающее пожелание и при малейшей нехватке ресурсов охотно сваливает все поды на один хост.
Topology Spread Constraints устраняет эту крайность, вводя математически выверенную степень допустимого перекоса между зонами или серверами.
Математика перекоса: как рассчитывается maxSkew
Центральное понятие механизма — параметр maxSkew (максимальный перекос). Это предельная разница между числом подов вашего приложения в рассматриваемой зоне и минимальным количеством подов в любой другой подходящей зоне:
перекос = поды[текущая_зона] + 1 - минимум[подходящие_зоны]
Если значение maxSkew равно 1, планировщик никогда не допустит ситуации, при которой в зоне А работают три пода, пока в зоне Б запущен всего один. Разница между зонами никогда не превысит единицу.
Поведение при невозможности соблюсти баланс регулируется атрибутом whenUnsatisfiable:
DoNotSchedule: жесткий запрет. Под не запустится, если его появление нарушит баланс (полезно для строгих отказоустойчивых кластеров);ScheduleAnyway: мягкий режим. Планировщик отдаст максимальный приоритет наименее загруженной зоне, но если свободных ресурсов там нет, запустит под там, где есть место.
Процедура аудита и выявления незащищенных сервисов
Перед настройкой ограничений необходимо убедиться, что узлы кластера размечены стандартными топологическими метками облачного провайдера, и найти уязвимые рабочие нагрузки:
# 1. Проверка наличия топологических меток зон доступности
kubectl get nodes --show-labels | grep -E "topology.kubernetes.io/(zone|region)"

# 2. Поиск подов, у которых не настроены ограничения распределения
kubectl get pods -A -o json | jq -r '.items[] | select(.spec.topologySpreadConstraints == null) | "\(.metadata.namespace)/\(.metadata.name)"'
Новые политики для гибридных кластеров: Honor для taints и affinity
В современных версиях Kubernetes механизм получил важные улучшения: параметры nodeAffinityPolicy и nodeTaintsPolicy.
Раньше планировщик при подсчете минимального числа подов в зоне учитывал абсолютно все узлы, даже если они были помечены специальными ограничениями (taints) — например, предназначались исключительно под тяжелые базы данных или видеокарты. Из-за этого расчет минимального числа сбивался, и поды зависали в бесконечном ожидании.
Значение Honor указывает планировщику учитывать только реально доступные для приложения узлы:
apiVersion: apps/v1
kind: Deployment
metadata:
  name: payment-service
  namespace: production
spec:
  replicas: 6
  selector:
    matchLabels:
      app: payment-service
  template:
    metadata:
      labels:
        app: payment-service
    spec:
      topologySpreadConstraints:
        # Равномерное распределение по зонам доступности дата-центров
        - maxSkew: 1
          topologyKey: topology.kubernetes.io/zone
          whenUnsatisfiable: DoNotSchedule
          nodeAffinityPolicy: Honor
          nodeTaintsPolicy: Honor
          labelSelector:
            matchLabels:
              app: payment-service
        # Дополнительная балансировка по физическим серверам внутри зон
        - maxSkew: 1
          topologyKey: kubernetes.io/hostname
          whenUnsatisfiable: ScheduleAnyway
          labelSelector:
            matchLabels:
              app: payment-service
      containers:
        - name: web
          image: registry.example.com/payment:v2.4.1
          ports:
            - containerPort: 8080
Практический регламент внедрения в продакшен
Золотое правило настройки надежности: комбинируйте уровни топологии. На уровне зон доступности (topology.kubernetes.io/zone) используйте строгий maxSkew: 1 с режимом DoNotSchedule, гарантируя, что падение целого дата-центра уничтожит лишь расчетную долю реплик. А на уровне отдельных серверов (kubernetes.io/hostname) задавайте мягкий режим ScheduleAnyway, предотвращая проблемы при локальной нехватке серверных мощностей.