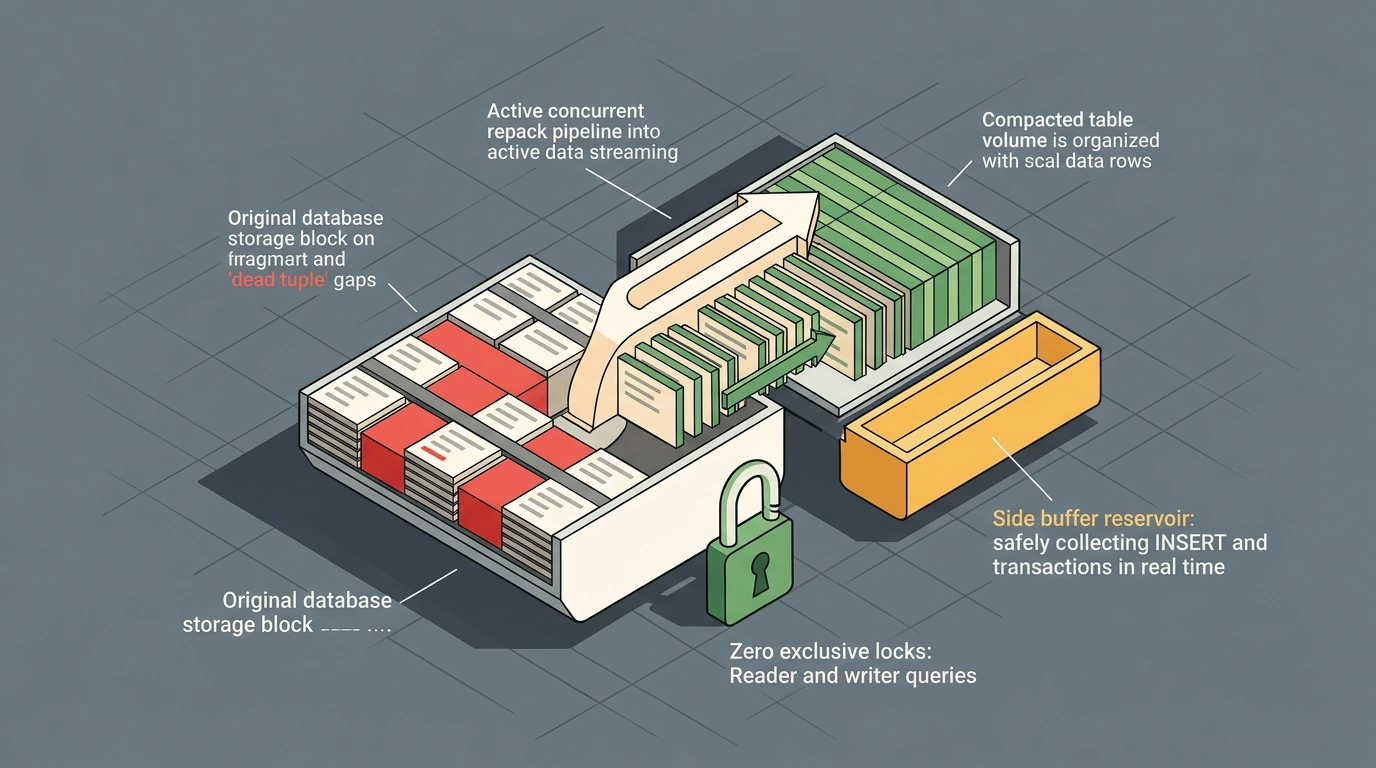
Раздувание таблиц и индексов (table bloat) — хроническая плата за многоверсионное управление параллельным доступом (MVCC) в PostgreSQL. Когда строки обновляются или удаляются, старые версии данных остаются на диске в ожидании очистки. Если объем мертвых строк накапливается быстрее, чем с ними справляется фоновый автовакуум, таблицы начинают занимать гигабайты пустого пространства, а сканирование диска катастрофически замедляется. Традиционная команда VACUUM FULL возвращает диск операционной системе, но требует жесткой блокировки AccessExclusiveLock, замораживая доступ к таблице для читателей и писателей.
Чтобы бороться с раздуванием на лету в живом продакшене, инженерам годами приходилось устанавливать сторонние расширения — в первую очередь утилиту pg_repack. Однако в бета-версии PostgreSQL 19 сообщество разработчиков ядра сделало исторический шаг: добавило нативную встроенную команду REPACK [CONCURRENTLY].
Архитектурный прорыв ядра: онлайн-дефрагментация в стандарте SQL
Главное достоинство нативной команды — доступность без лишних прав и привилегий. Стороннее расширение pg_repack требует установки Си-библиотек на уровне сервера, прав суперпользователя и регистрации триггеров на целевой таблице, что делает его недоступным во многих управляемых облачных базах данных (AWS RDS, GCP Cloud SQL).
Встроенная команда ядра выполняется через стандартный SQL-запрос, поддерживая параллельное копирование данных и перестроение структуры:
-- Онлайн-дефрагментация таблицы заказов без блокировки чтения и записи
REPACK TABLE orders CONCURRENTLY;

-- Дефрагментация с ограничением нагрузки на дисковую подсистему и параллелизмом
REPACK TABLE orders CONCURRENTLY WITH (
  PARALLEL = 4,
  BUFFER_USAGE_LIMIT = '256MB'
);
Во время выполнения REPACK CONCURRENTLY движок создает теневую копию таблицы, переносит туда только живые строки, параллельно накапливает новые входящие изменения (INSERT, UPDATE, DELETE) во временный буфер и в финале за доли секунды подменяет файловые дескрипторы.
Бенчмарки Radim Marek: скорость и объем WAL-журнала
Исследователь Радим Марек опубликовал подробный сравнительный бенчмарк нового встроенного механизма против ветеранов pg_repack и pg_squeeze. Результаты удивили даже скептиков:
- По общему времени выполнения нативный
REPACK CONCURRENTLYобошел внешние расширения на 15–25% за счет прямого доступа к внутренним структурам ядра и отсутствия накладных расходов на PL/pgSQL-триггеры. - По объему генерируемых WAL-журналов встроенный репак оказался самым экономичным, что критично для систем с асинхронной репликацией, где взрывной рост WAL угрожает отставанием реплик (replication lag).
Для контроля за процессом администраторы могут отслеживать прогресс выполнения через стандартное представление:
-- Мониторинг прогресса дефрагментации в реальном времени
SELECT
  pid,
  phase,
  tuples_total,
  tuples_done,
  current_wal_lsn
FROM pg_stat_progress_repack;
Тонкие места и цена параллельных изменений
Несмотря на триумф в тестах, говорить о безоговорочной замене pg_repack пока преждевременно. Интенсивная запись обнажает ряд архитектурных нюансов:
Во-первых, буфер параллельных изменений имеет предел пропускной способности. Если во время репака в таблицу летят тысячи параллельных транзакций в секунду, финальная фаза догонки изменений может затягиваться. В рассылке pgsql-hackers перед выходом Beta 4 был исправлен критический баг потери параллельных обновлений при переключении таблицы, что подчеркивает сложность механизма.
Во-вторых, на протяжении всей операции репак удерживает открытый снимок транзакции. В высоконагруженных СУБД долгий снимок мешает автовакууму очищать мертвые кортежи в других таблицах кластера, провоцируя вторичное раздувание.
Встроенный REPACK CONCURRENTLY в PostgreSQL 19 — мощнейший шаг вперед, который снимет головную боль с тысяч команд. Однако для экстремально нагруженных OLTP-систем с сотнями тысяч записей в секунду инженерам все еще потребуется тщательно планировать окно запуска и калибровать параметры буфера.