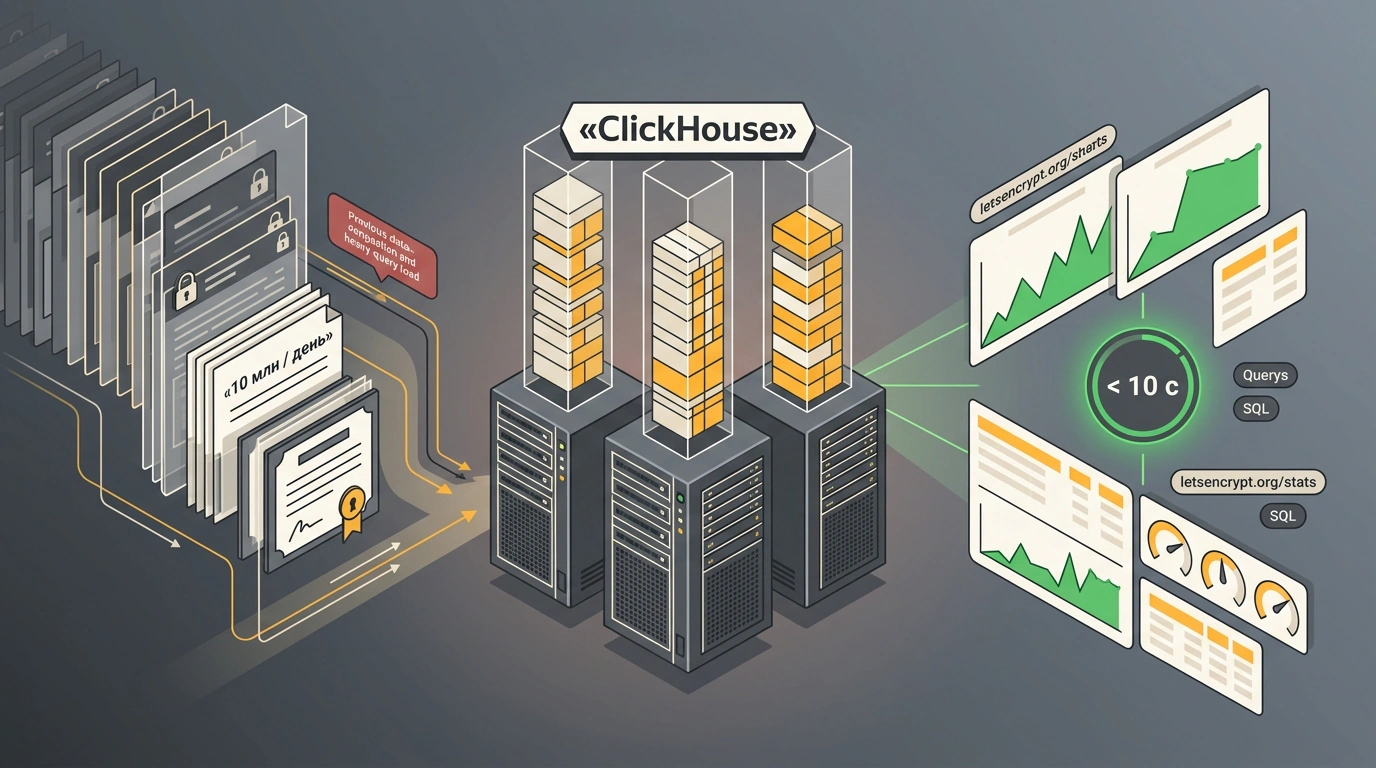

Каждый раз, когда в адресной строке браузера загорается значок защищенного соединения, с высокой вероятностью за этим стоит инфраструктура Let's Encrypt. Некоммерческий удостоверяющий центр под эгидой организации Internet Security Research Group (ISRG) ежедневно генерирует от 6 до 10 миллионов бесплатных криптографических сертификатов. Это гигантская фабрика доверия, обслуживающая сотни миллионов сайтов по всему миру.
Однако за внешней простотой автоматического получения сертификата скрывается лавина служебных логов. Каждый выпуск сопровождается проверкой владения доменом, сетевыми запросами к авторитетным DNS-серверам и криптографическими подписями. Долгое время инженеры Let's Encrypt сталкивались с парадоксом: организация обладала петабайтами ценнейших телеметрических данных, но извлечение из них практического смысла превращалось в многочасовую пытку для серверов.
Логи масштаба планеты: почему транзакционная база сдалась
Архитектура сервиса Boulder, на котором держится выпуск сертификатов Let's Encrypt, изначально проектировалась под классическую транзакционную нагрузку (OLTP). Его реляционная база данных MariaDB оптимизирована под сверхбыструю запись отдельных транзакций и строгую согласованность. Она безупречно справляется с задачей выдать сертификат за доли секунды, но категорически не приспособлена для глубоких аналитических выборок.
Когда аналитикам или инженерам по безопасности требовалось ответить на, казалось бы, тривиальные вопросы — например, сколько сертификатов за последние полгода было выпущено с профилем короткого срока действия (shortlived) или какие доменные зоны растут быстрее всего, — начинались проблемы. Запуск тяжелого агрегационного запроса к основной базе угрожал замедлить или вовсе заблокировать текущую выдачу сертификатов для реальных пользователей.
Второй распространенный путь — коммерческие облачные сервисы для сбора и поиска по логам — быстро завел команду в тупик стоимости. Счета за индексацию терабайтов сырого текста росли в геометрической прогрессии. При этом подобные SaaS-платформы отлично находят отдельные строки по ключевым словам, но пасуют перед математическими агрегациями и сложными SQL-выборками с группировкой по миллионам записей. Требовалось собственное хранилище данных (DWH), способное перемалывать миллиарды событий без космических затрат.
Три сервера и 100 терабайт: архитектура нового DWH
Вместо построения громоздкого распределенного кластера из десятков виртуальных машин в публичном облаке команда Let's Encrypt сделала ставку на собственное «железо» и колоночную СУБД ClickHouse. В дата-центре развернули кластер всего из трех физических серверов Dell PowerEdge R7715.
Конфигурация каждого серверного узла впечатляет плотностью ресурсов:
- 32-ядерный процессор AMD EPYC 9355P с базовой частотой 3.55 ГГц;
- 384 гигабайта оперативной памяти DDR5;
- 32 твердотельных накопителя NVMe емкостью по 3.2 терабайта каждый.
Суммарно каждый сервер получил порядка 100 терабайт сверхбыстрого сырого дискового пространства. Благодаря колоночному формату хранения и эффективным алгоритмам сжатия данных (ZSTD и LZ4) колоссальный массив информации за 100 дней непрерывной работы удостоверяющего центра занял лишь около 14% совокупной емкости дисков. То, что раньше требовало бесконечных полок с жесткими дисками, компактно уместилось в одной серверной стойке.
ReplacingMergeTree и магия работы с массивами доменов
Ключевым архитектурным решением при проектировании схемы таблиц стал выбор движка ReplacingMergeTree. В аналитических системах неизбежно возникают ситуации, когда исторические данные приходится перезаливать: исправляются ошибки в логике парсинга, восполняются пробелы после сетевых сбоев или пересчитываются составные метрики.
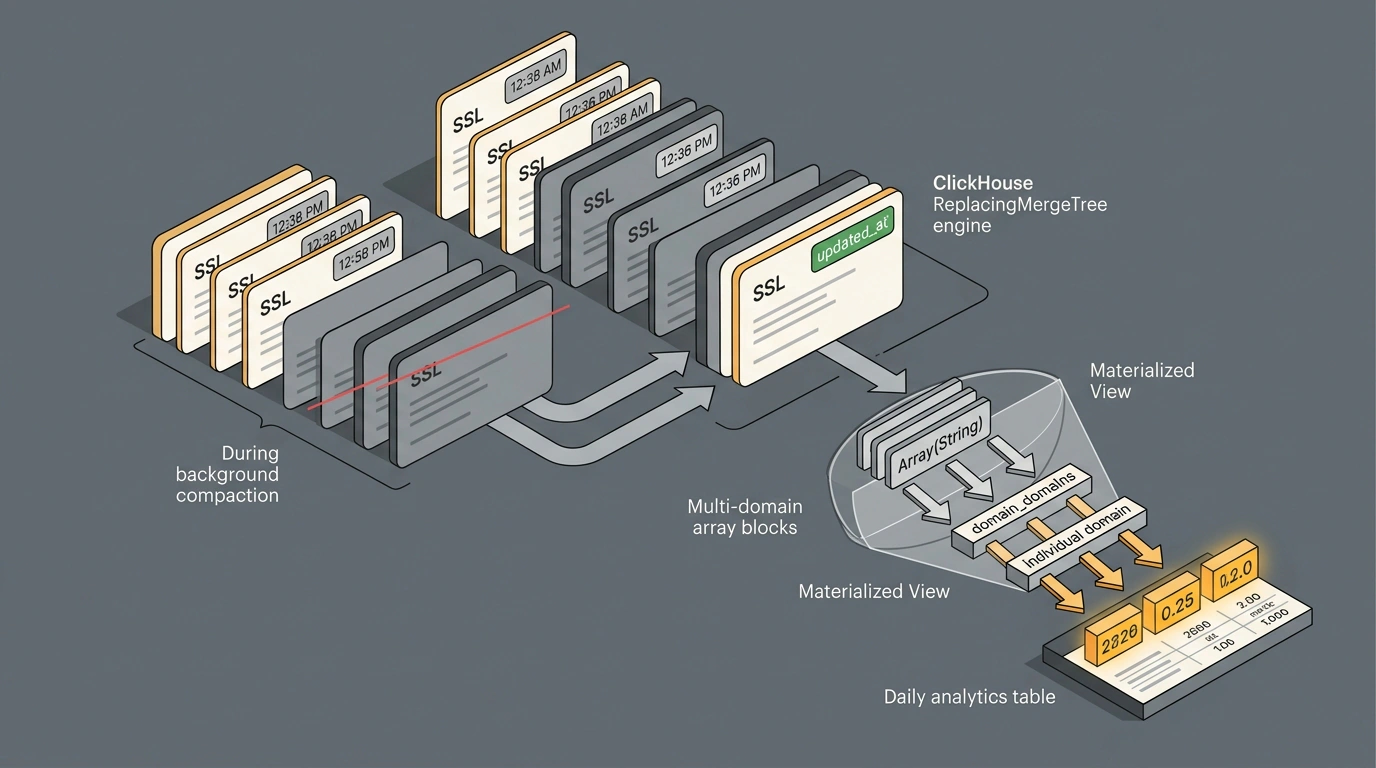
Обычные реляционные таблицы при повторной вставке либо выдают ошибку первичного ключа, либо требуют тяжелых операций UPSERT. Движок ReplacingMergeTree в ClickHouse решает эту задачу элегантно: он принимает новые порции данных на максимальной скорости, а затем в фоновом режиме во время слияния кусков (merge) автоматически удаляет устаревшие дубликаты, оставляя строку с самым свежим значением метки времени updated_at.
-- Создание базы данных аналитического контура
CREATE DATABASE IF NOT EXISTS boulder;

-- Целевая таблица для хранения структурированных событий выпуска
CREATE TABLE boulder.cert_issuances
(
    id UUID,
    serial_number String,
    not_before DateTime,
    not_after DateTime,
    profile LowCardinality(String),
    identifiers Array(Tuple(type String, value String)),
    etld_plus_one Array(String),
    updated_at DateTime DEFAULT now()
)
ENGINE = ReplacingMergeTree(updated_at)
PARTITION BY toYYYYMM(not_before)
ORDER BY (profile, not_before, id);
Особую сложность в структуре сертификатов представляют доменные имена. Один сертификат может защищать десятки альтернативных имен (Subject Alternative Names, SAN). В традиционных базах для этого потребовалась бы отдельная связанная таблица и ресурсоемкие операции JOIN. ClickHouse позволяет хранить списки доменов прямо в строке в виде массивов Array(String).
Для мгновенного расчета публичной статистики инженеры настроили материализованные представления (Materialized Views). Они работают как встроенные триггеры: при поступлении новой пачки сертификатов ClickHouse на лету распаковывает массивы доменов с помощью функции arrayJoin, отфильтровывает нужные типы через arrayFilter и агрегирует счетчики уникальных хостов через вероятностный алгоритм uniq (HyperLogLog), складывая готовые суммы в отдельную витрину данных:
-- Таблица-приемник предподсчитанных ежедневных метрик
CREATE TABLE boulder.daily_stats_aggregated
(
    date Date,
    fqdns_active UInt64,
    reg_domains_active UInt64
)
ENGINE = SummingMergeTree()
ORDER BY (date);

-- Материализованное представление с обработкой вложенных массивов
CREATE MATERIALIZED VIEW boulder.daily_stats_mv
TO boulder.daily_stats_aggregated
AS SELECT
    toDate(not_before) AS date,
    uniq(arrayJoin(arrayMap(x -> x.value, arrayFilter(x -> x.type = 'dns', identifiers)))) AS fqdns_active,
    uniq(arrayJoin(etld_plus_one)) AS reg_domains_active
FROM boulder.cert_issuances
WHERE not_before >= yesterday() - 90
  AND not_after >= yesterday()
  AND not_before <= yesterday()
GROUP BY date;
Ловушка потоковых агентов и спасительный импорт из S3
На этапе наполнения нового хранилища команда столкнулась с поучительной инженерной проблемой. Для доставки свежих логов использовался стандартный агент OpenTelemetry Collector (OTel). В режиме реального времени он стабильно передавал поток событий с серверов валидации.
Однако когда инженеры попытались прогнать через OTel Collector исторический архив за предыдущие месяцы, система дала сбой. Потоковый агент оказался не рассчитан на терабайтные лавины данных: буферы переполнились, сработали внутренние механизмы защиты от перегрузки (rate limiting), и коллектор начал молча отбрасывать события без явного уведомления об ошибке.
Спасением стала нативная интеграция ClickHouse с объектными хранилищами через табличную функцию s3(). Инженеры выгрузили архивные логи в S3-совместимый шлюз в формате Apache Parquet и выполнили прямой импорт силами самого ClickHouse:
-- Пакетная загрузка исторического архива логов напрямую из объектного хранилища
INSERT INTO boulder.cert_issuances
SELECT
    toUUID(id),
    serial_number,
    parseDateTimeBestEffort(not_before),
    parseDateTimeBestEffort(not_after),
    profile,
    identifiers,
    etld_plus_one,
    now()
FROM s3('https://s3.internal.letsencrypt.org/historical-logs/2026/*/*.parquet', 'AWS_KEY', 'AWS_SECRET', 'Parquet');

-- Опциональное принудительное схлопывание дубликатов для мгновенной консистентности
OPTIMIZE TABLE boulder.cert_issuances FINAL DEDUPLICATE;
Такой подход позволил залить сотни миллионов исторических строк за считаные минуты с полной утилизацией пропускной способности сети и дисковых массивов, обойдя все промежуточные звенья.
Практические уроки для инженеров данных
Результаты миграции превзошли самые смелые ожидания. Расчет публичной статистики для официального портала letsencrypt.org/stats, который раньше занимал несколько часов пакетной обработки скриптами, сократился до менее чем 10 секунд. Аналитические запросы по срезам сертификатов за полгода стали отрабатывать за десятки миллисекунд.
Что еще важнее — кардинально изменилась скорость реакции на инциденты безопасности. Если в криптографической библиотеке или центре валидации обнаруживается ошибка, инженеры могут мгновенно выполнить точечный поиск по серийным номерам и сертификационным цепочкам среди миллиардов записей, не опасаясь уронить боевую транзакционную базу.
Опыт Let's Encrypt наглядно демонстрирует: не всякая масштабная задача требует раздувания облачных бюджетов и построения распределенных монстров на сотни нод. Грамотно подобранное аппаратное обеспечение в сочетании с профильной колоночной СУБД способно в одиночку решить проблемы аналитики глобального сервиса, обеспечив феноменальную производительность при минимальных затратах.