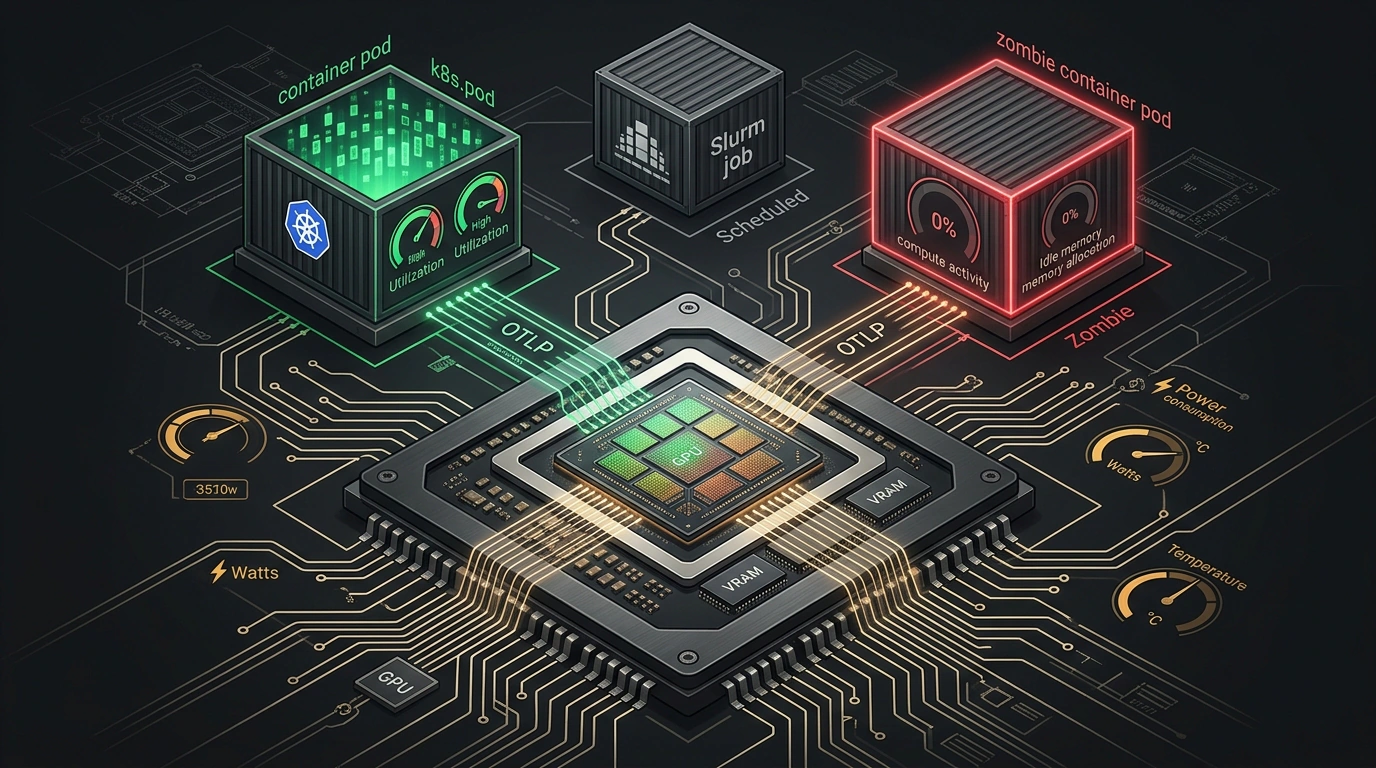

Инфраструктура для машинного обучения и запуска больших языковых моделей (LLM) стала самой дорогой статьей расходов современных инженерных команд. Аренда даже небольшого кластера с ускорителями NVIDIA H100 или A100 обходится в десятки тысяч долларов ежемесячно. Однако когда инженеры открывают стандартные дашборды мониторинга, они сталкиваются с парадоксом: видеокарты загружены под завязку или греются до предельных температур, но понять, какая именно пользовательская модель или чей конкретно под вызвал сбой, оказывается практически невозможно.
Эту слепую зону устраняет проект l9gpu — открытый легковесный агент телеметрии от команды Last9. Написанный на Go, он разворачивается в кластере как DaemonSet и напрямую сопоставляет низкоуровневые показатели чипов с иерархией контейнеров оркестратора, транслируя обогащенные метрики в открытом стандарте OpenTelemetry (OTLP).
Слепое пятно стандартного экспортера DCGM в мультиарендных кластерах
В большинстве компаний мониторинг графических ускорителей строится на базе официального NVIDIA DCGM Exporter (Data Center GPU Manager). Этот инструмент отлично фиксирует физические параметры «железа»: температуру ядра, энергопотребление в ваттах, процент утилизации вычислительных блоков SM (Streaming Multiprocessors) и объем занятой видеопамяти VRAM.
Проблема кроется в контексте оркестрации. DCGM Exporter «видит» физический хост и его PCI-устройства, но совершенно слеп к абстракциям Kubernetes или Slurm. В мультиарендной среде (multi-tenant), где на одной мощной ноде одновременно выполняются инференс-сервисы vLLM, пакетное дообучение модели и тестовые Jupyter-ноутбуки разных продуктовых команд, стандартный экспортер сообщает лишь общую температуру по палате. Когда на ноде случается аварийный сбой по нехватке памяти (CUDA Out of Memory), дежурный инженер видит график резкого падения, но не может ответить на фундаментальный вопрос: какой именно контейнер стал виновником инцидента.
Как DaemonSet сопоставляет cgroups, PID процессов и метаданные Kubelet
Архитектура l9gpu построена вокруг решения задачи атрибуции рабочей нагрузки (Workload Attribution). Вместо того чтобы полагаться на тяжелые внешние сборщики, агент садится на каждый узел кластера и выполняет низкоуровневую сшивку двух изолированных миров: аппаратных драйверов и контрольных групп Linux (cgroups).
Агент опрашивает библиотеки драйверов оборудования (NVML для NVIDIA, amdsmi для AMD ROCm и hl-smi для Intel Gaudi), извлекая идентификаторы системных процессов (PID), захвативших контекст GPU. Затем через локальный сокет Kubelet CRI API и структуры cgroup v1/v2 агент моментально сопоставляет эти PID с метаданными контейнеров. Установка выполняется в несколько команд через официальный Helm-чарт:
# Добавляем репозиторий агента телеметрии
helm repo add l9gpu https://last9.github.io/gpu-telemetry
helm repo update

# Разворачиваем DaemonSet с прямой отправкой в OpenTelemetry Collector
helm install l9gpu l9gpu/l9gpu -n monitoring \
  --set otlp.endpoint="otel-collector.monitoring.svc.cluster.local:4317" \
  --set otlp.insecure=true \
  --set polling.interval="2s"
Прозрачный биллинг, отлов зомби-подов и нативный экспорт OTLP
Полученные данные упаковываются не в устаревший формат Prometheus Pushgateway, а напрямую передаются по протоколу OTLP (gRPC или HTTP). Каждая метрика обогащается полным контекстом Kubernetes: именем пода, пространства имен (namespace), метками контейнера и аппаратным ID чипа.
# Пример структуры сгенерированного OTLP-пакета данных
metric_name: container_gpu_memory_used_bytes
unit: Bytes
attributes:
  k8s.pod.name: "vllm-llama3-70b-6d8b94df7-q5z82"
  k8s.namespace.name: "ml-production"
  k8s.container.name: "inference-engine"
  gpu.id: "GPU-1b849e72-23fa-8b29-e5a1"
  gpu.model: "NVIDIA H100 80GB HBM3"
  slurm.job.id: "null"
value: 73819750400
Благодаря такой гранулярности инженерные команды решают сразу три критические задачи. Во-первых, внедряется прозрачная экономика инфраструктуры (chargeback): финансовый отдел точно знает, сколько часов работы дорогостоящих GPU потребила каждая продуктовая команда. Во-вторых, мгновенно выявляются «зомби-поды» — сервисы, которые аллоцировали под себя всю память VRAM, но простаивают без реальных запросов (SM utilization равен нулю). Наконец, предупреждаются каскадные отказы: рост потребления VRAM виден заблаговременно, позволяя горизонтальному масштабированию отработать до падения инстанса.