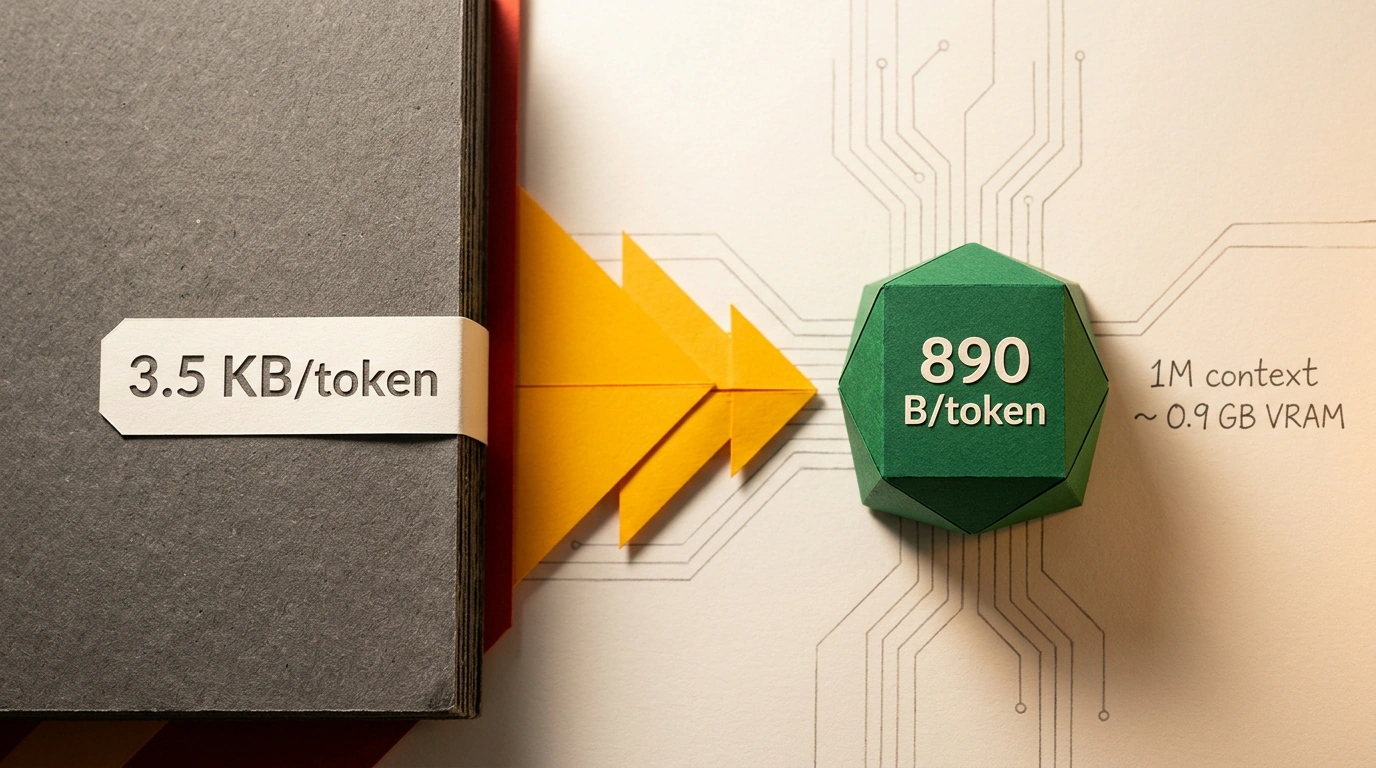

Когда весной и летом ведущие провайдеры нейросетей начали один за другим объявлять о драматическом снижении цен на обработку длинных промптов, в индустрии возникло легкое замешательство. Особенно отличились китайские разработчики из DeepSeek: стоимость входящих токенов при повторном обращении упала до символических трех-шести тысячных долей доллара за миллион ($0.003–0.006 за 1M токенов).
В околоайтишных кругах тут же родилась конспирологическая теория: мол, перед нами классический агрессивный демпинг за счет государственных субсидий, нацеленный на вытеснение западных облачных монополий. Однако любой системный инженер или специалист по Highload-архитектуре, взглянув на цифры, лишь улыбнется. Никакой магии или политических дотаций здесь нет: перед нами чистая, бескомпромиссная физика аппаратных вычислений на кремниевых чипах и триумф алгоритмической оптимизации Key-Value кеша.
Давай заглянем внутрь графического процессора и разберем по винтикам, почему размер контекста годами душил нейросетевые серверы и как сжатие кеша изменило экономику искусственного интеллекта.
Две фазы инференса и бутылочное горлышко памяти
Чтобы понять, где сгорают деньги при вызове больших языковых моделей, нужно разделить процесс генерации ответа трансформера на две принципиально разные фазы:
1. Фаза предварительного заполнения (Prefill Phase)
Пользователь отправляет запрос: например, системный промпт, документацию на 50 000 слов и вопрос. Модель считывает весь этот входной текст одновременно и параллельно. На этом этапе тензорные вычислительные ядра GPU загружены на 100%: они непрерывно перемножают матрицы эмбеддингов. Это состояние называется Compute-bound: скорость обработки упирается исключительно в вычислительную мощность чипа (TFLOPS).
2. Фаза декодирования (Decoding Phase)
А вот дальше начинается магия авторегрессии. Модель не может выдать весь ответ сразу — она генерирует текст строго по одному токену за шаг.
Чтобы вычислить вероятности для очередного слова, механизм внимания (Self-Attention) обязан сопоставить текущий вектор запроса (Query) с векторами ключей (Key) и значений (Value) абсолютно всех предшествующих токенов, которые уже находятся в контексте.
Если бы видеокарта пересчитывала векторы Key и Value для всего текста заново на каждом шаге генерации, время ответа на длинных диалогах измерялось бы минутами. Поэтому инженеры кешируют уже рассчитанные проекции в оперативной памяти видеокарты. Этот массив и называется KV-кешем (Key-Value Cache).
И вот здесь модель намертво упирается в физический барьер — Memory Bandwidth Bottleneck (узкое горлышко пропускной способности памяти).
Представь картину: вычислительным ядрам GPU нужно сделать совсем немного арифметических операций, чтобы сгенерировать всего одну букву или слово. Но чтобы выполнить эту операцию, видеокарта обязана прокачать через свою внутреннюю шину HBM (High Bandwidth Memory) весь гигантский массив накопленного KV-кеша! Вычислительные ядра простаивают, дожидаясь, пока контроллер памяти подтянет гигабайты байт из видеопамяти. Скорость генерации (число токенов в секунду) начинает зависеть не от терафлопсов, а исключительно от ширины шины памяти.
Прорыв DeepSeek Flash: сжатие до 890 байт
До недавнего времени размер KV-кеша рос угрожающими темпами. В классической архитектуре Multi-Head Attention (MHA) каждый токен требовал сохранения сотен параметров для каждой головы внимания на каждом слое нейросети.
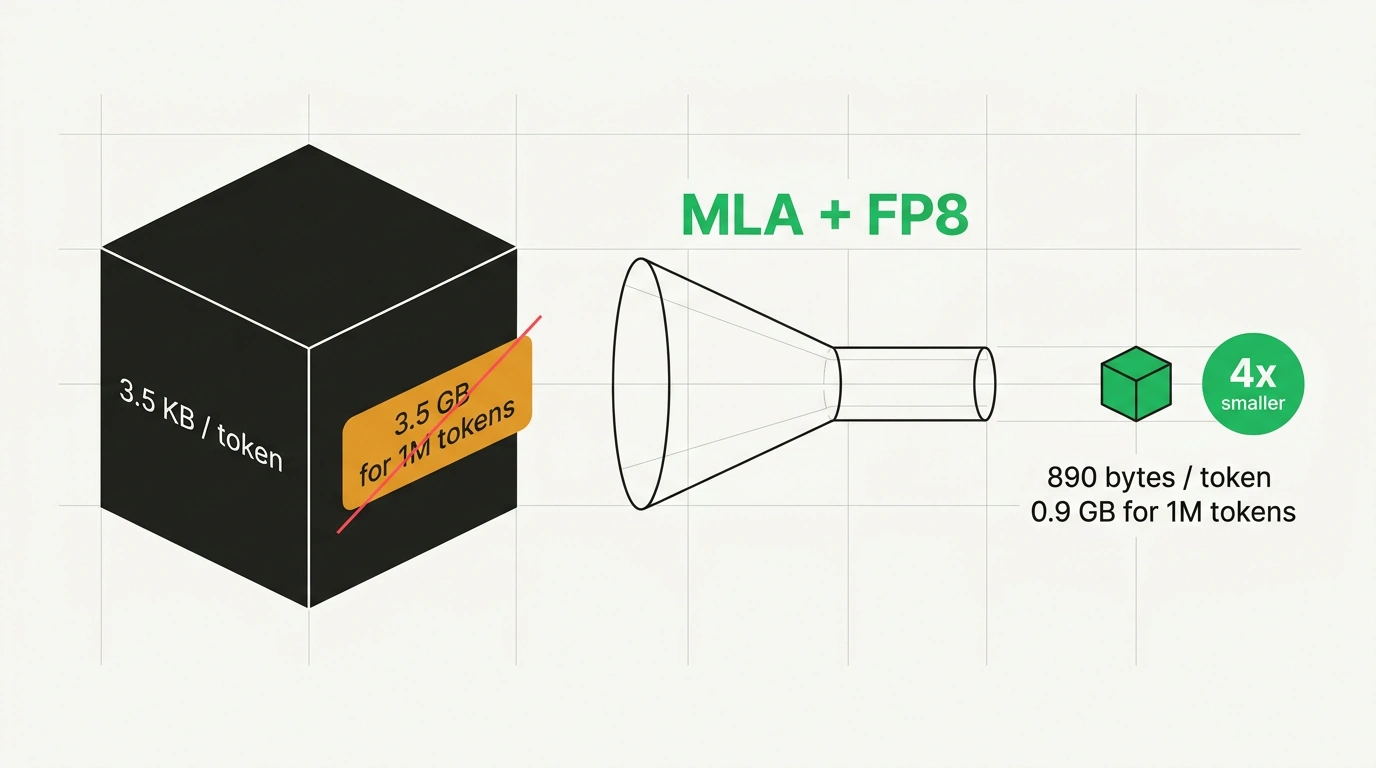
В ранних версиях моделей вроде DeepSeek-V1 один токен контекста «весил» в памяти ускорителя колоссальные объемы данных. В версии V4-Flash размер удалось утрамбовать до ~3.5 Килобайт на токен. Но даже при таком раскладе диалог длиной в один миллион токенов (1M context window) требовал 3.5 Гигабайта VRAM только под хранение кеша одной-единственной пользовательской сессии! А если у тебя на сервере одновременно висит сотня пользователей? Никаких флагманских Nvidia H100/H200 не хватит.
В релизе архитектуры DeepSeek Flash V4.1 инженеры применили метод скрытого латентного внимания — Multi-Head Latent Attention (MLA) в сочетании с агрессивной FP8-квантизацией. Вместо сохранения полных векторов ключей и значений алгоритм сжимает их в низкоранговое скрытое пространство (Low-rank Compression), проецируя обратно в полный размер непосредственно перед вычислением скалярного произведения.
Результат оказался ошеломляющим: размер KV-кеша удалось сжать до рекордных 890 байт на токен! Это в 4 раза меньше, чем в V4-Flash, и в сотни раз компактнее классических архитектур.
При таком сжатии полный контекст в 1 000 000 токенов занимает всего около 0.9 ГБ видеопамяти! Ранее мы подробно анализировали смежные оптимизации открытого стека инференса, когда разбирали модель DeepSeek V4.1 Flash и движок DeepInfer, а теперь этот архитектурный сдвиг стал стандартом промышленного обслуживания.
Экономика агентов: почему токен подешевел в 50 раз
Теперь сопоставим физику железа с бизнес-моделью облачных провайдеров.
В традиционном чат-боте пользователь задает вопрос и получает ответ. Но в современную эпоху автономных AI-агентов (вроде Claude Code, Devin или внутренних пайплайнов) паттерн нагрузки выглядит принципиально иначе:
- Агент получает огромный системный промпт с описанием десятков инструментов и документации проекта (50 000–100 000 токенов).
- Агент делает шаг: вызывает инструмент (например, читает файл).
- На следующем шаге агент отправляет в API всю историю заново: исходный системный промпт + первый шаг + вывод терминала + новый вопрос.
Если бы провайдер каждый раз заново прогонял фазу Prefill для этих неизменных 100 000 токенов, себестоимость работы агента исчислялась бы сотнями долларов в час.
Технология Prompt Caching позволяет сохранить рассчитанный KV-кеш неизменного префикса прямо в горячей памяти видеокарт кластера. Когда приходит следующий запрос с тем же самым началом промпта, видеокарта вообще не выполняет фазу Prefill! Она мгновенно переходит к генерации ответа, просто подтянув готовый компактный кеш.
А поскольку при размере 890 байт на токен один ускоритель Nvidia может удерживать в памяти кеши сразу сотен параллельных агентных сессий без вытеснения на диск, себестоимость обслуживания таких запросов падает практически до нуля. Провайдер продает попадание в кэш (cache-hit) за копейки не в убыток себе, а с отличной коммерческой маржой!
Ограничения и архитектурные правила игры
Чтобы эффективно использовать преимущества KV-кэширования в собственных приложениях, инженеру важно помнить о жестких правилах, по которым работают современные движки инференса (vLLM, TensorRT-LLM, SGLang):
- Непрерывность префикса: кэширование работает строго от начала промпта (Prefix Caching). Если ты вставишь динамическую переменную (например, текущую миллисекунду или случайный ID сессии) в первую строчку системного сообщения, ты мгновенно инвалидируешь весь последующий кэш диалога. Статические системные инструкции всегда должны идти первыми.
- Время жизни кэша (TTL): облачные провайдеры держат неактивные ветки кеша в быстрой видеопамяти обычно от 5 до 10 минут после последнего запроса. Если твой агент делает паузу больше этого интервала, кеш вытесняется более активными клиентами, и следующий запрос оплачивается по полному тарифу cache-miss.
Сжатие KV-кеша до суб-килобайтных размеров — это наглядная иллюстрация того, как глубокое понимание архитектуры кремния и алгоритмов линейной алгебры способно перевернуть экономику целой индустрии, сделав передовые технологии доступными каждому разработчику.