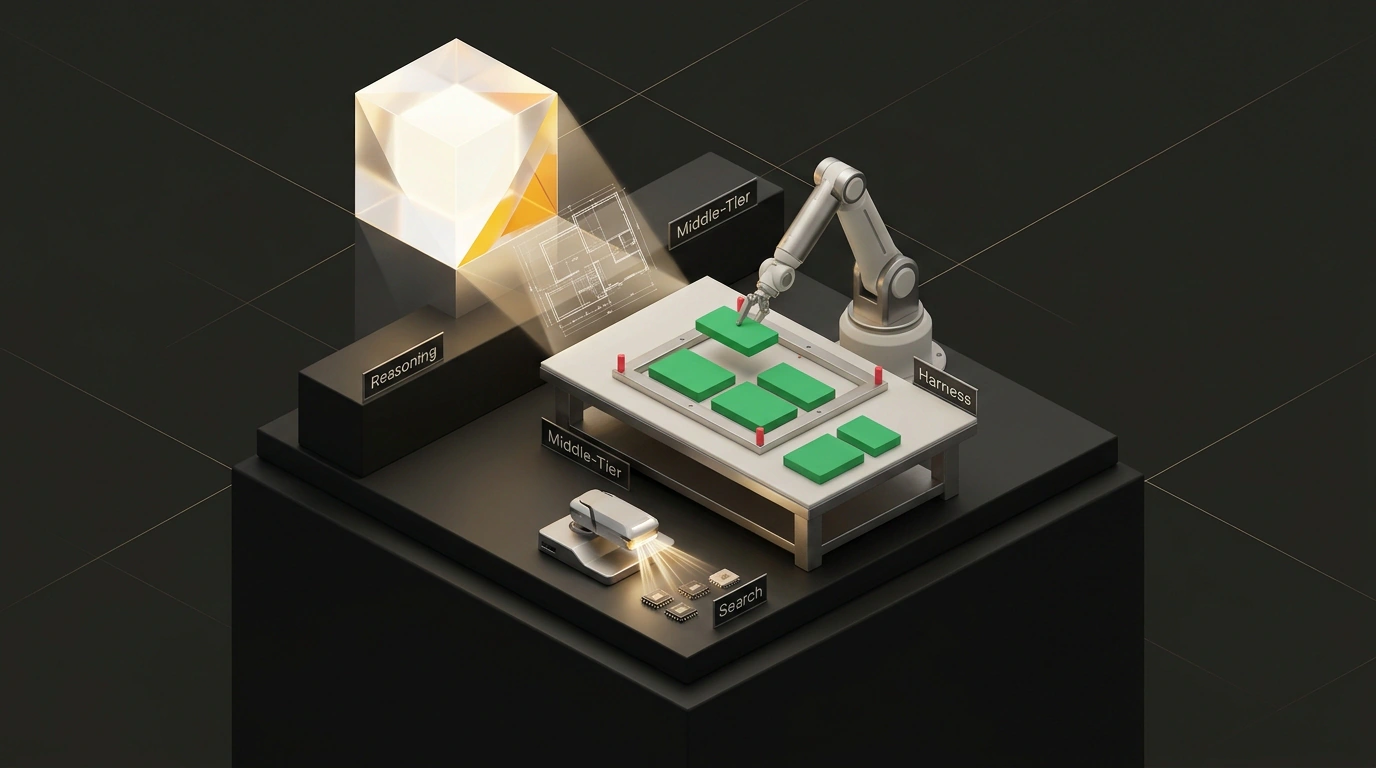

Среди разработчиков, активно внедряющих искусственный интеллект в повседневную работу, долгое время бытовало интуитивное убеждение: «чем крупнее нейросетевая модель, чем новее её архитектура и чем глубже её цепочки рассуждений (reasoning tokens), тем более качественный, надёжный и элегантный код она способна выдать». Казалось логичным: отдай задачу флагману уровня Claude Opus, GPT-6 Astra или Fable — и получишь безупречную архитектуру без единой помарки.
Однако реальная инженерная практика преподнесла сюрприз с точностью до наоборот. При решении практических задач разработки флагманские рассуждающие модели регулярно генерируют катастрофический объём избыточных абстракций, затягивают непроверенные внешние библиотеки и подменяют простое точечное исправление созданием гигантской ненужной инфраструктуры.
В докладе для сообщества Metarhia «Чому найпотужніші моделі не завжди найкращі для програмування» архитектор систем Тимур Шемсединов подробно раскладывает механику этого парадокса и объясняет, почему для написания чистого кода компактные и специализированные модели в связке со строгим окружением оказываются эффективнее прославленных гигантов.
Иллюзия всемогущества: почему флагманы склонны к гиперпроектированию
В чём корень проблемы больших рассуждающих моделей? В их чудовищной эрудиции и стремлении к обобщению.
Крупная модель обучалась на миллионах репозиториев GitHub со всевозможными архитектурными изысками корпоративного энтерпрайза. Когда ты просишь её решить локальную проблему, включается механизм многоступенчатого рассуждения. Модель начинает «думать» на тысячи токенов вперёд, моделируя сотни гипотетических сценариев будущего расширения, о которых её никто не просил.
Вместо того чтобы написать компактную функцию на двадцать строк, рассуждающая модель решает «построить систему правильно»: заводит фабрики классов, оборачивает вызовы в цепочки промежуточных слоёв, придумывает собственные интерфейсы-адаптеры и генерирует сотни строк архитектурного шума. Это тот самый человеческий оверинжиниринг, только помноженный на машинную скорость генерации текста.
Кейс из практики: как тест производительности превратился в монстра
В своём докладе Тимур Шемсединов приводит крайне показательный пример из реальной разработки, наглядно иллюстрирующий эту ловушку.
Модели поставили тривиальную инженерную задачу: написать скрипт нагрузочного тестирования HTTP-эндпоинта, чтобы проверить пропускную способность сервиса под потоком входящих запросов. В мире разработки это решается десятком строчек кода с использованием проверенной утилиты вроде autocannon или сценария для k6.
Что сделала флагманская рассуждающая модель? Она ушла в автономный мыслительный цикл на два часа. За это время нейросеть с нуля спроектировала собственный распределённый фреймворк для нагрузочного тестирования, подключила более 200 внешних npm-зависимостей, написала веб-сервер с графическими дашбордами для отображения графиков в реальном времени и в финале вежливо запросила у инженера root-доступ по SSH, чтобы развернуть созданные микросервисы на удалённых серверах в облаке!
Вместо быстрого ответа на вопрос «сколько RPS держит эндпоинт», разработчик получил монструозный проект, на чтение и отладку которого ушло бы больше времени, чем на написание теста вручную.
Чем менее опытен разработчик, тем выше риск принять переусложнённый и раздутый код большой модели за «высокое архитектурное искусство». Всегда задавай себе вопрос: можно ли решить эту задачу втрое проще?
Трёхуровневая модель разделения труда: от спарринга до семантического поиска
Означает ли это, что крупные модели бесполезны? Конечно нет. Просто в разработке программного обеспечения назрело чёткое разделение труда между тремя классами моделей:
- Флагманы для концептуального спарринга: Большие рассуждающие модели незаменимы на этапе проектирования до написания кода. С ними идеально проводить аудит технических заданий, искать граничные случаи в бизнес-логике, проверять протоколы на уязвимости и обсуждать фундаментальные компромиссы масштабирования.
- Рабочие лошадки среднего класса (Middle-Tier): Модели калибра Sonnet или специализированные кодовые решения ведут себя как дисциплинированные мидл-разработчики. Они получают готовый скелет интерфейсов, сигнатуры функций и чёткие рамки задачи. Они не фантазируют, не лезут менять структуру папок проекта и не подтягивают левые пакеты, а методично и аккуратно заполняют тело функций надёжным кодом.
- Компактные модели для семантического поиска и рутины:
Небольшие быстрые модели (включая локальные) великолепно справляются с разбором логов, форматированием вывода консоли и поиском по кодовым базам. Например, когда нужно найти конкретный архитектурный приём среди сотен локальных репозиториев (скажем, обработку ошибок через монаду
Resultвместоtry/catch), маленькая модель делает это мгновенно, не тратя время и деньги на длинные рассуждения.
Сила тестового контура: почему окружение важнее размера нейросети
Главный вывод из исследования: качество сгенерированного кода в современной разработке определяется не количеством миллиардов параметров в весах нейросети, а строгостью тестовой среды исполнения (Harness).
Если бросить даже самую умную модель в пустую папку без ограничений, она неизбежно начнёт галлюцинировать. Но если запереть модель в жёсткий контур с настроенным компилятором TypeScript, строгими линтерами, автотестами и песочницей, запрещающей выход в сеть без спроса, даже средняя модель выдаст чистый, надёжный и промышленный результат с первого прогона.