
В повседневной работе инженера данных, аналитика или бэкенд-разработчика постоянно возникает необходимость переключаться между разными инструментами анализа. Утром ты пишешь аналитический SQL-запрос к витрине данных в хранилище, днём проверяешь гипотезу в Jupyter Notebook с помощью библиотеки Pandas на Python, а к вечеру переносишь работающий прототип в распределённый пайплайн на Apache Spark.
Хотя все три системы в своей основе опираются на классическую реляционную алгебру, их синтаксис, модель исполнения и работа со структурами данных заметно различаются. В этой тематической подборке мы объединили два практических руководства от сообщества SQL Portal: сводную шпаргалку по 50 ключевым операциям трансформации данных и детальный разбор логического конвейера исполнения SQL-запросов движком СУБД.
Сравнение 50 операций
Когда разработчик мигрирует код между стеками, больше всего времени уходит не на логику, а на поиск синтаксических эквивалентов в документации. То, что в декларативном SQL формулируется одним ключевым словом, в императивном коде Pandas требует вызова цепочки методов датафрейма, а в распределённом PySpark требует учёта ленивых вычислений (Lazy Evaluation) и сериализации выражений.
Справочник систематизирует 50 регулярных операций манипуляции данными, раскладывая их по функциональным блокам:
- Проекция и фильтрация:
Обычная выборка с условием
SELECT col1, col2 WHERE col1 > 10в Pandas записывается через векторное маскированиеdf[df['col1'] > 10][['col1', 'col2']], а в PySpark требует явного вызоваdf.filter(F.col('col1') > 10).select('col1', 'col2'). - Семейство операций JOIN:
Все пять видов реляционных соединений (Inner, Left, Right, Full Outer и Cross Join). В Pandas для соединения двух датафреймов используется функция
pd.merge(df1, df2, on='key', how='left'), а в PySpark — распределённый метод датафреймаdf1.join(df2, on='key', how='left')либоdf1.crossJoin(df2). - Оконные функции и ранжирование:
Аналитические конструкции вроде
RANK() OVER (PARTITION BY dept ORDER BY salary DESC)в Pandas требуют группировки с вызовом метода ранга:df.groupby('dept')['salary'].rank(ascending=False). В PySpark для этого создаётся явный объект спецификации окна:
from pyspark.sql import functions as F
from pyspark.sql.window import Window

# Определение окна партиционирования по отделу с сортировкой по зарплате
dept_window = Window.partitionBy('department').orderBy(F.col('salary').desc())

# Добавление ранга сотрудника внутри отдела
df_ranked = df.withColumn('rank', F.rank().over(dept_window))
Такая матрица соответствия позволяет дата-инженеру мгновенно переводить SQL-модели в распределённые пайплайны Spark без потери бизнес-логики.
Анатомия SQL-запроса
Вторая половина мастерства работы с данными — понимание того, как твой SQL-запрос видит физический движок СУБД.
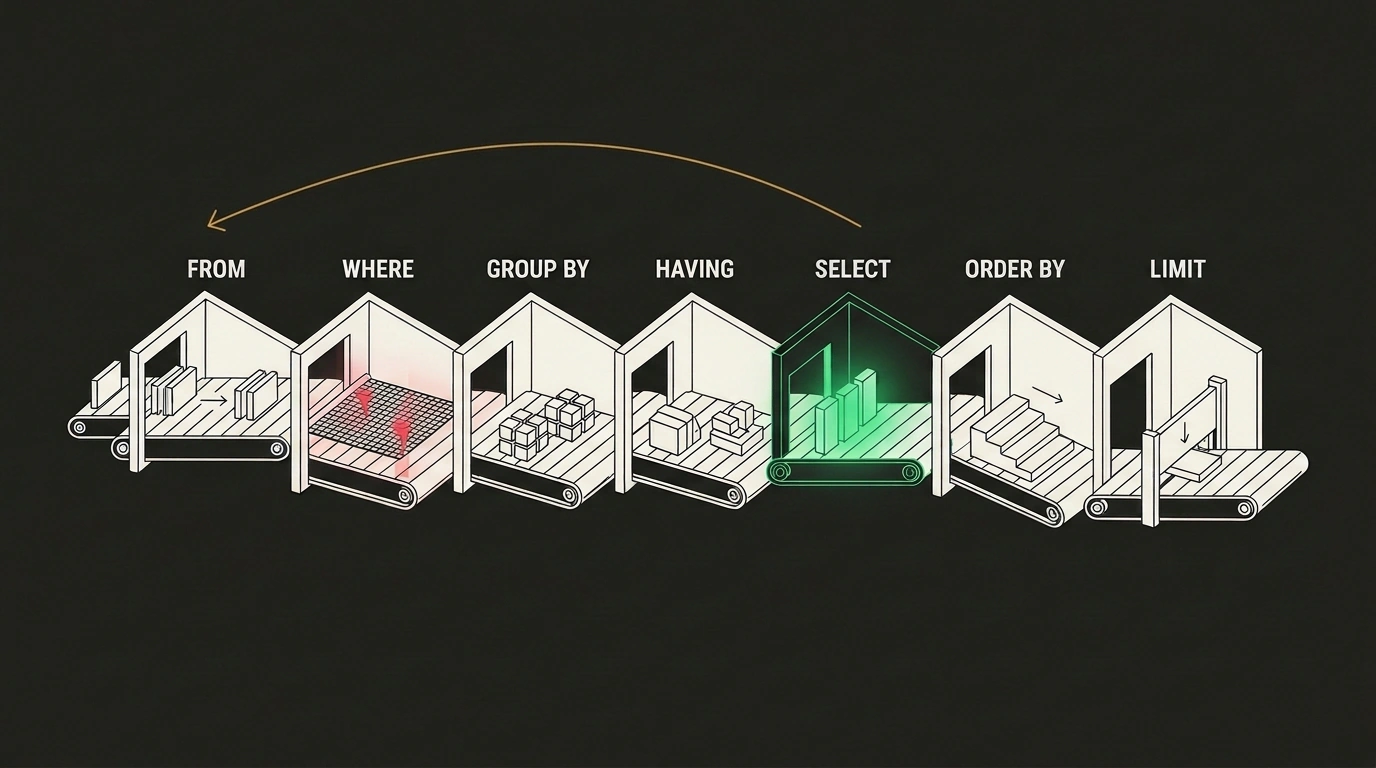
Главный парадокс SQL заключается в том, что синтаксический порядок написания запроса прямо противоположен логическому порядку его исполнения. Текст запроса всегда начинается со слова SELECT. Но если заглянуть в документацию исполнителя запросов PostgreSQL, выясняется, что блок SELECT выполняется предпоследним, прямо перед сортировкой!
Стандартизированный логический конвейер СУБД состоит из 7 строгих этапов:
FROMиJOIN: СУБД определяет базовый набор кортежей и производит соединение таблиц по условиюON.WHERE: Построчная фильтрация строк. На этом шаге СУБД ещё ничего не знает про агрегаты и псевдонимы изSELECT.GROUP BY: Сворачивание оставшихся строк в группы по ключам.HAVING: Фильтрация уже сформированных групп.SELECT: Вычисление проекций колонок, математических выражений, оконных функций и устранение дубликатовDISTINCT.ORDER BY: Сортировка готового результирующего набора.LIMIT/OFFSET: Ограничение объёма выдачи строк клиенту.
Этот порядок наглядно объясняет природу самых распространённых ошибок:
-- Демонстрация логического пайплайна:
-- ОШИБКА: обращение к псевдониму total_cost в блоке WHERE вызовет ошибку,
-- так как WHERE выполняется до того, как SELECT вычислит значение!
-- SELECT item_id, price * quantity AS total_cost FROM orders WHERE total_cost > 1000;

-- ПРАВИЛЬНЫЙ ЗАПРОС с соблюдением стадий:
SELECT
    category_id,
    COUNT(*) AS total_orders,
    AVG(price * quantity) AS avg_order_cost
FROM orders
JOIN categories ON orders.category_id = categories.id
WHERE orders.status = 'completed'
GROUP BY category_id
HAVING COUNT(*) >= 10
ORDER BY avg_order_cost DESC
LIMIT 5;
В блоке ORDER BY псевдоним avg_order_cost использовать уже можно, потому что стадия сортировки выполняется после стадии проекции SELECT.
Сочетание матрицы синтаксических соответствий и понимания логического порядка выполнения запросов даёт инженеру целостную оптику. Когда ты точно знаешь, на каком этапе конвейера отсекаются лишние кортежи (в WHERE до группировки, а не в HAVING после дорогостоящего GROUP BY), твои запросы выполняются за миллисекунды как в реляционной базе данных, так и в распределённом кластере PySpark.