

Когда разговор заходит о рекомендательных алгоритмах для сотен тысяч объектов, в воображении многих инженеров мгновенно возникает тяжелый ML-стек: кластеры с GPU, сервисы на Python, внешние векторные базы данных вроде Milvus или pgvector и гигантские языковые модели. Кажется, будто без нейросетей современный сервис обречен отдавать скучный топ просмотров. Но что, если я скажу тебе, что быстрый рекомендательный движок на 895 000 фильмов с подбором похожих за 1–3 миллисекунды можно поднять на самом скромном VPS за пару долларов — на чистом JavaScript и встроенной SQLite?
Именно так устроен независимый сервис KINO PARTY. Каталог проекта охватывает почти миллион картин, а на сервере крутится монолит на Node.js 24. Никаких микросервисов, никакого оверинжиниринга и никаких счетов за облака.
Давай разберём эту архитектуру: заглянем под капот нативного модуля node:sqlite, изучим математику нормализованных разреженных векторов, посмотрим, как инвертированный индекс обгоняет приближённый поиск по графам, и выясним, какие грабли подстерегают при очистке сотен тысяч строк сырых данных.
Слой 1: Инфраструктурный парадокс и локальный стек без внешних ML-баз
Главная инженерная иллюзия — вера в то, что любую задачу ранжирования нужно решать нейросетевыми эмбеддингами. Команды берут плотные векторы на 1536 измерений, отправляют их в специализированную векторную СУБД, а затем удивляются, почему база сжирает 16 ГБ оперативной памяти только на поддержание графа HNSW, а сетевые задержки съедают десятки миллисекунд.
В KINO PARTY база данных и аналитический движок работают в одном адресном пространстве. Хранилищем выступает встроенная SQLite, к которой сервер обращается через нативный модуль node:sqlite, стабилизированный в Node.js 24. Раньше стандартом были бинарные обёртки вроде better-sqlite3. Они работали быстро, но требовали компиляции C++ аддонов через node-gyp, что усложняло сборку Docker-образов. Появление класса DatabaseSync прямо в стандартной библиотеке закрыло этот вопрос.
Чтобы база летала и не упиралась в диск, при старте приложения выставляются правильные прагмы:
import { DatabaseSync } from 'node:sqlite';

const db = new DatabaseSync('./data/kinoparty.db');

// Перевод журнала в WAL и выделение памяти под кэш страниц
db.exec(`
  PRAGMA journal_mode = WAL;
  PRAGMA synchronous = NORMAL;
  PRAGMA cache_size = -64000; -- 64 МБ оперативной памяти под кэш
  PRAGMA temp_store = MEMORY;
  PRAGMA mmap_size = 2147483648; -- 2 ГБ файла базы отображаются в память
`);
Режим WAL позволяет читающим потокам не блокировать пишущие транзакции: пока фоновый процесс обогащает карточки рейтингами OMDb, клиентские HTTP-запросы мгновенно забирают данные. Весь файл базы с индексами и виртуальными таблицами FTS5 занимает на диске ровно 9 ГБ. Полнотекстовый поиск FTS5 закрывает запросы по названиям и актёрам, а рекомендательное ядро recommender.js занимает всего около 650 строк чистого JavaScript.
Слой 2: Очистка грязных данных и битва с коллизиями идентификаторов
В теории алгоритмы выглядят безупречно, пока не сталкиваются с реальными данными. Каталог формировался слиянием выгрузок TMDB, OMDb и исторических баз Кинопоиска, где разработчика ждал ряд неожиданностей.
Первая проблема — конфликт первичных ключей. Идентификаторы фильмов в старых дампах Кинопоиска и API TMDB пересекались. Например, ID 603 в TMDB закреплен за «Матрицей», а в Кинопоиске принадлежал польской драме «Салон Вероники». Наивное объединение по полю id приводило к диким рекомендациям. Проблему решили разделением внешних ключей (tmdbId, kinopoiskId, imdbId) и валидацией даты премьеры с допуском не более одного года.
Вторая проблема — фиктивные локализации. Из 762 000 фильмов с заполненным описанием у 669 416 записей в русской колонке отсутствовали буквы кириллицы: TMDB при отсутствии дубляжа молча копировал английский текст. Переводить 670 000 синопсисов через API слишком дорого. Автор выделил «золотое ядро» из 26 880 популярных фильмов и перевел только их, а для остальных тайтлов признаки строятся по оригинальным маркерам.
Кроме того, машинный перевод занес в базу символы нулевой ширины U+200B и неразрывные пробелы, ломавшие расчет контрольных сумм и токенизацию FTS5. Пришлось добавить обязательный этап санитайзинга текста перед записью в SQLite.
Слой 3: Линейная алгебра в памяти: инвертированный индекс и расчёт схожести
Как находить 50 похожих фильмов среди миллиона за пару миллисекунд? Наивный перебор всей базы через эвристики кладет процессор уже при пяти пользователях.
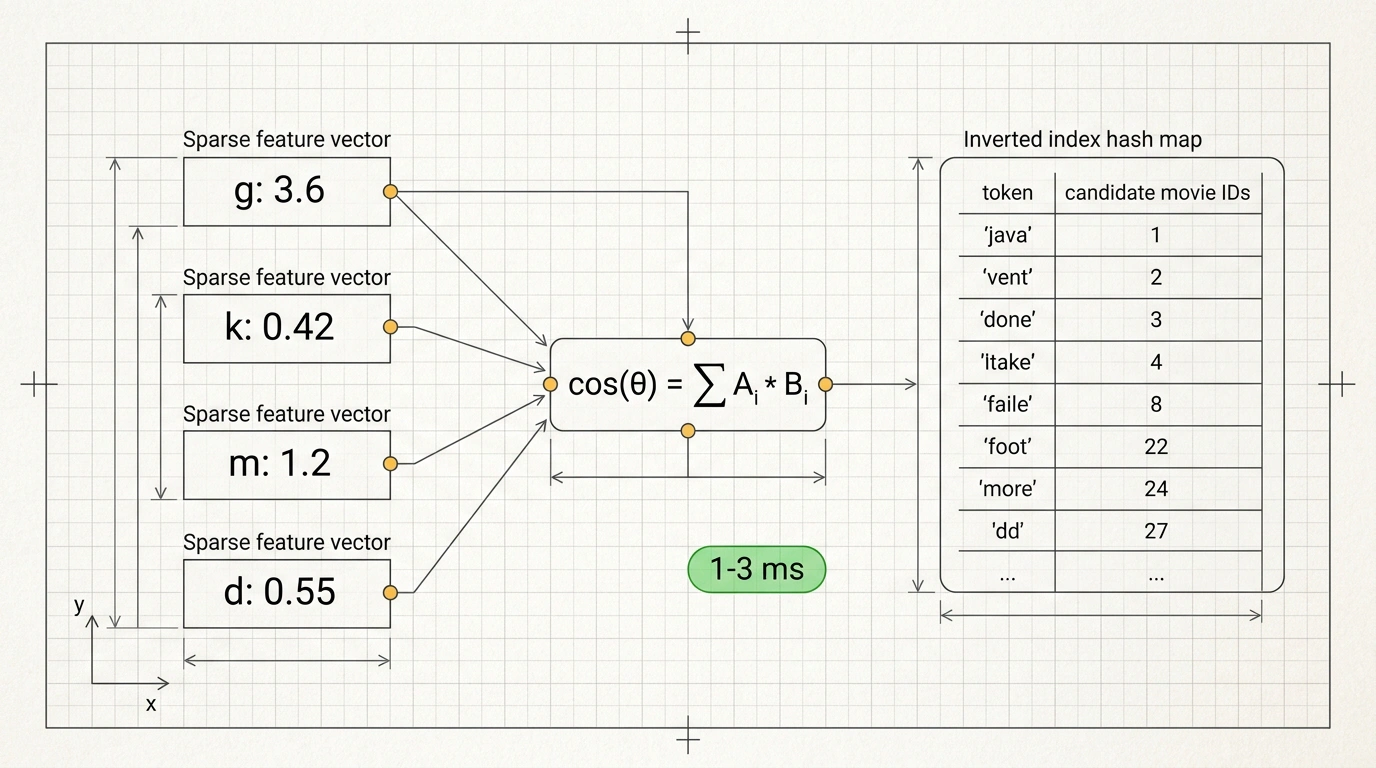
Решение опирается на векторную модель признаков. Каждый фильм представлен как разреженный вектор, где ненулевыми являются пара десятков атрибутов:
- Жанры (
g:): максимальный вес 3.6 из-за минимальной энтропии; - Ключевые слова (
k:): весTF-IDF × 0.42с отсевом стоп-слов; - Эмоциональный тон (
m:): вес от 0.7 до 1.2; - Сюжетный двигатель (
n:): вес около 0.9; - Десятилетие премьеры (
d:): вес 0.55; - Страна производства (
c:): вес 0.5.
Векторы признаков проходят L2-нормализацию прямо при сохранении: ||v|| = 1. Благодаря этому косинусное сходство между двумя фильмами сводится к простому скалярному произведению:
Вот как устроен инвертированный индекс и расчет схожести в коде:
export class FastRecommender {
  constructor() {
    this.invertedIndex = new Map(); // token -> Array<[movieId, weight]>
    this.profiles = new Map();      // movieId -> Array<[token, weight]>
  }

  addMovie(id, rawFeatures) {
    let sumSquares = 0;
    for (const w of Object.values(rawFeatures)) sumSquares += w * w;
    const norm = Math.sqrt(sumSquares) || 1;

    const profile = [];
    for (const [token, weight] of Object.entries(rawFeatures)) {
      const normalized = weight / norm;
      profile.push([token, normalized]);
      if (!this.invertedIndex.has(token)) this.invertedIndex.set(token, []);
      this.invertedIndex.get(token).push([id, normalized]);
    }
    this.profiles.set(id, profile);
  }

  findSimilar(targetId, limit = 20) {
    const targetProfile = this.profiles.get(targetId);
    if (!targetProfile) return [];
    const scores = new Map();

    for (const [token, targetWeight] of targetProfile) {
      const postings = this.invertedIndex.get(token);
      if (!postings) continue;
      for (let i = 0; i < postings.length; i++) {
        const [candId, candWeight] = postings[i];
        if (candId === targetId) continue;
        scores.set(candId, (scores.get(candId) || 0) + targetWeight * candWeight);
      }
    }

    return Array.from(scores.entries())
      .sort((a, b) => b[1] - a[1])
      .slice(0, limit)
      .map(([id, score]) => ({ id, score: Number(score.toFixed(4)) }));
  }
}
Инвертированный индекс мгновенно сужает пространство поиска: алгоритм опрашивает только те тайтлы, у которых есть общие токены.
При первой попытке загрузить в память 50 000 фильмов процесс Node.js ушел в тяжелые GC-паузы, вызывая ошибки 504. Индекс в памяти ограничили 15 000 ключевых фильмов, а для остальных 880 000 профиль извлекается из SQLite на лету за доли миллисекунды.
Этот принцип перекликается с тем, как проектируют инструменты автоматизации рабочего окружения для Claude, где изоляция контекста защищает память от перегрузки.
Слой 4: Групповой выбор в реальном времени и выживание в продакшене
Подобрать кино для компании сложнее, чем для одного человека. KINO PARTY работает как кино-свайпер для совместного выбора.
Если применить простое усреднение, компания получит компромиссный вариант, не устраивающий никого. Поэтому в сервисе задействована психологическая модель Valence-Arousal с асимметричным коэффициентом:
Валентность группы = Среднее(Valence) + (Мин(Valence) - Среднее(Valence)) × 1.6
Мнение самого уставшего или недовольного участника получает штрафной вес ×1.6, а стоп-листы объединяются через «ИЛИ»: свайп влево любого участника исключает жанр из общей подборки.
Вместо тяжелых WebSocket-соединений реальное время реализовано через Server-Sent Events (SSE). Сервер рассылает состояние комнаты, а клиенты голосуют обычными POST-запросами. Это дает нативное переподключение на смартфонах без оверхеда на поддержку вебсокет-сессий.
Наконец, защита от поисковых санкций за тонкий контент (SEO Thin Content). Из 900 000 страниц 868 000 содержат мало текста для автономного ранжирования. Для них отдается заголовок X-Robots-Tag: noindex, follow, сохраняя ссылки, но не забивая индекс поисковиков. В публичный sitemap включены строго 27 000 страниц ядра с описанием от 100 символов, постером и оценками.
Опыт KINO PARTY доказывает: чистое инженерное мышление, алгоритмическая дисциплина и стандартная библиотека позволяют строить быстрые сервисы без раздувания бюджетов.