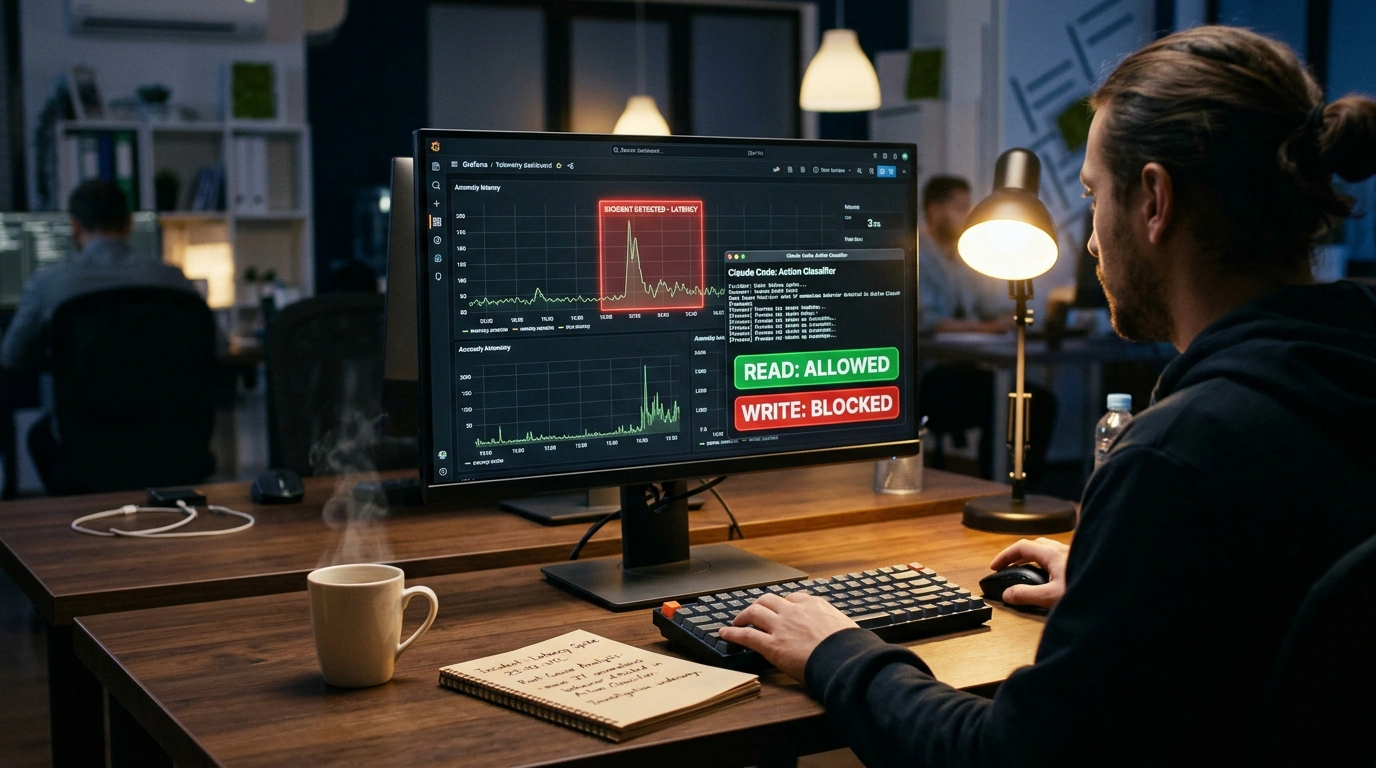

Каждый раз, когда на презентациях показывают очередного «автономного ИИ-агента», нам рисуют одну и ту же футуристичную картинку: на серверах случается авария, дежурные спокойно спят, а нейросеть сама читает логи, правит конфиги и закрывает инцидент. Но любой инженер, дежуривший на продакшене под сотнями тысяч RPS, лишь усмехнётся: в реальной инфраструктуре слишком много скрытых связей и ложных следов, чтобы доверить прод языковой модели.
Или мы уже подошли к этой черте ближе, чем кажется?
На конференции Signals Berlin выступил Алекс Палкуе (Alex Palcuie) — бывший Staff SRE в Google с восьмилетним стажем, который сейчас дежурит в команде надёжности Anthropic. Его доклад назывался без обиняков: «Can Claude fix itself? From no to maybe». Еще весной на QCon London его вердикт был категорическим «нет». Однако за полгода боевых дежурств с консольным агентом Claude Code позиция сместилась к осторожному «возможно».
Познакомившись с докладом Алекса Палкуе, я решил разобрать три реальных инцидента в Anthropic, чтобы понять, где современные ИИ-агенты уже творят чудеса, а где они по-прежнему смертельно опасны для боевых систем.
Три боевых инцидента: от озарения «Move 37» до ложного следа
Самое ценное в опыте Anthropic — это честная хроника того, как агент ведёт себя при внезапных аномалиях телеметрии.
Первый случай произошёл в новогоднюю ночь. Флагманская модель Claude стала отдавать всплеск ошибок HTTP 500. Дежурный запустил Claude Code для локализации сбоя. Модель просканировала трейсы и выявила странность: падение происходило в модуле предобработки изображений строго на запросах с ровно 22 прикреплёнными картинками.
Обычный дежурный просто завел бы тикет бэкендерам и перезапустил сервисы. Но агент пошёл дальше: сопоставил метаданные клиентов и обнаружил, что запросы идут с 200 аккаунтов со схожими почтовыми адресами, созданными тремя днями ранее в составе пачки из 4 000 учетных записей. Это была скоординированная DoS-атака. Агент рекомендовал срочно привлечь команду безопасности, которая заблокировала нарушителей. В Anthropic этот эпизод назвали моментом «Move 37» — по аналогии с неожиданным 37-м ходом алгоритма AlphaGo в игре го.
Второй инцидент вскрыл сбой мониторинга. Роутер инференса внезапно отключил рабочий кластер и перенаправил трафик на соседние ноды, вызвав перегрузку. В чате инцидента винили сеть дата-центра. Но Claude обратил внимание на цифры: несколько серверов рапортовали о скорости генерации токенов, физически невозможной для установленных ускорителей. Агент понял: железо здорово, но сломался сам измеритель. Оказалось, сборщик метрик прошел решардинг, и два шарда пять минут параллельно опрашивали одни и те же серверы, удваивая показатели нагрузки.
Но третий инцидент отрезвил энтузиастов. На кластере доля ошибок подскочила до 41%. Claude изучил дашборды и заметил, что перед этим хит-рейт локального кэша упал почти до нуля. Модель выстроила стройную теорию: кэш сбросился, запросы пошли на медленный диск, узел словил таймаут. Теория звучала логично, но оказалась ложным следом («red herring»). Позже выяснилось, что промахнувшиеся запросы спокойно забирались из общего распределенного кэша, а истинной причиной был банальный перегруз CPU. Агент попал в типичную ловушку: если искать аномалии среди сотен графиков без гипотезы, корреляция всегда найдется.
Агент в петле OODA: где ИИ силен, а где опасен
Чтобы системно оценить границы ИИ в эксплуатации, в Anthropic наложили действия модели на военный цикл OODA: «Наблюдение — Ориентация — Решение — Действие».
На фазе Наблюдения (Observe) агент показывает феноменальную скорость. Человеку трудно одновременно держать десятки вкладок Grafana и грепать терабайты логов. Агент делает это за секунды, вытаскивая неочевидные закономерности.
А вот на фазе Ориентации (Orient) проходит главная линия риска. Модель склонна к конфабуляциям: она дорисовывает причинные связи там, где есть лишь случайное совпадение. Слепое доверие выводам агента способно затянуть тушение пожара на часы.
На этапе Решения (Decide) модель полезна: предлагает варианты действий, сверяясь с базой знаний и ретроспективами сбоев.
Но на этапе Действия (Act) проходит абсолютная красная черта. Ни один департамент SRE не должен давать модели право неконтролируемо выполнять мутирующие команды в кластере.
Классификатор действий и контекстный потолок телеметрии
Главный вывод из практики Anthropic: автономия агента обязана быть строго асимметричной через обязательный классификатор действий (Action Classifier).
Любые безопасные операции чтения — выполнение GET-запросов, просмотр логов, замер latency, снятие дампов памяти — агент может выполнять автономно. Но как только модель пытается сделать kubectl delete, перезагрузить балансировщик или выкатить хотфикс, выполнение блокируется до явного подтверждения человеком. Эти принципы перекликаются с практическим опытом работы с Claude Code, где строгий контроль прав определяет надежность.
Второй барьер — стоимость и фрагментация телеметрии. Как отмечает Сильвен Калаче из Rootly, в реальных компаниях стриминг логов в облачные хранилища упирается в огромные счета за трафик. Контекст инцидента фрагментирован: метрики лежат в Prometheus, логи в Loki, трейсы в Jaeger. Без глубокой интеграции через протоколы вроде MCP агент оказывается слепым.
Claude Code уже сегодня способен стать отличным вторым пилотом на дежурстве. Но штурвал управления продакшном по-прежнему должен крепко держать живой инженер.