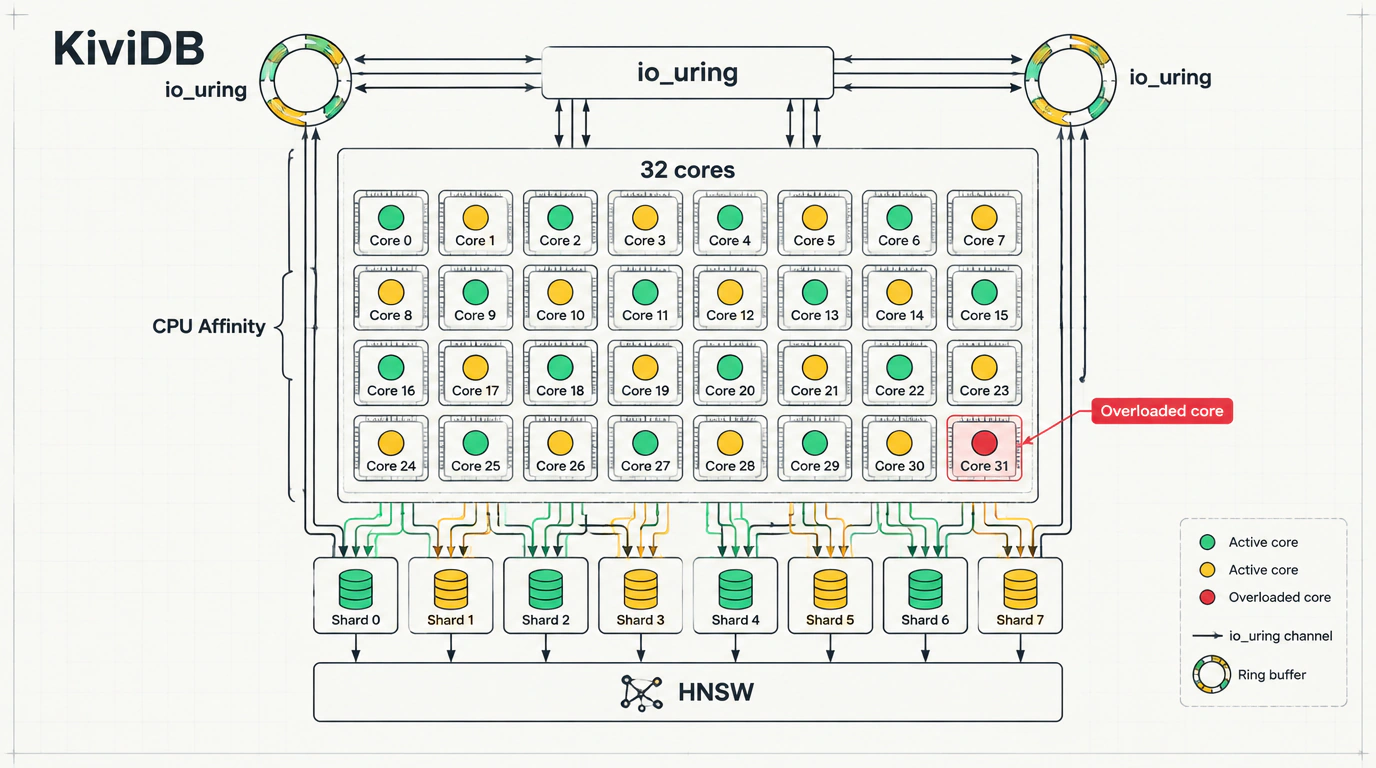

Представь классическую картину: вечер, на сервисе начинается пик трафика, время отклика API внезапно ползет вверх, а графики задержек p99 окрашиваются в тревожный красный цвет. Ты заходишь на сервер по SSH, открываешь утилиту htop и видишь до боли знакомый парадокс: одно процессорное ядро намертво забито в 100%, в то время как остальные тридцать одно ядро мощного 32-ядерного процессора безмятежно простаивают.
Виновник этой драмы хорошо известен любому бэкендеру: легендарный Redis. Сальваторе Санфилиппо в далеком 2009 году заложил в Redis однопоточный цикл обработки событий (event loop). Никаких мьютексов, предельно простой Си-код и строгая атомарность. Но серверное железо давно масштабируется числом ядер, а наш швейцарский нож так и остался заперт в границах одного ядра.
Эту архитектурную боль берется решить KiviDB — новое открытое in-memory хранилище со встроенным поиском, написанное на Rust. Давай разберем, как устроена эта база под капотом и где скрываются компромиссы.
Потолок одного ядра: цена кластеризации
Когда одно ядро Redis упирается в 100%, у тебя остается два пути: мириться с очередями или запускать Redis Cluster. Но кластеризация на одном физическом сервере — это ощутимый инженерный налог:
- Приходится настраивать сетевую маршрутизацию между десятками процессов и поддерживать порты от 6379 до 6410;
- Любая составная операция вроде
MGETили транзакции требует, чтобы ключи лежали в одном хэш-слоте, вынуждая прописывать хэш-теги видаuser:{1001}:profile; - Клиентские библиотеки в коде вынуждены отслеживать топологию узлов и перехватывать редиректы
MOVED.
Аналогия простая: представь супермаркет с 32 кассами, где работает только один кассир. Кластеризация Redis — это попытка построить рядом еще тридцать ларьков со своими заборами вместо того, чтобы посадить кассиров за соседние кассы.
Форки вроде Valkey сохранили верность классической архитектуре ради совместимости, а Dragonfly выбрал C++. KiviDB решает проблему с помощью модели памяти на Rust.
Шардинг по ядрам и магия io_uring
В основе KiviDB лежит шардированная по ядрам архитектура (sharded-by-core in-memory design). Пространство ключей делится на независимые партиции, а каждый рабочий поток жестко привязывается к выделенному ядру CPU (CPU affinity).
Когда в базу поступает пакет команд, KiviDB направляет ключ строго в тот поток, которому принадлежит этот сектор памяти. Каждый поток безраздельно владеет своей партицией, поэтому внутри KiviDB нет глобальных блокировок или мьютексов.
Сетевой ввод-вывод в Linux построен на асинхронном системном интерфейсе io_uring через крейт tokio_uring. Вместо переключений контекста между пространством пользователя и ядром ОС, KiviDB обменивается с ядром кольцевыми буферами. Если io_uring заблокирован политиками безопасности, рантайм автоматически переключается на Tokio.
KiviDB прозрачно реализует бинарные протоколы RESP2 и RESP3. Стандартные библиотеки (redis-py, go-redis, очереди BullMQ или Celery) подключаются к серверу без изменения кода. По умолчанию KiviDB слушает порт 6380, что позволяет развернуть его рядом с боевым Redis для тестов.
Встроенный векторный поиск HNSW
С развитием RAG разработчикам часто требуется искать семантически близкие векторы документов. Обычно для этого поднимают отдельную СУБД (Qdrant, Milvus) либо тяжелые расширения.
В KiviDB встроен векторный и полнотекстовый движок, совместимый с синтаксисом Redis Stack (FT.*). Поддерживаются индексы FLAT (точный перебор) и HNSW (граф для приближенного поиска ближайших соседей). Векторы хранятся в формате FLOAT32 внутри стандартных хэшей (HASH).
Главная инженерная находка: в отличие от систем, где при рестарте векторный граф часами строится заново, KiviDB при вызове SAVE сериализует в дамп dump.kdb сам рассчитанный граф HNSW. При перезапуске готовый граф считывается за секунды. Также поддерживается упреждающий журнал дозаписи (--aof).
Проверка боем: подключение и бенчмарки
Запустим тестовый инстанс через Docker и проверим подключение:
# Запуск контейнера KiviDB на порту 6380
docker run -d --name kividb-test -p 6380:6380 kividb/kividb:latest

# Проверяем соединение и пишем данные по протоколу RESP
redis-cli -p 6380 SET user:1001:session '{"role":"developer"}' EX 3600
redis-cli -p 6380 GET user:1001:session
Теперь создадим векторный индекс HNSW и выполним поиск пяти ближайших соседей (KNN 5):
# Создание индекса HNSW для четырехмерных векторов
redis-cli -p 6380 FT.CREATE idx:articles ON HASH PREFIX 1 article: SCHEMA \
  title TEXT embedding VECTOR HNSW 10 TYPE FLOAT32 DIM 4 DISTANCE_METRIC COSINE M 16 EF_CONSTRUCTION 128

# Запись статьи и векторный поиск
redis-cli -p 6380 HSET article:42 title "Шардинг" embedding "\xcd\xcc\xcc=\xcd\xccL>\x9a\x99\x99>\xcd\xcc\xcc>"
redis-cli -p 6380 FT.SEARCH idx:articles "*=>[KNN 5 @embedding $vec]" PARAMS 2 vec "\xcd\xcc\xcc=\xcd\xccL>\x9a\x99\x99>\xcd\xcc\xcc>" DIALECT 2
На 32-ядерном сервере AWS Graviton3 c7gn.metal при конвейеризации KiviDB показал 21,2 млн GET/s и 19,2 млн SET/s, опередив Dragonfly 2.0.2 (9,1 млн GET/s) в 2,3 раза, а Redis 8.10 (2,4 млн GET/s) почти в 9 раз. Задержка p99 под нагрузкой 1600 клиентов составила 13,9 мс против 33,9 мс у Dragonfly и 72,1 мс у Redis.
Ранее мы разбирали смежную задачу управления памятью в материале Отказоустойчивый запуск ArgoCD в режиме Stateless на bare-metal Kubernetes, где надежность кэша напрямую влияла на стабильность контроллера.
Подводные камни и границы применимости
Прежде чем внедрять KiviDB, важно учесть скрытые нюансы:
- Лицензия AGPL-3.0: Сетевые клиенты не подпадают под требования копилефта, но службы безопасности многих корпораций запрещают AGPL в инфраструктуре.
- Профиль seccomp: Для полной скорости
io_uringконтейнеру нужен флаг--security-opt seccomp=unconfined, что в закрытых кластерах требует согласования. - Кросс-шардовые операции: Команды над ключами из разных партиций требуют межпоточной синхронизации, снижая преимущество шардинга.
- Зрелость: Проект находится на версии 1.1 (около 800 звезд на GitHub), поэтому боевой опыт еще нарабатывается.
Запусти KiviDB на резервном порту 6380 и настройте зеркалирование части трафика чтения с продакшена через прокси. Это покажет реальное поведение ваших нагрузок без риска для пользователей.