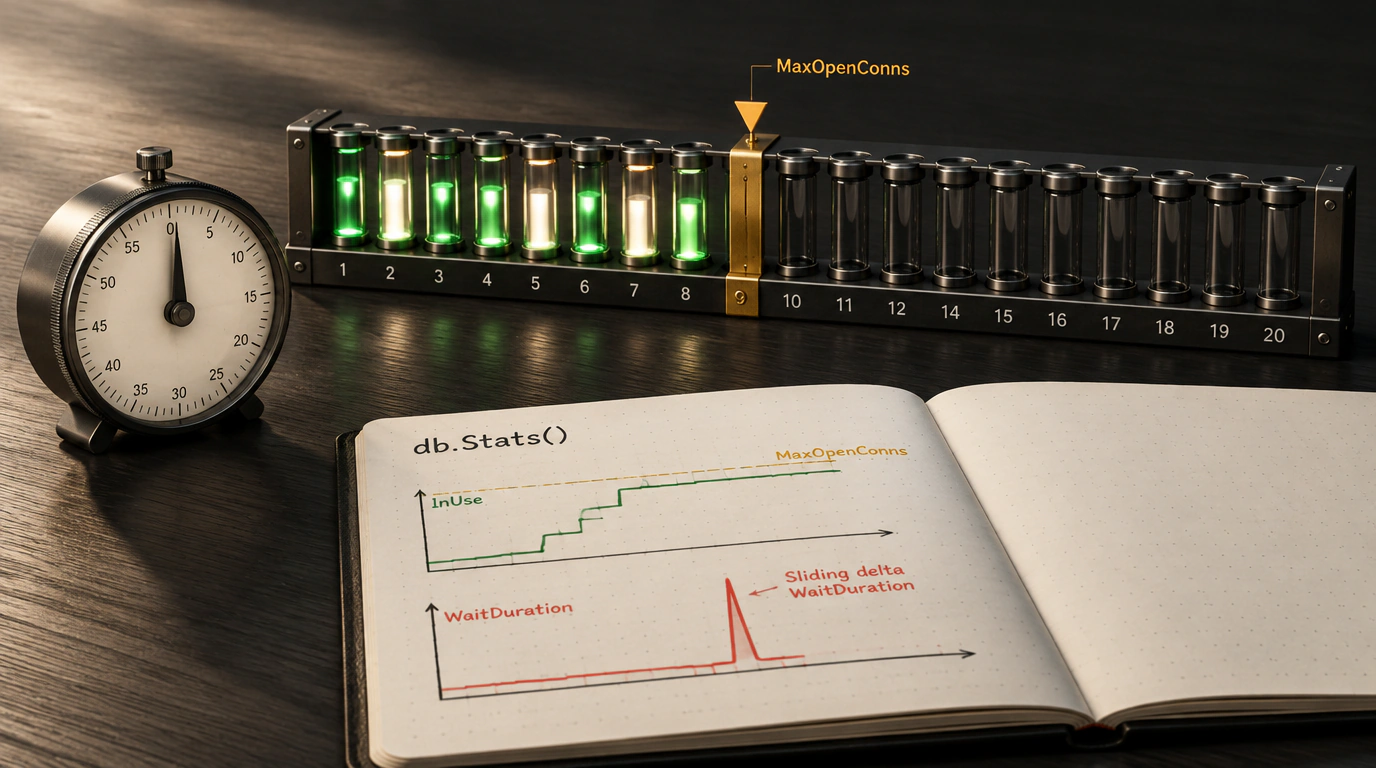

Типичная детективная история в бэкенд-разработке: дежурный инженер видит в Grafana резкий всплеск времени отклика HTTP-ручек сервиса на Go. Ответы отдаются за секунду вместо привычных двадцати миллисекунд. Инженер бросается в логи базы данных, включает журнал медленных запросов и с удивлением обнаруживает: в PostgreSQL или MySQL все чисто. Каждый SQL-запрос отрабатывает за стремительные две миллисекунды.
Где же тогда теряются сотни миллисекунд? Ответ кроется в невидимой для СУБД очереди — внутри стандартного пакета database/sql. Задержка возникает еще до того, как первый байт запроса уходит в сеть: горутины блокируются на внутреннем семафоре приложения в ожидании освобождения TCP-сокета из пула. Мы сталкивались с похожим эффектом в материале PostgreSQL тормозит, а процессор свободен: ищем тяжелые запросы через pg_stat_statements, когда истинная причина задержек маскировалась за благополучными метриками процессора.
Как устроен пул и почему возникает голодание
Объект *sql.DB в Go — это не одно физическое сетевое подключение, а умный потокобезопасный пул коннектов. Когда твой код вызывает db.Query() или db.Exec(), рантайм берет свободный сокет из пула либо открывает новый, если текущее количество меньше лимита SetMaxOpenConns.
Но если лимит исчерпан, а все соединения заняты выполняющимися операциями, горутина засыпает на мьютексе. Если кто-то забыл вызвать rows.Close() или транзакция зависла в ожидании внешнего HTTP-ответа, сокет не возвращается в пул. Новые запросы встают в очередь, формируя эффект лавинообразного голодания (pool starvation).
Правильная настройка пула требует баланса четырех параметров:
package main

import (
    "database/sql"
    "time"

    _ "github.com/jackc/pgx/v5/stdlib"
)

// InitPool настраивает предсказуемые границы пула соединений
func InitPool(db *sql.DB) {
    // Жесткий потолок физических сокетов (InUse + Idle)
    db.SetMaxOpenConns(40)

    // Количество горячих простаивающих коннектов
    db.SetMaxIdleConns(20)

    // Ротация сокетов для защиты от утечек памяти и смены DNS
    db.SetConnMaxLifetime(30 * time.Minute)

    // Закрытие лишних простаивающих сокетов при спаде нагрузки
    db.SetConnMaxIdleTime(5 * time.Minute)
}
Интроспекция через db.Stats() и расчет дельты
Чтобы обнаружить проблему в продакшене, стандартная библиотека предоставляет метод db.Stats(). Он возвращает структуру sql.DBStats со счетчиками состояния пула:
InUse: сколько сокетов заняты выполнением запросов прямо сейчас;Idle: сколько готовых соединений ждут работы;WaitCount: сколько раз горутинам пришлось заблокироваться из-за нехватки слота;WaitDuration: суммарное время ожидания соединений с момента старта процесса.
Главная ловушка новичков — смотреть на мгновенные значения WaitCount. Поскольку этот счетчик монотонно растет с момента запуска пода, само по себе большое число ни о чем не говорит. Для диагностики критически важен замер скользящей дельты:
package main

import (
    "database/sql"
    "log"
    "time"
)

// MonitorPoolDeltas периодически замеряет скорость накопления очереди в пуле
func MonitorPoolDeltas(db *sql.DB, interval time.Duration) {
    ticker := time.NewTicker(interval)
    var lastWaitCount int64
    var lastWaitDuration time.Duration

    for range ticker.C {
        stats := db.Stats()

        deltaWaitCount := stats.WaitCount - lastWaitCount
        deltaWaitDuration := stats.WaitDuration - lastWaitDuration

        lastWaitCount = stats.WaitCount
        lastWaitDuration = stats.WaitDuration

        if deltaWaitCount > 0 {
            avgWait := deltaWaitDuration / time.Duration(deltaWaitCount)
            log.Printf("[ВНИМАНИЕ] Голодание пула: %d горутин ждали слот, среднее ожидание: %v (InUse: %d, Open: %d)",
                deltaWaitCount, avgWait, stats.InUse, stats.OpenConnections)
        }
    }
}
Когда инженеры видят рост WaitCount, первая реакция — задрать SetMaxOpenConns с 40 до 500. Но если у тебя развернуто 20 подов в Kubernetes, база получит до 10 000 параллельных сессий. PostgreSQL моментально упадет с ошибкой «sorry, too many clients already» из-за нехватки RAM на backend worker-процессы. Решать проблему нужно сокращением длительности транзакций и выносом долгих вычислений за пределы блокировок.