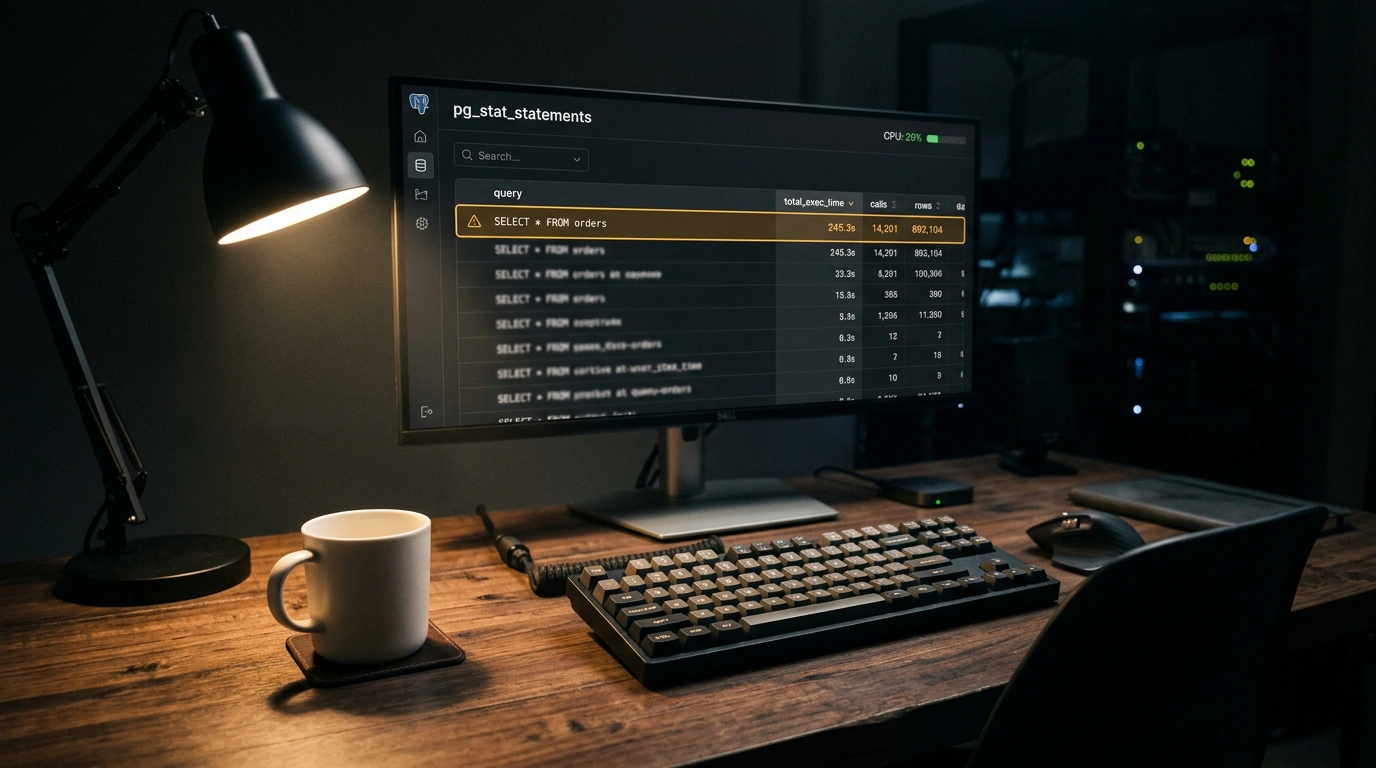

Представь классическую аварийную ситуацию в продакшене: пользователи жалуются на медленную работу сервиса, API-шлюзы начинают плеваться пятисотыми ошибками по таймауту, а бэкенд захлебывается в пуле соединений с базой. Ты открываешь панель мониторинга Grafana в полной уверенности, что увидишь полоку CPU под 100%, но там тишина и покой: утилизация ядер колеблется в районе скромных 20–25%, оперативной памяти хватает с запасом.
В чем дело? Первое, за что обычно хватается дежурный инженер, — директива log_min_duration_statement в логах PostgreSQL, настроенная на перехват запросов дольше одной или двух секунд. Ты открываешь логи — и там абсолютная пустота. База тормозит, а «медленных» запросов формально нет!
В материале Диагностика высококардинальных нагрузок в pg_stat_statements: как выявить вымывание кэша и непараметризованные запросы в PostgreSQL мы подробно разбирали природу таких аномалий. Ловушка кроется в том, что систему убивают не редкие тяжелые аналитические отчеты, а копеечные запросы, выполняющиеся за 2–3 миллисекунды, но дергающиеся по 500 000 раз в минуту из-за N+1 проблемы в ORM. В сумме они создают гигантскую дисковую очередь (I/O wait), блокируют буферный пул и намертво вешают транзакции.
Найти таких «скрытых убийц» помогает официальное расширение pg_stat_statements. Давай разберем, как его настроить и расшифровать показатели.
Включение расширения в postgresql.conf
Поскольку pg_stat_statements должен перехватывать выполнение всех входящих SQL-команд на уровне ядра СУБД, его разделяемая библиотека обязана загружаться при старте сервера.
Добавь в конфигурационный файл postgresql.conf следующие строки:
# Подгрузка модуля ядра
shared_preload_libraries = 'pg_stat_statements'

# Параметры трекинга
pg_stat_statements.max = 10000
pg_stat_statements.track = all
pg_stat_statements.track_planning = on
После перезапуска службы (sudo systemctl restart postgresql) подключись к своей рабочей базе данных и активируй расширение:
CREATE EXTENSION IF NOT EXISTS pg_stat_statements;
Накладные расходы модуля микроскопические (около 1–2% CPU), а польза для диагностики колоссальная: расширение нормализует запросы, заменяя конкретные ID на плейсхолдеры ($1, $2), и суммирует показатели работы.
Топ-10 запросов по суммарному времени нагрузки
Вместо того чтобы смотреть на среднее время одиночного вызова (mean_exec_time), отсортируем статистику по показателю total_exec_time — именно он показывает, сколько чистого серверного времени потратила база на обработку этого типа запросов:
SELECT calls,
       round(total_exec_time::numeric, 2) AS total_ms,
       round(mean_exec_time::numeric, 2) AS avg_ms,
       round((100 * total_exec_time / sum(total_exec_time) OVER ())::numeric, 2) AS pct_load,
       left(query, 100) AS query_preview
FROM pg_stat_statements
WHERE dbid = (SELECT oid FROM pg_database WHERE datname = current_database())
ORDER BY total_exec_time DESC
LIMIT 10;
Чаще всего на первой строчке ты увидишь не сложный аналитический отчет с пятью JOIN, а простейший SELECT * FROM orders WHERE customer_id = $1. Его среднее время может составлять крошечные 1.5 мс, но за счет сотен тысяч вызовов он забирает на себя 45% всего ресурса ввода-вывода СУБД!
Проверка плана и безопасное создание индекса
Запусти для проблемного запроса анализ с буферами:
EXPLAIN (ANALYZE, BUFFERS)
SELECT * FROM orders WHERE customer_id = 42;
Если в выводе виден Seq Scan (последовательное сканирование таблицы) и тысячи страниц в строке Buffers: shared read, значит, таблица выросла, и база вынуждена на каждый чих вычитывать гигабайты страниц с медленного диска в память.
Никогда не выполняй обычный CREATE INDEX на живой боевой таблице: он берет тяжелую блокировку SHARE, полностью замораживая все операции записи (INSERT, UPDATE, DELETE). Всегда используй конкурентное построение:
CREATE INDEX CONCURRENTLY idx_orders_customer_id ON orders (customer_id);
При таком подходе база строит индекс в два прохода, не блокируя пользовательские транзакции.
После создания индекса сбрось накопившуюся статистику функцией SELECT pg_stat_statements_reset(); и убедись, что суммарное время выполнения запросов упало в десятки раз.