
Рано или поздно любая растущая инженерная команда упирается в необходимость мультикластерного деплоя. Причины могут быть разными: требования регуляторов хранить данные пользователей в конкретной юрисдикции, защита от падения целого облачного провайдера (катастрофоустойчивость) или банальное желание сэкономить бюджет, вынеся тяжелые фоновые воркеры на дешевые bare-metal серверы.
Но как только ты начинаешь настраивать классическую федерацию (например, KubeFed или тяжелые централизованные платформы управления), ты создаешь единую точку отказа. Представь: управляющий кластер выходит из строя, либо сетевая задержка между регионами подскакивает до секунд. Вся синхронизация останавливается, а расхождение состояний грозит рассинхронизацией подов и ошибками split-brain.
В материале Связывание мультиоблачных кластеров Kubernetes с помощью Cilium Cluster Mesh мы разбирали, как объединять сетевые плоскости кластеров на уровне eBPF. А инженеры компании Kismet Engineering предложили логическое продолжение этой философии на уровне управления нагрузками — открытый GitOps-оператор Polykube.
Децентрализация вместо всемогущего управляющего кластера
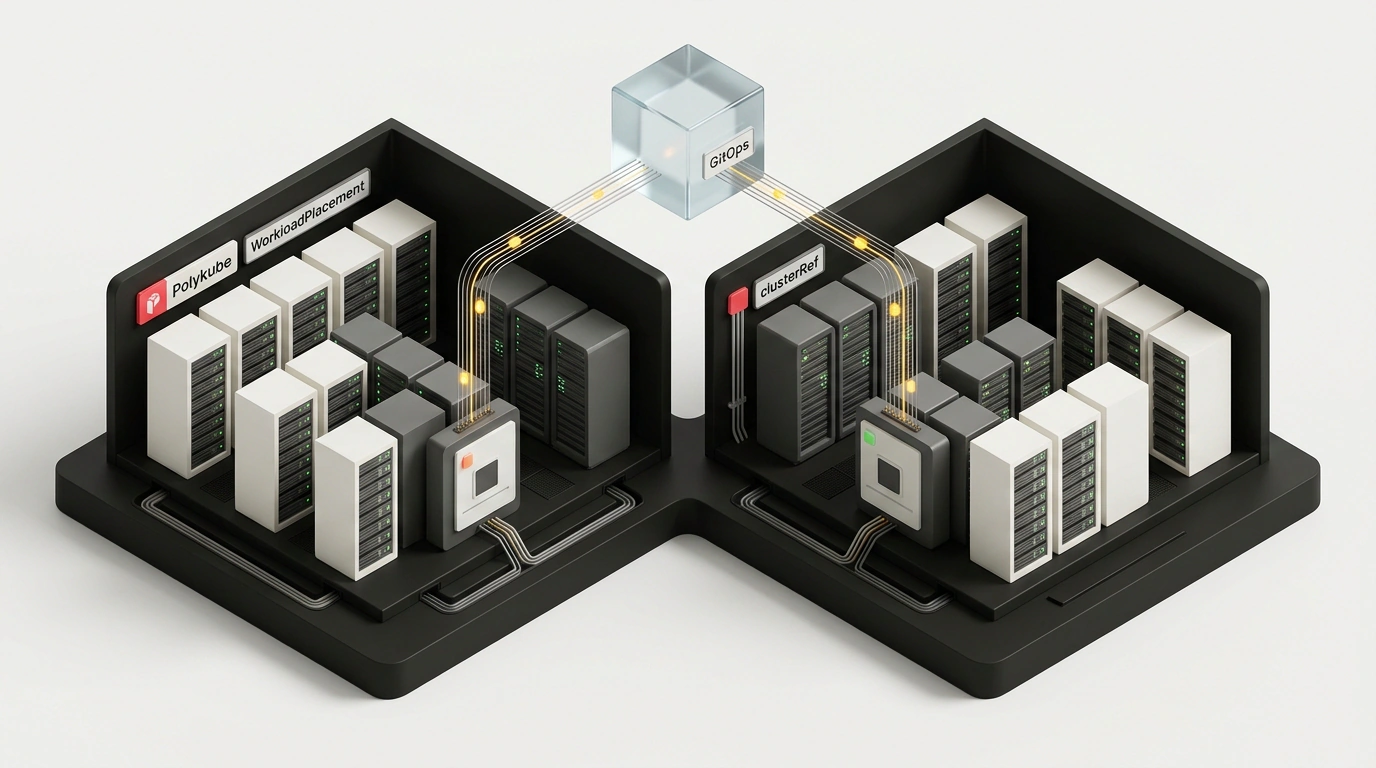
Главная архитектурная идея Polykube — полный отказ от единого централизованного control plane.
Каждый кластер в инфраструктуре компании (будь то AWS EKS во Франкфурте, Google GKE или локальная инсталляция в дата-центре) остается полностью суверенным и самодостаточным. Внутри каждого кластера разворачивается легковесный локальный агент Polykube.
Вместо того чтобы ждать команд от центрального мастера, локальные операторы самостоятельно вычитывают манифесты из общего Git-репозитория и реконсилируют желаемое состояние. Если связь между кластерами обрывается, каждый из них спокойно продолжает обслуживать клиентский трафик без деградации.
Декларативное распределение через CRD WorkloadPlacement
Разработчику микросервиса больше не нужно плодить десятки дублирующих deployment.yaml под каждый регион. Распределение описывается одной декларативной сущностью:
apiVersion: polykube.kismet.io/v1alpha1
kind: WorkloadPlacement
metadata:
  name: billing-api
  namespace: production
spec:
  # Стратегия балансировки подов между провайдерами
  distribution:
    strategy: MultiCloudWeighted
    targets:
      - clusterRef: aws-eu-central-1
        replicas: 6
        weight: 60
      - clusterRef: gcp-europe-west3
        replicas: 4
        weight: 40
  template:
    spec:
      containers:
        - name: api
          image: registry.example.com/billing:v3.2.0
          ports:
            - containerPort: 8080
          resources:
            requests:
              cpu: 300m
              memory: 512Mi
Локальный оператор на каждом кластере сверяет свой идентификатор с секцией targets, извлекает шаблон спецификации пода и автоматически создает локальный Deployment с нужным числом реплик.
Синхронизация через ArgoCD ApplicationSet
В реальном продакшене доставка таких манифестов автоматизируется через стандартный инструмент GitOps — генератор ApplicationSet в ArgoCD:
apiVersion: argoproj.io/v1alpha1
kind: ApplicationSet
metadata:
  name: polykube-workloads
  namespace: argocd
spec:
  generators:
    - clusters: {}
  template:
    metadata:
      name: '{{name}}-workloads'
    spec:
      project: default
      source:
        repoURL: https://git.example.com/infrastructure/gitops.git
        targetRevision: HEAD
        path: workloads/production
      destination:
        server: '{{server}}'
        namespace: production
      syncPolicy:
        automated:
          prune: true
          selfHeal: true
Помни об архитектурных ограничениях: Polykube спроектирован для переносимости stateless приложений (HTTP API, gRPC-микросервисы, фоновые воркеры очередей). Для баз данных со сложным состоянием (PostgreSQL, Redis, Kafka) мультикластерный перенос по-прежнему требует выделенной репликации на уровне СУБД (Patroni, CockroachDB), так как миграция постоянных томов Persistent Volumes между разными облаками на лету физически невозможна.