
Знакомо ощущение, когда открываешь ленту новостей с утренним кофе, а закрываешь ее через два часа с чугунной головой и чувством вины за сорванный график? В индустрии искусственного интеллекта инфошум давно превратился в стихийное бедствие. За одни сутки выходят десятки обновлений библиотек, сотни постов на Reddit с громкими обещаниями революций и терабайты видеороликов, пересказывающих чужие пресс-релизы.
Первая мысль любого энтузиаста — автоматизировать эту рутину. Натравить нейросеть на ленты и пусть читает за нас! Но если ты попробуешь скормить все эти 800+ ежедневных страниц напрямую во флагманскую модель вроде Claude Sonnet или Opus, твой кошелек быстро взмолится о пощаде: такой мониторинг обойдется в десятки долларов ежедневно.
Инженер Коул Медин (Cole Medin) придумал элегантное инженерное решение. Вместо монолитного скрипта он создал открытый агентский навык build-signal-engine, который разворачивает каскадную шестиэтапную систему фильтрации. Она отсекает шелуху на ранних этапах и оставляет для умной модели только чистый концентрат пользы.
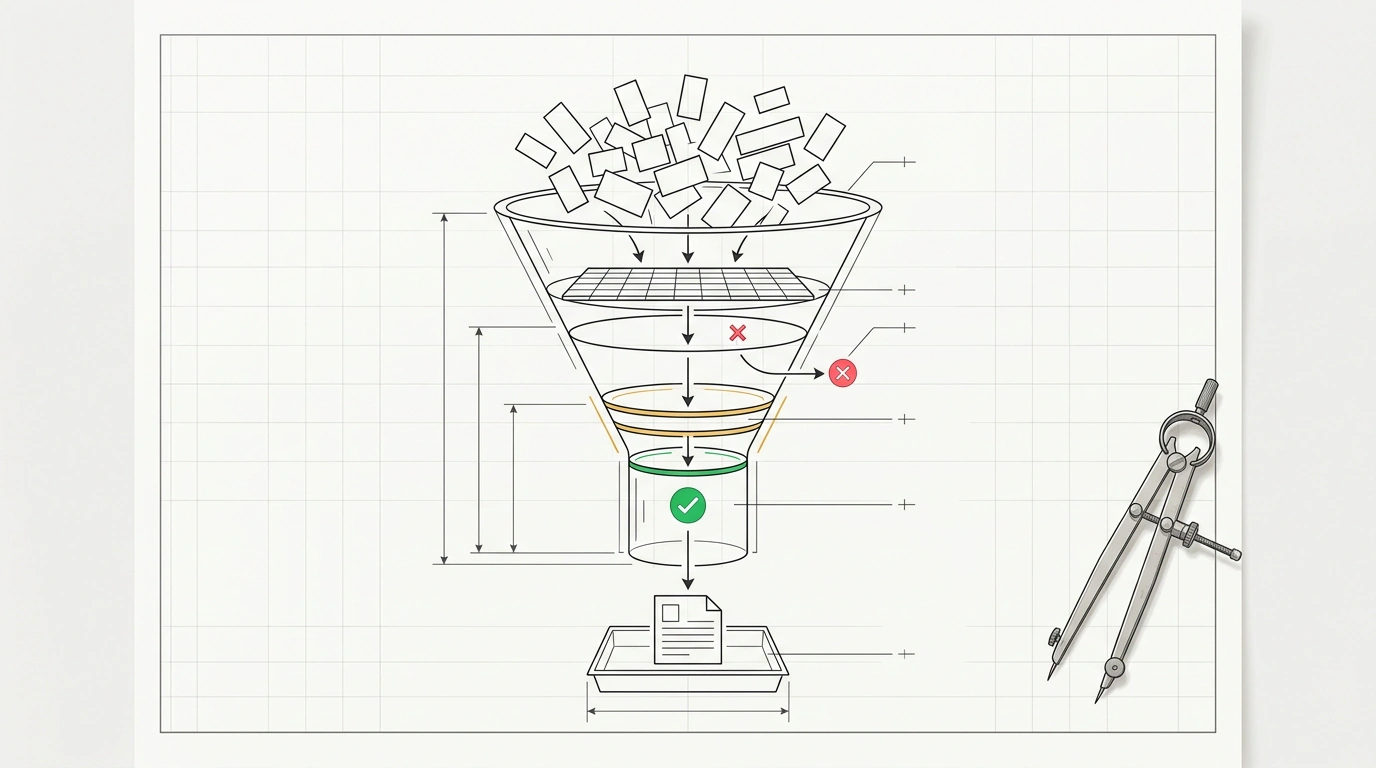
Разделение труда: архитектура умной воронки
В основе подхода лежит здравый принцип разделения труда: дорогие языковые модели должны подключаться только тогда, когда без них физически невозможно обойтись. Весь пайплайн состоит из шести четких уровней:
- Сбор сырых данных: облачные пауки платформы Apify и RSS-парсеры вытягивают свежие публикации из целевых сообществ (r/LocalLLaMA, r/MachineLearning, релизы на GitHub и блоги лабораторий).
- Детерминированная дедупликация: система вычисляет SHA-256 хэши URL-адресов и заголовков. Если новость уже обрабатывалась ранее, она отбрасывается моментально без траты вычислительных ресурсов.
- Эвристические код-фильтры: жесткие правила на Python отсекают заведомый мусор — посты короче 80 символов, сообщения с нулевым количеством комментариев или рекламные кликбейты.
- Первый эшелон триажа: легковесный классификатор за доли цента проверяет, относится ли оставшийся материал к заявленным ключевым темам.
- Семантическая оценка на Claude Haiku: компактная и быстрая модель сопоставляет содержание статьи с персональным файлом интересов пользователя и выставляет оценку полезности от 0 до 10.
- Утренняя кристаллизация: лучшие материалы с оценкой выше пороговой упаковываются в лаконичный дайджест и бережно сохраняются в твою локальную базу знаний Obsidian.
Благодаря такой воронке обработка 864 страниц в сутки обходится всего в $0.45 в день (около $3 в месяц на сбор данных и около 40 центов на запросы к Haiku).
Ранее мы разбирали, как создавать самосовершенствующиеся навыки для ИИ-ассистентов, и этот подход идеально ложится в ту же концепцию.
Развертывание и конфигурация конвейера
Навык устанавливается непосредственно в окружение Claude Code или Cursor через реестр агентских навыков:
# Установка навыка в локальное рабочее окружение
npx skills add coleam00/skills --skill build-signal-engine

# Запуск интерактивного проектирования в сессии Claude Code
/build-signal-engine
После вызова команды агент проведет короткое интерактивное интервью: спросит, какие темы тебе интересны в первую очередь (например, локальные модели, протоколы MCP или инфраструктура инференса), какие источники ты считаешь авторитетными и в какое время присылать отчет.
По итогам интервью в проекте появится конфигурационный файл sources.json, где зафиксированы все каналы мониторинга:
{
  "version": "1.0",
  "schedule": "0 7 * * *",
  "sources": [
    {
      "id": "anthropic-news",
      "type": "rss",
      "url": "https://www.anthropic.com/news/rss.xml",
      "priority": "high"
    },
    {
      "id": "github-trending-ai",
      "type": "github_releases",
      "repositories": [
        "anthropics/anthropic-sdk-python",
        "NousResearch/hermes-agent"
      ]
    },
    {
      "id": "apify-reddit-ai",
      "type": "apify_actor",
      "actorId": "trudax/reddit-scraper-lite",
      "input": {
        "subreddits": ["LocalLLaMA", "MachineLearning"],
        "maxItems": 50,
        "sort": "hot"
      }
    }
  ]
}
А за дедупликацию и предварительный отсев отвечает легковесный Python-модуль, отсекающий информационный шум до обращения к платным API:
import hashlib
from typing import List, Dict

# Этап 1: Дедупликация по хэшу URL
def deduplicate_items(items: List[Dict], seen_hashes: set) -> List[Dict]:
    unique = []
    for item in items:
        content_hash = hashlib.sha256(item["url"].encode("utf-8")).hexdigest()
        if content_hash not in seen_hashes:
            seen_hashes.add(content_hash)
            unique.append(item)
    return unique

# Этап 2: Детерминированный эвристический фильтр
def code_heuristics_filter(item: Dict) -> bool:
    # Отсекаем посты с минимальным откликом и короткие анонсы
    if item.get("score", 0) < 5 and item.get("comments_count", 0) < 3:
        return False
    if len(item.get("text", "")) < 80:
        return False
    return True

# Этап 3: Быстрый скоринг перед отправкой в Claude Haiku
def evaluate_signal_score(item: Dict, target_keywords: List[str]) -> float:
    text = (item["title"] + " " + item["text"]).lower()
    matches = sum(1 for kw in target_keywords if kw.lower() in text)
    return min(1.0, matches / max(1, len(target_keywords)))
Главное достоинство спецификации Claude Skill — гибкость. Если через неделю ты поймешь, что устал от новостей про генерацию картинок и хочешь следить только за квантованием моделей и протоколами MCP, не нужно лезть в код парсера. Достаточно открыть файл своего профиля profile.md и на обычном русском языке написать новые приоритеты. Конвейер мгновенно перестроит веса семантического отбора.
Ограничения и риски автоматизации
Как и в любой автоматизированной системе, здесь есть нюансы, о которых стоит знать заранее:
- Хрупкость веб-скрейпинга: Социальные платформы вроде Reddit регулярно обновляют разметку и ужесточают защиту от ботов. Время от времени акторы на Apify требуют обновления версий.
- Риск ложного отсева (False Negatives): Если выставить слишком жесткие эвристические фильтры по числу комментариев, можно пропустить глубокую техническую статью малоизвестного исследователя, которую еще не успели заметить массы. Первые несколько дней работы системы полезно бегло просматривать отброшенные кандидаты для калибровки порогов.
Собери такой конвейер один раз — и утреннее чтение новостей снова начнет приносить знания и вдохновение, а не информационное похмелье.