
Представь классическую ночную смену дежурного инженера: мониторинг внезапно зажигает тревожные алерты, микросервис на Go в кластере Kubernetes уходит в циклический рестарт (CrashLoopBackOff), а в выводе команды kubectl describe pod красуется лаконичная и беспощадная строчка: OOMKilled с кодом завершения 137. Ты судорожно открываешь дашборды в Grafana, смотришь на график потребления кучи приложения (go_memstats_heap_alloc_bytes) — а там тишь да гладь. Память приложения не превышала и половины установленного лимита, никаких резких всплесков вроде бы не видно, но ядро операционной системы безжалостно пристрелило рабочий процесс.
Если ты хоть раз сталкивался с подобным поведением в продакшене, добро пожаловать в клуб. Я сам провел немало часов, разбирая дампы памяти и пытаясь свести концы с концами между метриками рантайма Go и реальным поведением контрольных групп ядра Linux. На первый взгляд это выглядит как мистика или ошибка виртуализации, но под капотом здесь скрывается вполне закономерный архитектурный конфликт двух абсолютно разных миров. С одной стороны находится рантайм Go, исторически созданный в парадигме полного владения физическим сервером. С другой — контейнерная среда Kubernetes, где изоляция строится на базе подсистем ядра Linux cgroups и квот планировщика CFS.
Давай разберем эту механику до самого основания: выясним, почему контейнеры улетают в нокдаун, как работают запросы (requests) и лимиты (limits), чем опасен троттлинг процессора и как связка параметров GOMEMLIMIT и нативной поддержки контейнеров в Go 1.25 позволяет построить по-настоящему надежный сервис.
Загадка внезапного падения: почему размер кучи не равен потреблению pod'а
Первая ментальная ловушка, в которую попадают разработчики при переносе сервисов в Kubernetes, — знак равенства между активной памятью процесса и размером выделенной кучи (Go heap). Разработчик рассуждает просто: «Мое приложение держит в памяти структуры на 200 мегабайт, лимит в манифесте пода равен 512 мегабайтам, значит, у нас есть двукратный запас прочности». К сожалению, ядро Linux смотрит на вещи совершенно иначе.
Для операционной системы твой Go-сервис — это обычный процесс, чье совокупное потребление оперативной памяти оценивается через показатель Working Set Size (WSS) или Resident Set Size (RSS). И куча Go — это лишь одна из многих составляющих этого объема. Помимо объектов в куче, в оперативную память процесса входят:
- Стеки горутин. Каждая новая горутина стартует с компактного стека размером 2 КБ, но при глубоком стеке вызовов или активной рекурсии он динамически разрастается. Если в сервисе одновременно крутятся десятки тысяч активных соединений, одни только стеки способны отъесть сотни мегабайт.
- Пространство самого бинарного файла и загруженных динамических библиотек.
- Внутренние структуры и метаданные рантайма Go (карты распределения блоков аллокатора, структуры планировщика, кэши mcache и mcentral).
- Память, выделяемая вне юрисдикции Go: системные сетевые буферы сокетов, дисковые буферы ввода-вывода и любые аллокации через C-библиотеки (
cgo) или системный вызовmmap. - Фрагментация памяти. Аллокатор Go возвращает освобожденные страницы операционной системе не мгновенно, а с помощью системного вызова
madviseс флагомMADV_DONTNEEDилиMADV_FREE. Для операционной системы эти страницы могут продолжать числиться за процессом вплоть до момента острой нехватки памяти на ноде.
В подробном руководстве от LearnKube наглядно показано: если сборщик мусора Go ожидает удвоения кучи со 150 до 300 МиБ, а системные накладные расходы и буферы занимают еще 250 МиБ, суммарный объем Resident Set Size подскакивает до 550 МиБ. Как только счетчик страниц в контрольной группе превышает установленный лимит в 512 МиБ, ядро Linux мгновенно присылает процессу сигнал SIGKILL. Приложение даже не успевает выбросить панику, записать лог или выполнить зарегистрированные defer-функции — процесс просто испаряется из памяти.
Запросы против лимитов: как планировщик и cgroups делят физическое железо
Чтобы понять, как обезопасить сервис, необходимо четко разделять две сущности в спецификации Kubernetes: resources.requests и resources.limits. В манифесте пода они часто объявляются рядом, но за ними стоят совершенно разные подсистемы кластера и ядра.
Параметр requests (запросы) предназначен исключительно для планировщика kube-scheduler. Когда pod создается в кластере, планировщик ищет рабочий узел (worker node), где суммарный объем нераспределенных запросов позволяет разместить новую нагрузку. Запрос — это гарантия того, что на узле физически зарезервированы эти мегабайты памяти и милликоры процессора. Если узел перегружен, pod никогда не попадет на него.
Параметр limits (лимиты), напротив, транслируется агентом kubelet напрямую в настройки ядра Linux через подсистему контрольных групп cgroups. Лимит определяет потолок: сколько ресурсов процессу разрешено утилизировать в моменте. И здесь кроется фундаментальная разница между тем, как ядро обрабатывает сжимаемые (compressible) и несжимаемые (incompressible) ресурсы.
Процессор (CPU) — это сжимаемый ресурс. Если твое приложение пытается потребить больше процессорных тактов, чем положено по лимиту, ядро не убивает процесс. Оно просто принудительно приостанавливает его выполнение, откладывая вычисления на следующие временные кванты. Сервис начинает работать медленнее, задержки ответов растут, но процесс остается живым.
Оперативная память (Memory) — ресурс принципиально несжимаемый. Нельзя «замедлить» чтение из памяти или попросить процесс временно забыть байты, которые уже выделены в физических страницах RAM. Если приложению требуется новый блок памяти, а лимит контрольной группы уже исчерпан, у операционной системы остается ровно два пути: экстренно найти память в дисковом кэше или немедленно ликвидировать нарушителя.
В нашем предыдущем материале о том, как управление переподпиской ресурсов в Kubernetes помогает находить баланс утилизации нод, мы уже касались вопроса выбора QoS-классов. Если у пода значения requests и limits равны, он получает наивысший приоритет Guaranteed. Если requests меньше limits — класс Burstable. Именно сервисы класса Burstable чаще всего становятся первыми кандидатами на расстрел при нехватке физической памяти на сервере.
Механика OOMKilled в Linux: что происходит в ядре перед выстрелом SIGKILL
Давай заглянем под капот ядра Linux и проследим по шагам, что именно происходит в момент исчерпания лимита памяти контейнера.
В современных дистрибутивах Linux управление ресурсами контейнеров осуществляется через объединенную иерархию cgroups v2 (в отличие от устаревшей cgroups v1, где подсистемы памяти, процессора и ввода-вывода жили в раздельных директориях). Внутри cgroups v2 лимит памяти задается псевдофайлом memory.max:
memory.maxопределяет абсолютный жесткий потолок объема памяти.- Дополнительный файл
memory.highзадает мягкий порог, при достижении которого ядро начинает искусственно замедлять аллокации процесса и форсировать очистку кэша, но сохраняет процессу жизнь.
Когда Go-приложение запрашивает у ядра новую страницу памяти через системный вызов mmap или brk, страничная подсистема ядра проверяет счетчик текущего использования контрольной группы. Если добавление новой страницы пробивает потолок memory.max, ядро не вызывает OOM Killer сию же секунду. Сначала предпринимается отчаянная попытка локального освобождения страниц (page reclaim): ядро сбрасывает на диск грязные файловые страницы, очищает дисковый кэш чтения и удаляет неиспользуемые страницы библиотек.
Если после агрессивного сброса кэшей свободного места в пределах лимита по-прежнему нет, ядро активирует механизм mem_cgroup_out_of_memory. Специальный алгоритм подсчитывает показатель oom_score для всех процессов, находящихся внутри данной контрольной группы. Поскольку в контейнере микросервиса обычно работает всего один основной бинарник Go, именно он получает максимальный балл штрафа.
Ядро генерирует системный вызов на отправку неотвратимого сигнала SIGKILL (сигнал номер 9). В кольцевом буфере сообщений ядра dmesg появляется характерная запись:
Memory cgroup out of memory: Killed process 142091 (my-go-service) total-vm:845120kB, anon-rss:514100kB, file-rss:1240kB, shmem-rss:0kB, UID:1000 pgtables:1248kB oom_score_adj:998
Kubernetes отслеживает завершение контейнера и формирует статус: код завершения 137 (вычисляемый как 128 + 9). Процесс прекращает существование за доли микросекунды.
Параметр GOMEMLIMIT контролирует исключительно память, которой управляет внутренний аллокатор рантайма Go. Он бессилен перед утечками памяти в коде на C/C++ через cgo, аллокациями через прямой mmap минуя рантайм или лавинообразным ростом сетевых буферов ядра операционной системы.
Рубеж GOMEMLIMIT: настраиваем предохранитель от деградации сборщика мусора
Почему же сборщик мусора Go сам не навел порядок в памяти до того, как пришел OOM Killer? Дело в том, как устроен классический GC в Go.
Исторически сборщик мусора Go опирался на единственный регулировочный винт — переменную окружения GOGC (по умолчанию равную 100). Алгоритм трехцветной сборки мусора вычисляет следующий порог запуска GC по тривиальной формуле:
TargetHeap = LiveHeap + (LiveHeap * GOGC / 100)
Если после предыдущей сборки мусора в куче осталось 100 МиБ живых данных, то при GOGC=100 следующий цикл сборки начнется только тогда, когда куча вырастет до 200 МиБ. Если сервис находится под высокой нагрузкой и генерирует много временных объектов, куча мгновенно удваивается. Если же ты попытаешься уменьшить GOGC (например, выставишь GOGC=20), сборщик мусора начнет срабатывать непрерывно. Нагрузка на процессор подскочит до небес, приложение будет тратить львиную долю квантов на маркировку объектов (явление, известное как GC thrashing), а пропускная способность сервиса рухнет.
Чтобы разорвать этот замкнутый круг, инженеры Go представили концепцию мягкого лимита памяти — GOMEMLIMIT. Подробно этот механизм описан в официальном руководстве по GC.
Идея GOMEMLIMIT элегантна:
- Пока потребление памяти далеко от установленной границы, сборщик мусора работает в обычном спокойном темпе согласно коэффициенту
GOGC, не нагружая процессор лишними циклами. - Когда суммарный объем памяти приближается к границе
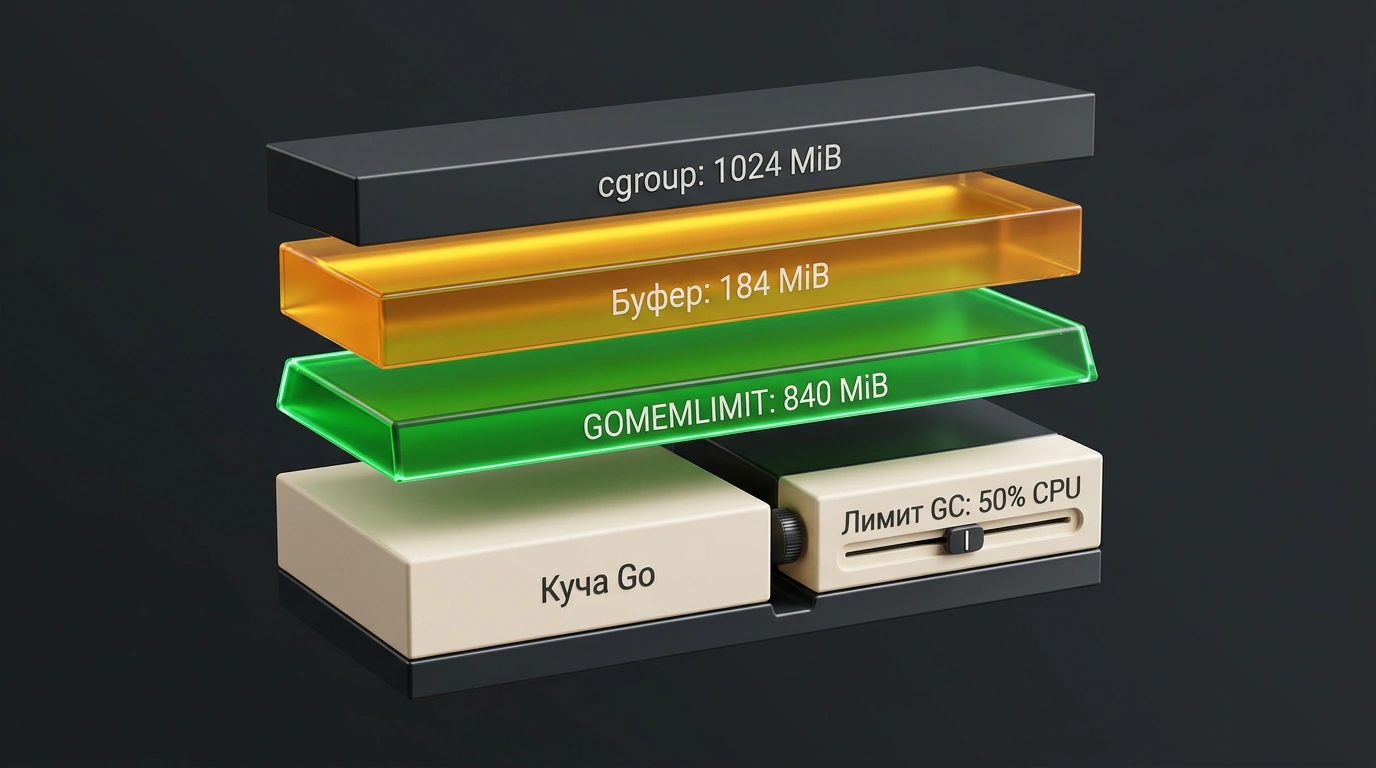
GOMEMLIMIT, внутренний регулятор (GC pacer) динамически и плавно сдвигает порог срабатывания сборщика, заставляя его очищать память чаще и предотвращая превышение заданного рубежа. - В рантайм встроен защитный предохранитель: сборщик мусора не может утилизировать более 50% вычислительной мощности доступных процессорных ядер. Если в программе возникла неустранимая утечка памяти и даже непрерывная работа GC не в силах опустить объем кучи ниже
GOMEMLIMIT, рантайм позволяет памяти вырасти выше лимита, предпочитая упасть от OOM, чем войти в состояние мертвого зависания.
Главная ошибка неопытных инженеров — установить GOMEMLIMIT в точности равным значению resources.limits.memory в манифесте Kubernetes. Делать так категорически нельзя! Если твой лимит памяти в Kubernetes равен 1 ГиБ, а ты выставишь GOMEMLIMIT=1GiB, процесс неизбежно погибнет. Ведь вне контроля GOMEMLIMIT остаются бинарник, стеки горутин, структуры ядра и фрагментация.
Для надежной работы сервиса выставляй GOMEMLIMIT с запасом в 15–20% от жесткого лимита контейнера. Если лимит пода составляет 1000 МиБ, оптимальное значение GOMEMLIMIT находится в диапазоне 800–850 МиБ. Для крупных подов объемом более 4 ГиБ безопасный зазор можно уменьшить до 10–12%.
Взгляни на практический пример кода, как можно динамически программно контролировать этот лимит или считывать его состояние через стандартный пакет runtime/debug:
package main

import (
    "fmt"
    "log"
    "os"
    "runtime"
    "runtime/debug"
)

func initMemoryLimits() {
    // Считываем текущий установленный предел памяти
    currentLimit := debug.SetMemoryLimit(-1)
    fmt.Printf("Текущий GOMEMLIMIT: %d байт (%.2f МиБ)\n",
        currentLimit, float64(currentLimit)/(1024*1024))

    // При необходимости предел можно скорректировать прямо из кода,
    // например, если приложение прочитало лимит из файла cgroup v2
    memLimitEnv := os.Getenv("AUTO_CONFIGURE_GOMEMLIMIT")
    if memLimitEnv == "true" {
        // Устанавливаем мягкий лимит 850 МиБ
        const targetLimit = 850 * 1024 * 1024
        previous := debug.SetMemoryLimit(targetLimit)
        log.Printf("GOMEMLIMIT обновлен: старый=%d, новый=%d\n", previous, targetLimit)
    }

    var m runtime.MemStats
    runtime.ReadMemStats(&m)
    fmt.Printf("Выделено в куче: %.2f МиБ, получено от ОС: %.2f МиБ\n",
        float64(m.Alloc)/(1024*1024), float64(m.Sys)/(1024*1024))
}
Ловушка процессорных квот CFS: почему 16 горутин сжигают окно за 12 миллисекунд
Разобравшись с памятью, мы обязаны взглянуть на вторую сторону медали — процессорные лимиты. Здесь разработчиков подстерегает не менее коварная ловушка, имя которой — CPU Throttling.
Когда ты указываешь в спецификации пода директиву resources.limits.cpu: "2", что это означает на физическом уровне? Большинство разработчиков интуитивно полагают, что планировщик операционной системы выделяет контейнеру два выделенных процессорных ядра. Но в реальности Linux работает совершенно иначе. Лимит CPU транслируется в квоту планировщика Completely Fair Scheduler (CFS).
В cgroups v2 параметры CFS задаются через файл cpu.max, в котором записаны два числа: квота (quota) и период (period) в микросекундах. Стандартный период квантования в ядре Linux составляет 100 000 микросекунд (100 миллисекунд). Когда ты выставляешь лимит cpu: 2, ядро рассчитывает квоту как:
quota = 2 * 100 000 мкс = 200 000 мкс (200 мс)
Это означает следующее: суммарно всем системным потокам твоего контейнера разрешено выполнять инструкции ровно 200 миллисекунд внутри каждого 100-миллисекундного окна.
А теперь представь классический высоконагруженный сервер с 64 физическими ядрами, на котором запущен твой контейнер с лимитом cpu: 2. До недавнего времени рантайм Go при старте смотрел на количество ядер операционной системы через runtime.NumCPU() и бодро выставлял внутреннюю переменную GOMAXPROCS равной 64!
Что происходило дальше? Рантайм Go инициализировал 64 логических процессора (P) и порождал десятки системных потоков ОС (M). Под нагрузкой 16 или 32 потока одновременно брали в работу входящие HTTP-запросы. Смотри, какая занимательная арифметика:
- 16 параллельных потоков одновременно работают на разных физических ядрах мощного сервера.
- Каждый поток работает всего 12.5 миллисекунд.
- Суммарное потребление процессорного времени составляет:
16 потоков * 12.5 мс = 200 миллисекунд!
Квота контейнера на текущий 100-миллисекундный период оказывается полностью исчерпанной всего за 12.5 миллисекунд с начала периода! Что делает ядро Linux в оставшиеся 87.5 миллисекунд? Оно принудительно «замораживает» (throttles) все потоки контейнера. Ни одна горутина не сдвинется с места, ни один сетевой пакет не обработается. Клиенты видят колоссальные спайки задержек на перцентилях p99 и p99.9, а мониторинг рапортует о 80% троттлинга при смешной общей загрузке процессора.
Эволюция GOMAXPROCS: как Go 1.25+ научился жить в контейнерах из коробки
На протяжении долгих лет де-факто стандартом спасения от процессорного троттлинга в сообществе Go была сторонняя библиотека go.uber.org/automaxprocs. Разработчики подключали ее анонимным импортом (import _ "go.uber.org/automaxprocs"), библиотека при старте процесса читала пути в /sys/fs/cgroup/cpu и автоматически вызывала runtime.GOMAXPROCS(), округляя квоту до целого числа.
Однако зависимость от сторонних библиотек для такой фундаментальной задачи вызывала массу споров. Наконец, в релизах Go 1.25 и 1.26 команда разработки рантайма внедрила нативную осведомленность о контейнерах. Мы подробно разбирали эту трансформацию в исследовании о том, как Go 1.25 в контейнерах защищает микросервисы от троттлинга CPU в Kubernetes.
Согласно официальной документации рантайма Go, поведение планировщика управляется флагами containermaxprocs и updatemaxprocs:
- При старте рантайм автоматически считывает квоты CFS из cgroups v1 или cgroups v2.
- Значение
GOMAXPROCSвычисляется по формуле:min(NumCPU, AffinityCPUs, ceil(Quota / Period)). - Особенность реализации: разработчики Go заложили минимальный порог
GOMAXPROCS=2, если на машине физически доступно более одного ядра. Логика команды заключается в том, что рантайму критически необходим хотя бы один дополнительный поток для системных задач: фонового сканирования памяти сборщиком мусора, обработки сетевого поллера и системных вызовов. - При динамическом изменении ресурсов пода на лету (in-place pod resize в свежих версиях Kubernetes) рантайм способен подхватывать обновленные квоты без необходимости перезапуска контейнера.
Если твоему микросервису выделена дробная квота меньше одного ядра (например, cpu: 500m), автоматическое выставление GOMAXPROCS=2 может приводить к тому, что два потока израсходуют 50 мс квоты за 25 мс. Поэтому для экстремально маленьких контейнеров по-прежнему рекомендуется явно проверять задержки и при необходимости фиксировать GOMAXPROCS=1 вручную.
Боевой рецепт для продакшена: манифест, переменные окружения и мониторинг
Давай соберем все полученные знания в единый, проверенный практикой рецепт. Как должен выглядеть боевой манифест развертывания Deployment в Kubernetes для Go-микросервиса, чтобы навсегда забыть об OOMKilled и троттлинге?
Ниже представлен эталонный фрагмент спецификации pod'а:
apiVersion: apps/v1
kind: Deployment
metadata:
  name: billing-service
  namespace: production
spec:
  replicas: 3
  selector:
    matchLabels:
      app: billing-service
  template:
    metadata:
      labels:
        app: billing-service
    spec:
      containers:
      - name: server
        image: billing-service:v2.4.1
        resources:
          # Запросы гарантируют резерв планировщика на узле
          requests:
            cpu: "1000m"
            memory: "768Mi"
          # Лимиты задают жесткие границы ядра cgroup
          limits:
            cpu: "2000m"
            memory: "1024Mi"
        env:
        # GOMEMLIMIT задаем с зазором 15-20% от limits.memory (1024Mi * 0.82 ≈ 840MiB)
        - name: GOMEMLIMIT
          value: "840MiB"
        # Сохраняем стандартный GOGC=100 для сбалансированной нагрузки на CPU
        - name: GOGC
          value: "100"
        # Управление нативным планировщиком Go 1.25+ через GODEBUG
        - name: GODEBUG
          value: "containermaxprocs=1,updatemaxprocs=1"
        ports:
        - containerPort: 8080
          name: http
        - containerPort: 9090
          name: metrics
Обрати внимание на пропорции:
- Мы запросили у планировщика 768 МиБ памяти и гарантировали 1 процессорное ядро.
- Жесткий лимит установили на уровне 1024 МиБ и 2 ядер.
- Переменную
GOMEMLIMITзафиксировали на отметке840MiB. Это оставляет безопасный карман размером почти 184 МиБ на нужды стеков горутин, структуры рантайма, сетевые буферы и динамические библиотеки. - Флаги
containermaxprocs=1вGODEBUGгарантируют, что рантайм адаптирует потоки к лимиту в 2 ядра, исключая дикий троттлинг на многоядерных серверах.
Дополнительно в коде приложения полезно регулярно отслеживать внутренние метрики через Prometheus Go Collector. Метрика go_memstats_heap_alloc_bytes покажет реальную кучу, go_memstats_sys_bytes отобразит объем памяти, запрошенной у операционной системы, а счетчик go_gc_pauses_seconds_total позволит вовремя заметить, если сборщик мусора начнет подходить к критической границе в 50% загрузки CPU.
В глубоком разборе того, как архитектура аллокатора Go 1.27 экономит память и ускоряет рантайм, мы увидим продолжение этой эволюции: специализированные бакеты аллокаций и оптимизация страничных кэшей позволяют выжимать из контейнеров еще больше производительности. Но фундамент остается неизменным: уважение к границам ядра Linux, понимание физики контейнеров и грамотный расчет ресурсов.