

Если твоей команде доводилось развертывать открытые языковые модели — скажем, семейство Qwen 2.5, Llama 3 или свежие чекпоинты DeepSeek — в собственном закрытом контуре, ты наверняка прочувствовал всю боль современного рынка вычислений. Достать монолитный пул из нескольких десятков ускорителей NVIDIA H100 у одного облачного провайдера сегодня либо невозможно из-за очередей, либо неоправданно дорого.
В реальности инфраструктура быстро превращается в лоскутное одеяло. Две ноды с A100 арендованы в AWS, кластер с L40S крутится в специализированном неоклауде вроде CoreWeave или Lambda Labs, а еще пара серверов с потребительскими картами RTX 4090 стоит на собственной площадке под эксперименты. На уровне одиночного пода в Kubernetes стек давно понятен: берем движок vLLM или SGLang, настраиваем PagedAttention, прикручиваем автомасштабирование через KEDA. Но как только подов становится больше десятка, а кластеры разбросаны по трем континентам, платформенная команда тонет в ручном роутинге трафика и согласовании версий.
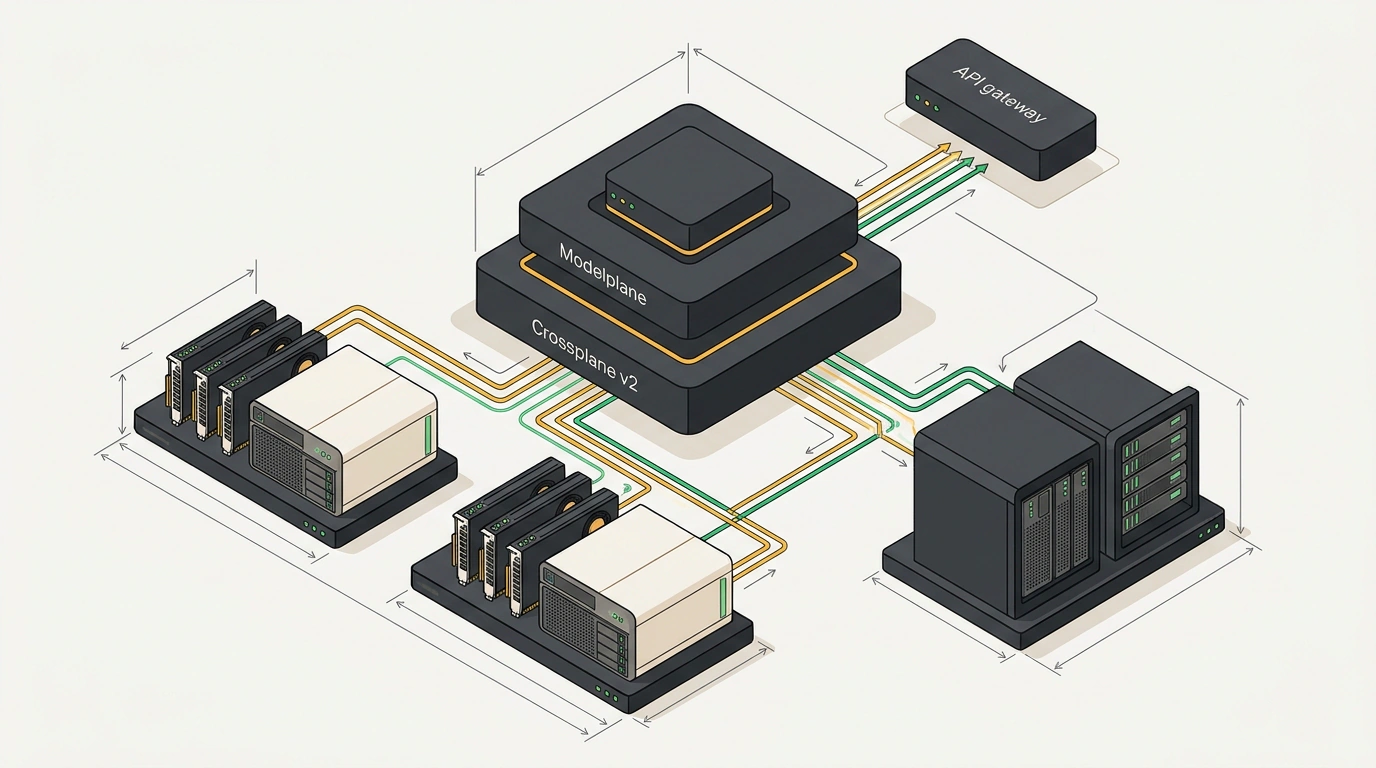
Архитектурный ответ на этот хаос предложил Ник Коуп (Nic Cope), один из ключевых мейнтейнеров проекта Crossplane на протяжении последних восьми лет. Его новый открытый проект Modelplane превращает фрагментированный зоопарк GPU в единую управляемую платформу инференса, используя проверенные временем абстракции Kubernetes.
Архитектура управляющего слоя: Crossplane v2 вместо самодельных операторов
Главная инженерная смелость Modelplane заключается в том, от чего автор сознательно отказался. Первым порывом любого архитектора в подобной ситуации было бы сесть и написать с нуля очередной тяжелый Kubernetes-оператор на Go с десятком кастомных контроллеров, самописными циклами согласования и хрупкой логикой синхронизации состояний.
Коуп пошел другим путем: Modelplane целиком построен на нативных абстракциях ядра Crossplane v2 — составных ресурсах (Composite Resource Definitions, XRD), композициях (Compositions) и функциях композиций (Composition Functions). Вместо изобретения велосипеда проект использует готовые механизмы ядра:
- надежные циклы согласования (reconciliation loops);
- финализаторы удаления ресурсов;
- автоматическую защиту от дрифта конфигураций в рантайме;
- нативную модель пространств имен (Namespaced Composites), появившуюся во второй мажорной версии Crossplane и избавившую платформу от громоздкой связки Claim/XR.
Сами функции композиции написаны на Python — основном языке современного машинного обучения. Благодаря генерации схем и строго типизированных классов через свежий Crossplane CLI, логику размещения моделей удалось описать компактно и без риска опечаток в бесконечных YAML-словарях.
Декларативное управление: CEL-фильтры для видеопамяти
В Modelplane четко разделены две зоны ответственности:
- Платформенные инженеры оперируют кластерными сущностями
InferenceClusterиInferenceClass. Они подключают облачные провайдеры Crossplane, заказывают виртуальные машины и следят за физическим здоровьем узлов. - ML-разработчики работают исключительно на уровне пространств имен проектов через ресурс
ModelDeployment. Им не нужно знать IP-адреса и топологию сети: они просто заявляют, какую модель хотят запустить и сколько видеопамяти ей требуется.
Для формулирования требований к железу используется язык Common Expression Language (CEL). Давай посмотрим, как выглядит типовой манифест развертывания модели:
apiVersion: modelplane.ai/v1alpha1
kind: ModelDeployment
metadata:
  name: qwen3-8b
  namespace: ml-team
spec:
  replicas: 2
  engines:
  - name: qwen-engine
    members:
    - role: Standalone
    nodeSelector:
      devices:
      - name: gpu
        count: 1
        selectors:
        - cel: device.capacity["gpu.nvidia.com"].memory.compareTo(quantity("20Gi")) >= 0
    template:
      spec:
        containers:
        - name: engine
          image: vllm/vllm-openai:v0.23.0
          args:
          - "--model=Qwen/Qwen3-8B"
          - "--served-model-name=qwen"
Обрати внимание на селектор CEL: вместо жесткой привязки к конкретной модели карты вроде nvidia.com/gpu-model: A100-SXM4-80GB манифест декларирует минимальный порог видеопамяти в 20 гигабайт. Планировщик Modelplane сам найдет подходящую свободную ноду — будь то L40S, A100 или урезанная инстанс-карта в облаке.
Инфраструктурный контур: Composite Resource Definitions
На платформенном уровне управляющий контур транслирует высокоуровневые запросы команды разработки в конкретные инфраструктурные ресурсы. Ниже приведен пример манифеста Composition, связывающего платформенный класс инференса с физическим кластером:
apiVersion: apiextensions.crossplane.io/v1
kind: Composition
metadata:
  name: inference-cluster-aws
  labels:
    provider: aws
    tier: high-memory
spec:
  compositeTypeRef:
    apiVersion: modelplane.ai/v1alpha1
    kind: InferenceCluster
  mode: Pipeline
  pipeline:
  - step: provision-gpu-nodes
    functionRef:
      name: function-python-placement
    input:
      apiVersion: modelplane.ai/v1alpha1
      kind: PlacementConfig
      minVramPerNode: "80Gi"
      spotTolerance: true
Функция размещения function-python-placement на лету опрашивает метрики доступности квот в подключенных аккаунтах, поднимает спотовые инстансы для экономии бюджета и динамически конфигурирует пограничный шлюз маршрутизации.
Динамический шедулинг и OpenAI-совместимый шлюз
Для прикладных сервисов компании вся эта сложная гибридная архитектура выглядит как обычный удаленный сервис с протоколом OpenAI API (/v1/chat/completions).
Шлюз на базе Kubernetes Gateway API принимает входящий запрос к модели qwen, сверяет текущую длину очередей на бэкендах vLLM и перенаправляет поток токенов на наименее загруженный под. Если одна из площадок внезапно теряет питание или облачный провайдер отзывает спотовый сервер, контроллер Crossplane моментально переносит нагрузку на резервный кластер без разрыва активных клиентских сессий.
В связке с инженерными практиками построения отказоустойчивых агентных систем, о которых мы подробно рассказывали в руководстве по инженерии ИИ-агентов, такой подход позволяет не переписывать код бэкенда при смене поставщика вычислительных мощностей.
При настройке очередей в Modelplane используйте масштабирование KEDA по метрике vllm_num_requests_waiting. Масштабирование по классической загрузке CPU или памяти GPU бесполезно: движки инференса аллоцируют 90% VRAM под KV-кэш сразу при старте, поэтому реальным маркером перегрузки служит именно размер очереди непринятых промптов.
Инженерные компромиссы и сетевой оверхед
Было бы ошибкой считать Modelplane волшебной серебряной пулей, решающей проблемы распределенных систем бесплатно. За универсальную абстракцию приходится платить инженерными компромиссами.
Главный вызов — сетевая связность. Чтобы поды инференса в разных облаках могли безопасно обмениваться трафиком и подтягивать тяжелые веса моделей из общего реестра, поверх площадок требуется натягивать оверлейную сеть (WireGuard, Cilium ClusterMesh или Cloudflare Magic WAN). Передача весов 70-миллиардной модели объемом в 140 гигабайт через публичный интернет занимает ощутимое время, поэтому кэширование артефактов на локальных NVMe-накопителях узлов остается обязательным условием.
Тем не менее, для зрелых платформенных команд подход Ника Коупа задает новый стандарт: вместо раздувания зоопарка одноразовых bash-скриптов мы получаем чистую декларативную архитектуру, масштабируемую по нативным правилам Kubernetes.