Edición 18 de octubreDigest del día · 10 materiales
Qué hay en esta ediciónRevisamos 36 fuentes, reunimos 10 materiales
Diorama en miniatura de un puesto de trabajo de ingeniería: transición de teclear sintaxis a mano a un entorno modular de pruebas y orquestación de agentes de IA.
A fondoIADesarrolloAgentes de IACarrera

De la sintaxis manual a la supervisión arquitectónica: cómo cambia la profesión de ingeniero en la era de los agentes de IA

A primera vista, si los agentes de código escriben sintaxis en segundos, la habilidad clave del desarrollador debería ser redactar especificaciones gigantescas. Pero en la práctica, intentar dejar todos los requisitos cerrados de antemano desemboca en una cadena interminable de regresiones y alucinaciones del modelo. Matt Pocock escribió código a mano durante diez años, hoy ha pasado por completo a orquestar agentes y demuestra que el foco se ha movido de los prompts a la limpieza del entorno de ingeniería. La fiabilidad real no nace de pliegos monumentales, sino de una red de pruebas impenetrable, la gestión de riesgos ocultos mediante entrevistas cruzadas y una escalera gradual de confianza hacia los procesos autónomos.
👍 0
Nate HerkMatt Pocock Skills RepositoryAI Hero - Real AI Engineering Platform
18 de octubre
Bodegón 3D fotorrealista con módulos translúcidos flotantes de una aplicación web y cálculos de la arquitectura Gemini 4 Argon.
ArtículoIADesarrolloAutomatizaciónLLM

Gemini 4 Argon en la práctica: generación autónoma de aplicaciones web complejas y decodificación de contexto largo

«¿De verdad un búfer de salida de un millón de tokens es una herramienta real y no otro escaparate sintético de benchmarks?». Esa es la pregunta que se hace cualquiera que haya chocado alguna vez contra el límite duro de generación al intentar montar un proyecto complejo. El experimento independiente de Matthew Berman con el nuevo Gemini 4 Argon despeja todas las dudas: gracias a la arquitectura Long Decode y a saltos paso a paso de 64 000 tokens, el modelo construyó de forma autónoma en 20 minutos un clon web funcional de Excel con recálculo dinámico de fórmulas sin intervención humana. Pasamos de pegar snippets sueltos a ensamblar sistemas completos de forma autónoma, donde el valor del desarrollador se desplaza definitivamente de la sintaxis al control sistémico.

👍 0
Matthew BermanJulian Goldie SEOGoogle DeepMind Gemini 4 Argon AnnouncementGoogle AI for Developers - Gemini 4 Argon Documentation
18 de octubre
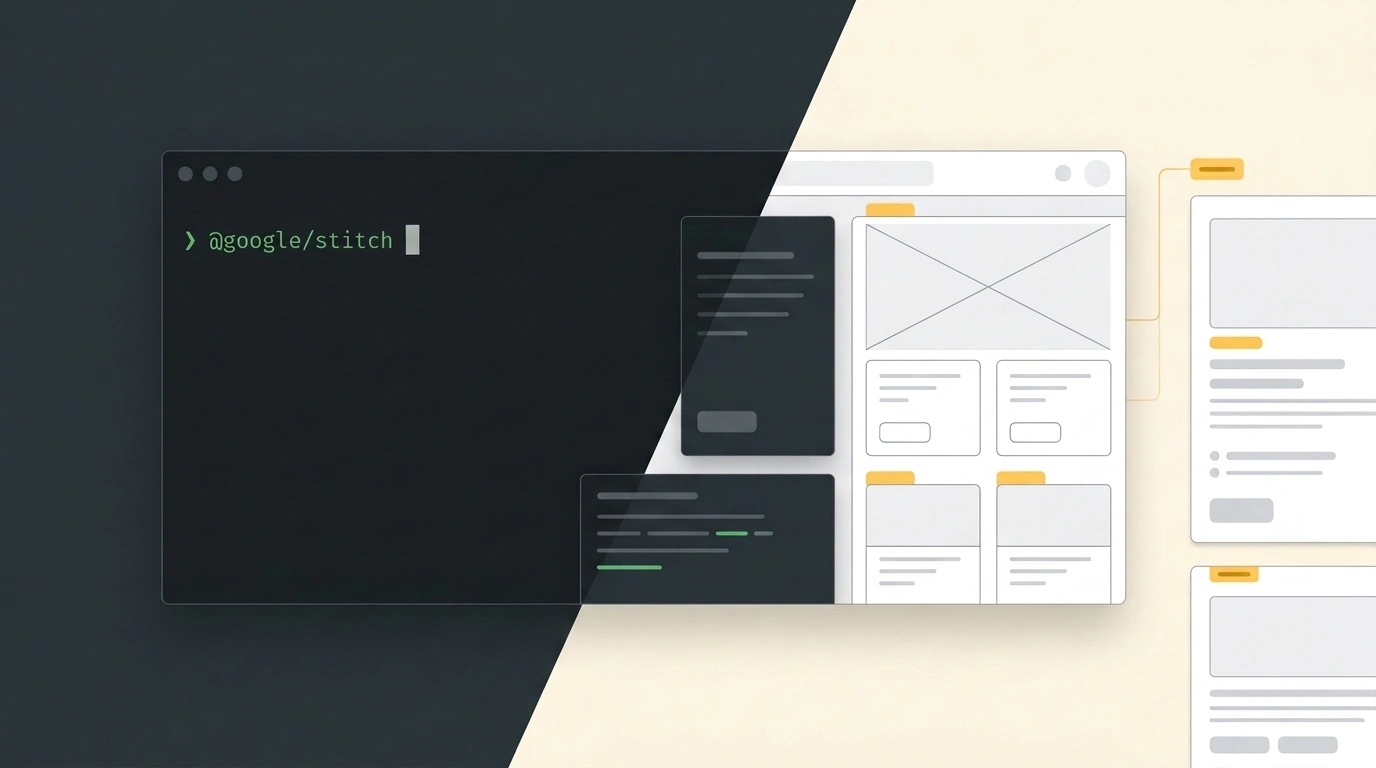
Pantalla dividida conceptual al estilo de un póster moderno que une la consola negra de Stitch CLI con una maqueta limpia de interfaz web.
ArtículoDiseñoDesarrolloAgentes de IAAutomatización

Stitch CLI: generación y edición visual de interfaces web directamente desde la terminal del agente de código

Saltar sin parar entre el navegador, los editores gráficos y la terminal siempre fue la parte más pesada de la maquetación: copiar un bloque de marcado, pegarlo en el editor, lanzar la compilación, descubrir estilos descuadrados y volver a empezar. La utilidad Stitch CLI de Google Labs elimina esa fricción integrando el diseño generativo directamente en la consola del agente de código. Ahora el agente asume de forma autónoma la rutina de la interfaz:

  • Despliega la estructura adaptable de la página en HTML y Tailwind a partir de una breve descripción;
  • Genera varias variantes de distribución de bloques a la vez para elegir rápido en lo visual;
  • Toma una captura de la aplicación en marcha y sincroniza los ajustes con limpieza en la base de código. No te configurará el backend, pero te ahorra horas de pelea manual con estilos y diseño adaptable.
👍 0
Julian Goldie SEOStitch CLI npm PackageGoogle Labs Stitch Overview
18 de octubre
Noticias · 18 de octubre4 noticias

Lanzamiento de DeepSeek V4.1-Flash-1017: optimización de Pareto en los pesos y aceleración de la inferencia

El equipo de DeepSeek ha publicado el checkpoint optimizado V4.1-Flash-1017 bajo licencia libre MIT. El entrenamiento adicional recortó la verborrea innecesaria y aceleró la inferencia en 11 benchmarks de programación y tareas en terminal sin tocar las tarifas de la API, haciendo aún más accesible el despliegue de pipelines agénticos.

MiniCPM-V 4.7: ejecutar un modelo multimodal de 35 000 millones de parámetros en 3 GB de memoria

El equipo de OpenBMB y el laboratorio THUNLP han lanzado el modelo multimodal abierto MiniCPM-V 4.7 bajo licencia libre Apache 2.0. El algoritmo de precarga anticipada de expertos LES permite ejecutar una arquitectura MoE de 35 000 millones de parámetros en smartphones consumiendo apenas unos 3 GB de memoria RAM.

ChatGPT Space: un espacio de trabajo unificado para documentos colaborativos y agentes

OpenAI presentó el espacio de trabajo ChatGPT Space con páginas vivas (Pages). Los equipos pueden editar documentos en tiempo real, invocar agentes autónomos Dots mediante menciones contextuales dentro del propio texto y sincronizar el contexto sin pérdidas entre chats y repositorios.

Meta Muse Wonder: modelos con memoria integrada y retención del contexto de la tarea

Meta Superintelligence Labs presentó los modelos Muse Wonder y Muse Wonder Full. Sus módulos integrados Active Memory y Active Focus libran a los agentes de la amnesia digital entre sesiones y evitan la pérdida de objetivo en cadenas largas de tareas, conservando el contexto de los proyectos sin necesidad de capas RAG externas.

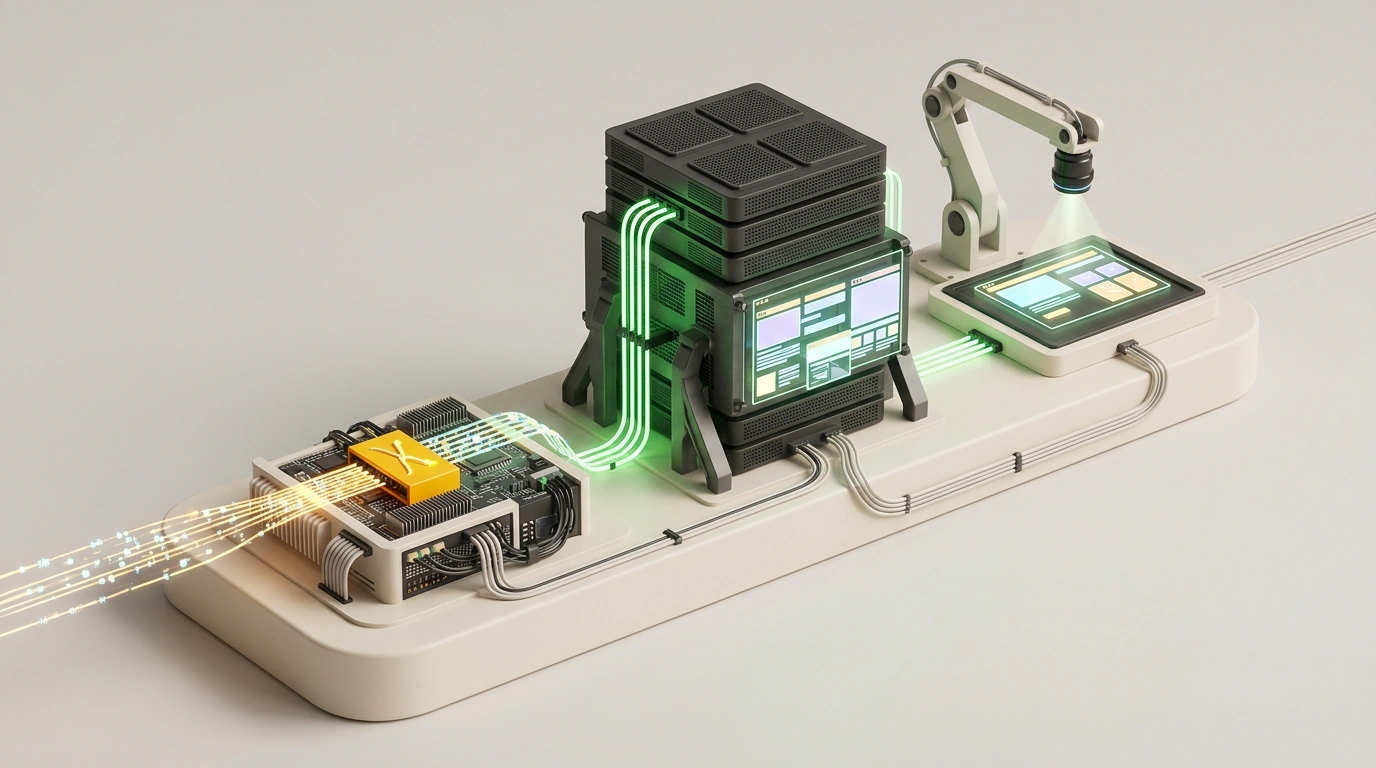
Cadena de montaje isométrica formada por tres bloques MoE especializados para enrutamiento, generación y auditoría visual.
Resumen temático3 seccionesIAOpen SourceLLMAgentes de IA

Modelos MoE abiertos especializados: del enrutamiento preciso al análisis visual

Encargarle a una sola red neuronal pesada y generalista todas las tareas seguidas —desde clasificar eventos al vuelo hasta maquetar páginas web complejas— dispara inevitablemente la factura de la API y la latencia de respuesta. El ecosistema de modelos abiertos demuestra con claridad las ventajas de dividir el trabajo: el gigante Ling-3.1-Flash de 560 000 millones de parámetros asume la síntesis de interfaces voluminosas, el compacto Drex 2.0 enruta decisiones discretas en milisegundos sin rodeos y el híbrido Nemotron 3.5 Super VL inspecciona capturas de pantalla y documentos PDF. Combinar tres expertos MoE especializados resulta más rápido, barato y estable que cualquier monolito pesado.

👍 0
Julian Goldie SEO - Ling-3.1-FlashLing-3.1-Flash on Hugging FaceNACE AI Platform for Drex Decision Models
18 de octubre
Bodegón surrealista con un desvío ferroviario histórico del siglo XIX y un monumental clúster de computación.
ArtículoIAAnalíticaEstrategiaInfonegocios

¿Ilusión o revolución de infraestructura?: análisis del escepticismo de fondo en torno a la IA

La mayor trampa del escepticismo tecnológico es confundir la euforia especulativa de los fondos de capital riesgo con la utilidad real de la herramienta. Quienes afirman que las redes neuronales solo pegan palabras ajenas de forma mecánica ignoran los hechos: los sistemas de DeepMind ya logran medallas de plata en la Olimpiada Internacional de Matemáticas generando demostraciones formales rigurosas de problemas inéditos. El emprendedor Nick Saraev compara el ruido actual de la IA con la fiebre ferroviaria del siglo XIX: la espuma financiera alrededor de startups vacías bajará, pero la infraestructura construida de centros de datos y modelos base permanecerá. Y 50 millones de suscriptores de pago de ChatGPT votan cada día con su propia cartera a favor del ahorro real de tiempo.

👍 0
Nick SaraevGoogle DeepMind IMO Math Reasoning MilestoneOpenAI Product Milestones
18 de octubre