Seguro que has notado lo rápido que se dispara la factura de la API cuando le encargas a un único modelo gigante absolutamente todo, desde clasificar correos triviales hasta maquetar interfaces complejas. Mover un peso pesado de más de 500 000 millones de parámetros para responder un simple «sí» o «no» es como llamar a un camión minero para ir a por un cartón de leche a la esquina.
La industria de la inteligencia artificial abierta ha encontrado un camino mucho más sensato: la división del trabajo. En vez de un único modelo torpe para cualquier escenario, los arquitectos montan equipos de agentes con expertos especializados Mixture-of-Experts (MoE). Ya estudiamos la arquitectura de Ling 3.1 Flash de 560 000 millones de parámetros y analizamos las capacidades del modelo abierto NVIDIA Nemotron 3.5 Super VL para revisar interfaces.
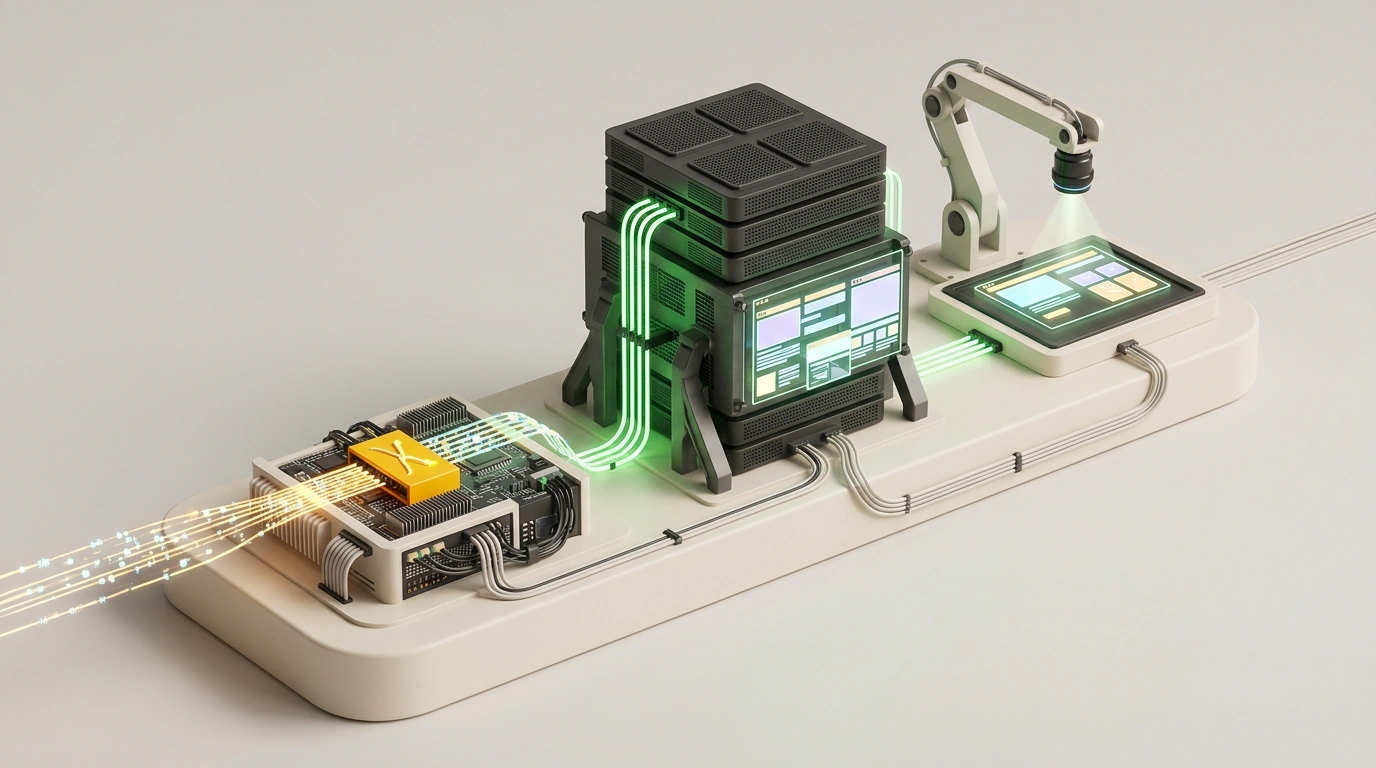
En el repaso de hoy comparamos tres lanzamientos abiertos recientes del otoño de 2026 que cubren tres fases muy distintas de un pipeline agéntico: maquetación pesada, enrutamiento ultrarrápido y verificación visual.
Ling-3.1-Flash
560 000 millones de parámetros y generación de páginas web
Cuando un agente necesita generar una estructura multipágina compleja o abordar una refactorización profunda de todo un módulo, los modelos ligeros se ahogan enseguida. Ahí entra en escena Ling-3.1-Flash, del laboratorio chino InclusionAI (Ant Group).
El modelo suma la friolera de 560 000 millones de parámetros totales, pero gracias a su arquitectura MoE dispersa solo activa 25 000 millones por cada token. Eso le permite mantener un buen equilibrio entre comprensión profunda de relaciones y velocidad razonable de generación.
Sus rasgos clave:
- Ventana de contexto de 1 millón de tokens: puede digerir toda la base de código de un proyecto mediano o una especificación técnica masiva (en servicios en la nube el límite es de 256K tokens).
- Licencia libre MIT: los pesos están publicados en abierto en Hugging Face en formato BF16 y en versión cuantizada FP8 E4M3.
- Exigencia de hardware: el tamaño total de los pesos alcanza los 574 GB, así que para desplegarlo en local hace falta un clúster de servidores del nivel de 8x H100 o A100.
Es una auténtica «excavadora pesada» especializada en sintetizar páginas web completas y bloques arquitectónicos de gran escala.
Drex 2.0
Enrutamiento MoE para decisiones discretas al instante
¿Y qué hacemos en el punto en que el agente no necesita redactar prosa, sino decidir en fracciones de segundo por qué rama del flujo seguir? Usar Ling o Claude ahí es tirar el dinero.
Para ese trabajo, el equipo de NACE.AI presentó Drex 2.0 (drex-v2.0). Está entrenado sobre la arquitectura QEN 3.6 (35 000 millones de parámetros, con solo 3 000 millones activos) con un objetivo muy concreto: cortar de raíz cualquier verborrea y devolver un vector probabilístico de decisiones.
En lugar de generar un razonamiento largo de 500 tokens, Drex 2.0 evalúa el evento entrante en milisegundos y devuelve una puntuación exacta sobre la lista de acciones definida (por ejemplo, en el triaje de leads: «agendar llamada», «enviar documentación», «pedir detalle de presupuesto»):
- Es un 38% más rápido que la versión anterior 1.5 en contextos de entre 32K y 128K tokens;
- Alcanza un AUC de 0.984 en clasificación de mensajes y un 96.3% de precisión en modo zero-shot en el benchmark DecideBench;
- Elimina el riesgo de alucinaciones en las bifurcaciones lógicas al emitir probabilidades discretas estrictas.
Nemotron 3.5 Super VL
Inspector visual multimodal para agentes
El último eslabón de la cadena es el control de calidad. El agente ya generó la página o la interfaz, pero ¿cómo compruebas que el diseño no se ha descuadrado y que ningún banner emergente tapa el botón de pago?
La respuesta de NVIDIA es Nemotron 3.5 Super VL, publicado bajo licencia abierta OpenMDW v1.1. Es un modelo híbrido de 120 000 millones de parámetros (12 000 millones activos por token) que combina capas lineales Mamba-2, estructura MoE y el codificador visual especializado C-RADIO.
El modelo está entrenado de forma nativa para operar dentro de bucles agénticos (en concreto, junto a Hermes Agent y el entorno OpenCode). Interpreta capturas de pantalla, esquemas complejos, diagramas e informes PDF multipágina. En pruebas de estrés para detectar defectos de maquetación y contrastar la interfaz con el diseño original, Nemotron 3.5 Super VL superó a alternativas cerradas más pesadas de la propia NVIDIA, y sigue pudiendo desplegarse en local con vLLM y SGLang.
Síntesis: divide y vencerás
Comparar estas tres piezas deja muy claro hacia dónde va la arquitectura práctica de la IA:
- Drex 2.0 se encarga del triaje instantáneo de eventos y del enrutamiento del pipeline por céntimos;
- Ling-3.1-Flash entra en acción cuando toca sintetizar páginas web voluminosas y código complejo;
- Nemotron 3.5 Super VL audita el resultado visual con una captura en el navegador antes del commit.
Combinar modelos MoE muy especializados resulta varias veces más barato, rápido y estable que intentar cargar todas las fases del trabajo sobre una sola red neuronal monolítica mastodóntica.