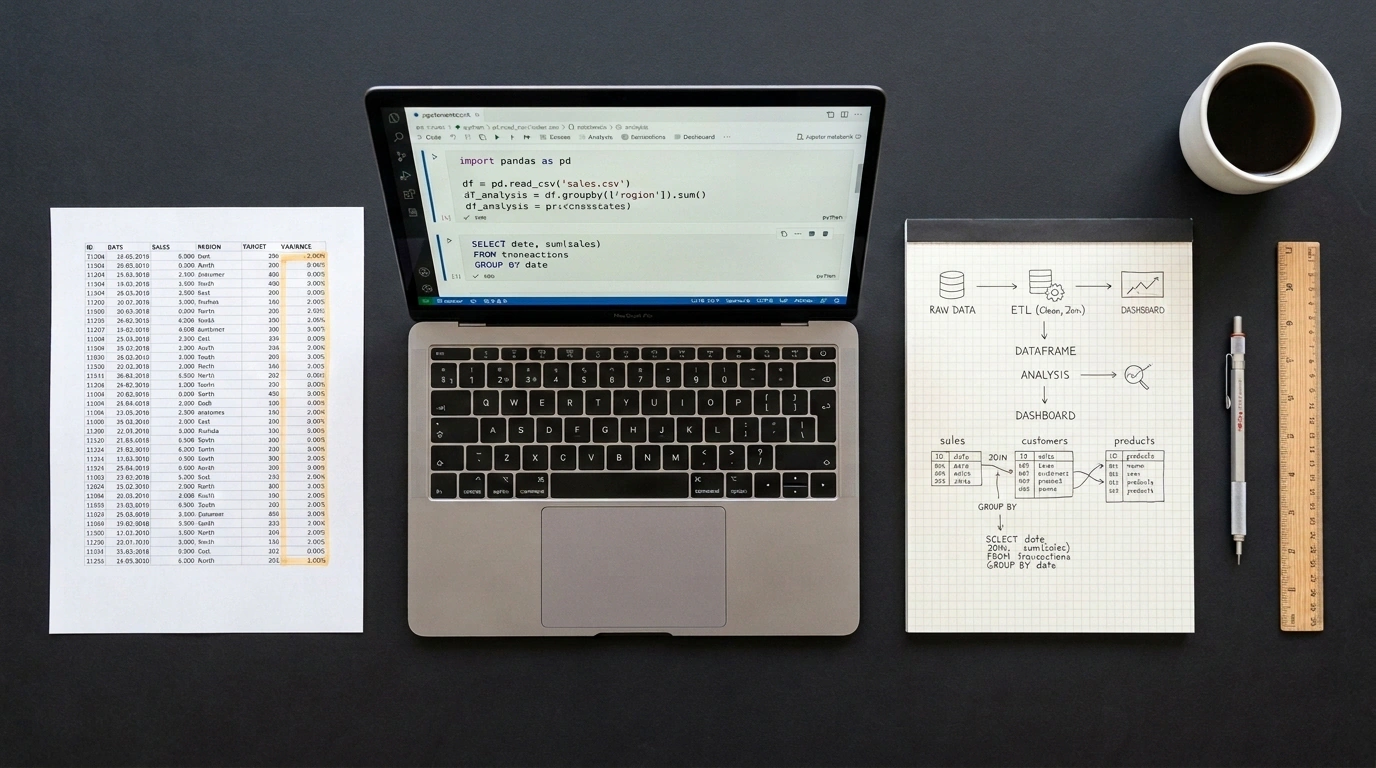
Casi cualquier ingeniero o analista ha pasado por esta evolución. Al principio todo va como la seda: abres Excel, montas un par de columnas, sacas una tabla dinámica y mandas el informe a dirección. Pero el negocio crece, la exportación pasa de las 300 000 filas, las fórmulas VLOOKUP hacen despegar los ventiladores del portátil y el límite estricto de 1 048 576 filas amenaza con cortarte los datos nuevos.
En ese punto aparece el vértigo: parece que pasar al código exige cambiar por completo tu forma de pensar. En realidad es un espejismo. La lógica de trabajar con datos es exactamente la misma: filtrar filas, agrupar sumando totales o cruzar dos listas por una clave común funciona igual en todas partes. Solo cambia la sintaxis de la fachada.
Hace tiempo ya vimos cómo funciona el pipeline lógico de ejecución de SQL SELECT. Hoy vamos a poner frente a frente las operaciones habituales de Excel con su equivalente en SQL declarativo y en la librería pandas de Python.
Mapa de equivalencias: de los clics de ratón a las líneas de código
Desglosemos las cuatro operaciones básicas en los tres entornos:
- Filtrado de filas:
- En Excel: autofiltro en la cabecera o fórmula
=FILTER(A2:D100, B2:B100 > 5000). - En SQL: predicado de filtrado en la cláusula
WHERE revenue > 5000. - En pandas: indexación booleana
df[df['revenue'] > 5000]o el métododf.query('revenue > 5000').
- En Excel: autofiltro en la cabecera o fórmula
- Ordenación:
- En Excel: botón de ordenar de la Z a la A.
- En SQL:
ORDER BY revenue DESC. - En pandas:
df.sort_values(by='revenue', ascending=False).
- Cruce de tablas (VLOOKUP / XLOOKUP):
- En Excel: fórmula
=XLOOKUP(id, lookup_range, return_range). - En SQL: unión de tablas con
LEFT JOIN customers ON orders.customer_id = customers.id. - En pandas: método
df.merge(orders, on='id', how='left').
- En Excel: fórmula
- Tratamiento de nulos (celdas vacías):
- En Excel: sustituir celdas vacías por ceros con
=IF(ISBLANK(A2), 0, A2). - En SQL: función
COALESCE(revenue, 0). - En pandas: método vectorizado
df['revenue'].fillna(0).
- En Excel: sustituir celdas vacías por ceros con
Comparativa práctica en código
Imagina este caso: tenemos una tabla de clientes y otra de pedidos. Queremos quedarnos con los usuarios activos de Londres con ingresos superiores a 5000, añadir una columna calculada con un recargo del 10 %, cruzarlo con los pedidos y calcular el importe total por región.
Así se expresa esa lógica en SQL declarativo:
-- SQL: filtrado, campo calculado, unión de tablas y agrupación
SELECT
    c.region,
    COUNT(o.order_id) AS total_orders,
    COALESCE(SUM(o.amount), 0) AS total_amount
FROM customers c
LEFT JOIN orders o ON c.id = o.customer_id
WHERE c.region = 'London' AND c.revenue > 5000
GROUP BY c.region
ORDER BY total_amount DESC;
Y exactamente el mismo flujo lógico escrito en Python con pandas:
import pandas as pd

# Cargamos los conjuntos de datos desde archivos
customers = pd.read_csv('customers.csv')
orders = pd.read_csv('orders.csv')

# 1. Filtrado y creación de columna calculada
filtered = customers[
    (customers['region'] == 'London') & (customers['revenue'] > 5000)
].copy()
filtered['revenue_uplift'] = filtered['revenue'] * 1.1

# 2. Unión de tablas (equivalente a LEFT JOIN / VLOOKUP)
merged = filtered.merge(orders, left_on='id', right_on='customer_id', how='left')

# 3. Tratamiento de valores ausentes (equivalente a COALESCE)
merged['amount'] = merged['amount'].fillna(0)

# 4. Agrupación y cálculo de agregados (Tabla dinámica / GROUP BY)
summary = (
    merged.groupby('region', as_index=False)
    .agg(
        total_orders=('order_id', 'count'),
        total_amount=('amount', 'sum')
    )
    .sort_values(by='total_amount', ascending=False)
)

print(summary)
La librería pandas carga todos los datos en memoria RAM como arrays de NumPy. Por la sobrecarga de los objetos de Python, un CSV de 5 GB puede pedir hasta 25 GB de RAM y caer con MemoryError. Si tu dataset ya no cabe en memoria, échale un ojo a DuckDB, una base de datos analítica embebida. Te permite escribir SQL puro directamente sobre archivos CSV y Parquet procesándolos en streaming desde disco sin desbordar la RAM.
La mayor ventaja de saltar de Excel al código es la reproducibilidad total. Un script no se olvida de arrastrar una fórmula hasta la última celda, no desordena filas por un clic accidental y puede ejecutarse cada noche de forma automática para devolverte tiempo para tareas de ingeniería más interesantes.